
黑粉科技 · 实测记录
黑粉科技 · 全部文章
第 4 / 7 页 · 每页 21 篇。 精彩依旧继续,我们等待着您。
返回首页 →
AI寒冬有2次,为什么2012年才翻身?显卡、数据和一场比赛的故事
1958年,人们已经在期待会学习的机器。几十年后它才真正改变行业。中间不是一条直线上升的曲线,而是承诺、失望,以及老想法终于等到条件的故事。
阅读全文


Embedding相似就答对了?3个词、一个向量空间和知识库的误会
猫和狗像,猫和内阁不像。把这种直觉放进数字里,词语就有了距离;可“允许商用”和“不允许商用”也可能挨得很近。相关资料,不等于正确答案。
阅读全文
GPT-2曾被嫌太危险,6年后又开放权重?一条下载链接背后的AI赛跑
普通人能在自己电脑上运行AI,并不是从天上掉下来的福利。分阶段发布、研究许可、开放引擎与下载链接,把同一场技术竞争分成了两条跑道。
阅读全文
Transformer能看128K就记得住?2017年的论文和QKV的3个误区
一站一站传话,和随时查找前文,是两种不同的组织方式。2017年的论文改变了语言模型,但它没有送给机器一份永不遗忘的记忆。
阅读全文

黑粉录屏:东半球最好的录屏软件,录屏剪辑一体化,自动化 AI 剪辑
录完直接剪,一句话交给 AI:28 分钟原始录屏剪掉 8 分钟,导出前的体检查出没打码的密钥;368 个原生动画,17 个平台的关注卡在动画里切。没做到的也写在里面。
阅读全文
LTX-2.5,本地免费跑,效果比肩大片
LocalBrain 1.4.8 接进第二个本地视频引擎 LTX-2.5:写一句带引号的台词,画面里的人会说出来。64GB 的 M5 Pro 上 4 秒 1024×576 约 2 分钟、峰值 25GB,运行时默认参数本来要 54GB;43.4GB 权重国内经 ModelScope 直连,发现页一键下载。
阅读全文
Mac、Windows、Linux,谁才是 AI 时代的主力机?
同样是 AI 电脑,Mac 买共享内存和低维护,Windows 买兼容与显卡选择,Linux 买生产栈;加入 9 月 28 日官方现货价后,答案更具体。
阅读全文


Qwen-Image-2.1:卡三次才出图
31 GiB 权重,M5 Pro 上 20 步 69 秒;中文书法写对四字。接入 LocalBrain 踩中三处陷阱;第二轮换人像重测官方那三条,发现「商品保真」其实是道尺寸题。
阅读全文
号称快一倍的 Mac 本地引擎,我测出中文只快 44%
Splash 在我的 M5 Pro 上把 Qwen3.8-27B 的代码生成跑到 79.3 tok/s,比同权重的朴素 MLX 快 5.11 倍;换成中文写稿只剩 1.44 倍。差别不在引擎,在草稿模型的接受率——代码 63.2%,中文 11.9%。
阅读全文

Ternary Bonsai 2 27B 上 Mac:6GB 跑 27B Reasoning,路径、命令与坑
PrismML 把 27B reasoning 压到 5.93 GB、M5 Pro 跑出 27.7 tok/s,还留 98.2% 的 Qwen3.8 原始能力。两条部署路径的命令、踩坑和接下来在 LocalBrain 里实测的计划,一次写清楚。
阅读全文
黑粉录屏:录屏、剪辑与 AI 动画制作,1.9.5 更新
1.9.5 恢复 macOS 菜单栏摄像头视频效果控制中心图标(人像居中、背景模糊)并自动记住麦克风、系统声音与摄像头开关,同时保持后台 MCP 接口零程序坞双图标、2.5D 连续运镜拖拽、原画导出分辨率与词级口播重复句清理。
阅读全文
本地 27B 模型能操作 Blender 吗?我把 B 站这套方法搬进 LocalBrain 跑了五轮
用本地 Qwen3.8-27B 通过 blender-mcp 建模的方法,再在 LocalBrain 里实测五轮:模型能一步步动手,但慢;交付的黑图只差一个勾选,看不见时它当成完成,能看最终渲染图以后才用对了修法。
阅读全文

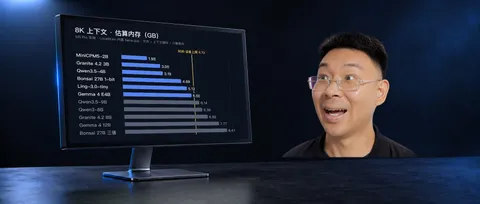
8GB 能跑哪些本地模型?我实测了 11 个,8K 上下文下 6 个装得下
把今年发布的 11 个低内存本地模型下到本机,用 LocalBrain 内置的 llama.cpp 统一量内存、速度和工具调用:8K 上下文下 6 个压在 8GB 设备的默认上限内,Qwen3.5-9B 比去年的 Qwen3-8B 少占 3 GB,1-bit 的 27B 能跑但质量只有厂商数字。这批模型也加进了 LocalBrain 的发现页。
阅读全文