摘要 LocalBrain 1.4.8 接进第二个本地视频引擎 LTX-2.5,写一句带引号的台词,画面里的人会把它说出来。64 GB 的 M5 Pro 上 4 秒视频约 2 分钟、峰值 25 GB;运行时默认参数本来要 54 GB。43.4 GB 的权重国内走 ModelScope 直连,发现页一键下载。 2026-09-30·黑粉科技
LTX-2.5,本地免费跑,效果比肩大片
9 月 29 日 23 点 15 分,我让 LTX-2.5 在 64 GB 的 M5 Pro 上生成一段 4 秒视频:咖啡馆窗边的女生看着镜头说 “Welcome back! Today we are testing a brand new video model.”。128 秒后片子出来,Whisper 转写出的台词和提示词引号里的一字不差。同一次生成,/usr/bin/time 记下的进程峰值是 54.0 GB——64 GB 的机器,为 4 秒视频吃掉 54 GB,这账明显不对。
先说结论:**LTX-2.5 能在 64 GB 的 Mac 上本地出带声音的视频,4 秒约 2 分钟;那 54 GB 不是模型要的,是运行时的两个默认值,改掉之后峰值 25.3 GB,耗时没变。**方寸智匣 LocalBrain 1.4.8 把它接成第二个本地视频引擎,发现页一键下载,国内走 ModelScope 直连。
▍LTX-2.5 是什么,和 H3 什么关系
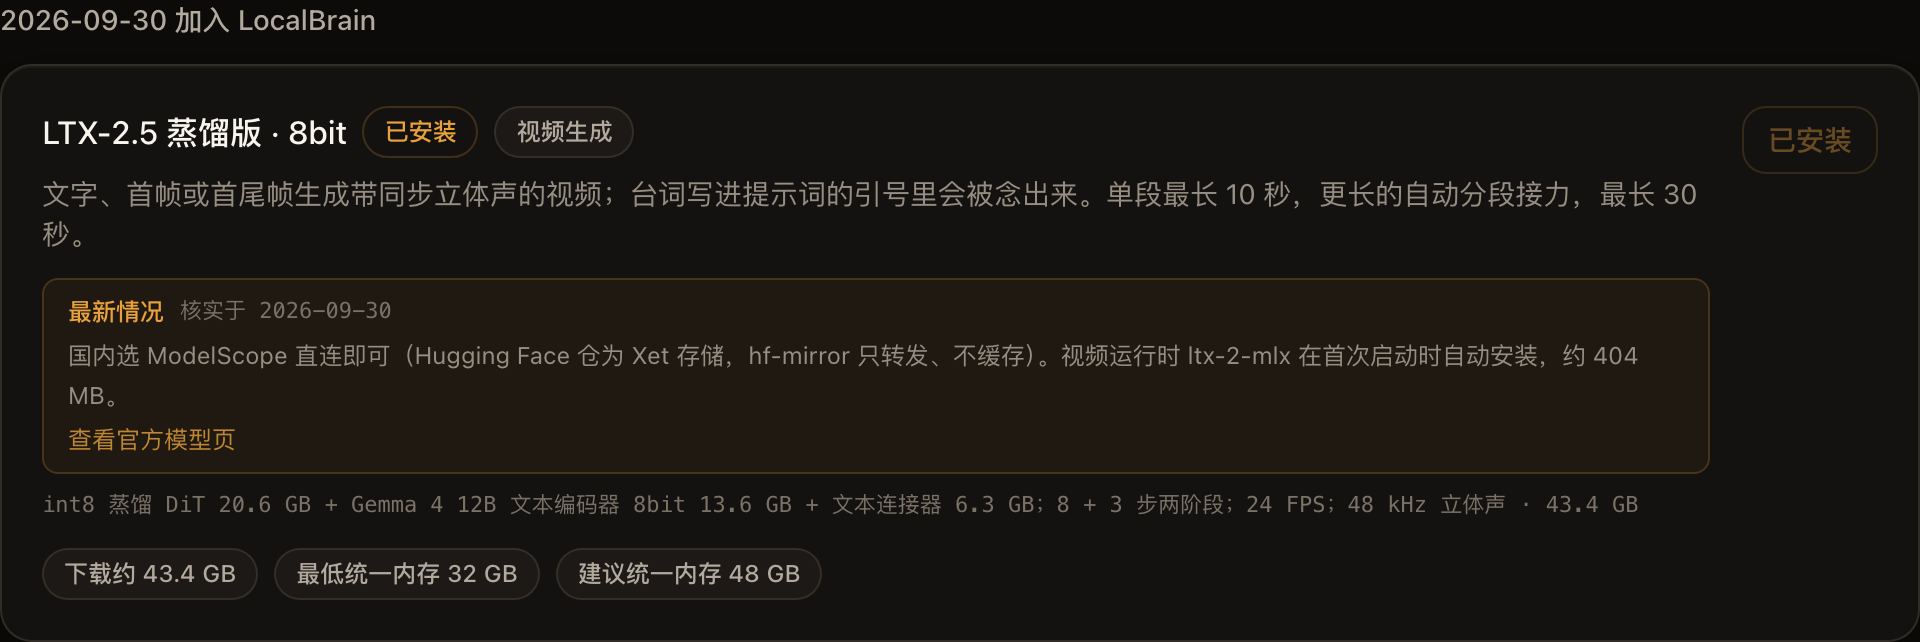
LTX-2.5 是 Lightricks 放出开放权重的音视频模型,画面和声音一起生成。本机跑的是 mlx-community 转好的 q8 蒸馏版,一共 43.4 GB。大头是 int8 的蒸馏 DiT 20.6 GB、Gemma 4 12B 文本编码器 8bit 13.6 GB 和文本连接器 6.3 GB,其余是视频和音频的解码器、声码器与空间放大器。
蒸馏版的意思是步数被压死了:先在半分辨率上采样 8 步,放大两倍后再精修 3 步,一共 11 步,没有步数可调,也没有 Turbo。输出固定 24 帧每秒,声音是 48 kHz 立体声。帧数必须是 8n+1,宽高必须是 64 的倍数——请求 480 高会回来 448,LocalBrain 会先按它能保住的尺寸吸附好再发。
LocalBrain 里原本已经有 MiniMax H3。两个引擎现在共用同一个视频面板,差别在能力和速度:
| LTX-2.5 q8 蒸馏版 | MiniMax H3 | |
|---|---|---|
| 能做什么 | 文生、首帧、首尾帧 | FL2VA:文生、首尾帧;REF2VA:最多 9 张参考图 |
| 声音 | 48 kHz 立体声,引号里的台词会说出来 | 32 kHz 立体声 |
| 模型包 | 43.4 GB | FL2VA 4bit 38.5 GB,REF2VA 8bit 64.5 GB |
| 3 秒「风景运镜」模板 | 98 秒(1024×576) | 382 秒(960×544,REF2VA 完整 30 步) |
| 3 秒「让图片动起来」模板 | 107 秒(576×1024) | 193 秒(544×960,FL2VA Turbo 4 步) |
表里的耗时都是同一台机器、同一条模板、各自的默认参数,分辨率和步数不同,只能说明「日常用起来谁更快」,不能当成两个模型的算力对比。
▍这次怎么测
机器是 MacBook Pro M5 Pro,64 GB 统一内存,macOS 26.7。耗时是墙钟秒数,含模型装载;内存看的是内核记下的进程物理占用峰值,和 /usr/bin/time -l 打印的 “peak memory footprint” 是同一个数,Metal 显存缓冲也算在里面。台词对不对用本地 Whisper large-v3-turbo 转写核对。
每个提示词只跑了一次,成片全部原样保留,没有挑。所以下面的结论能证明「能跑、多快、多占内存、这一次出了什么」,不能证明批量生成都这么稳。
▍实测:速度、画面和声音
| 片段 | 耗时 | 进程峰值 |
|---|---|---|
| 1024×576 · 4 秒说话人 | 126~130 秒 | 25.3 GB |
| 1024×576 · 3 秒文生模板 | 98 秒 | 25.4 GB |
| 576×1024 · 3 秒首帧 / 首尾帧模板 | 107 / 117 秒 | 28.0 / 28.5 GB |
| 1024×576 · 10 秒 | 354 秒 | 27.4 GB |
| 1024×576 · 20 秒,自动接力两段 | 745 秒 | 第一段 27.3 GB,第二段 36.8 GB |
| 经 MCP 冷启动出一段 4 秒 | 181 秒,含装载 | — |
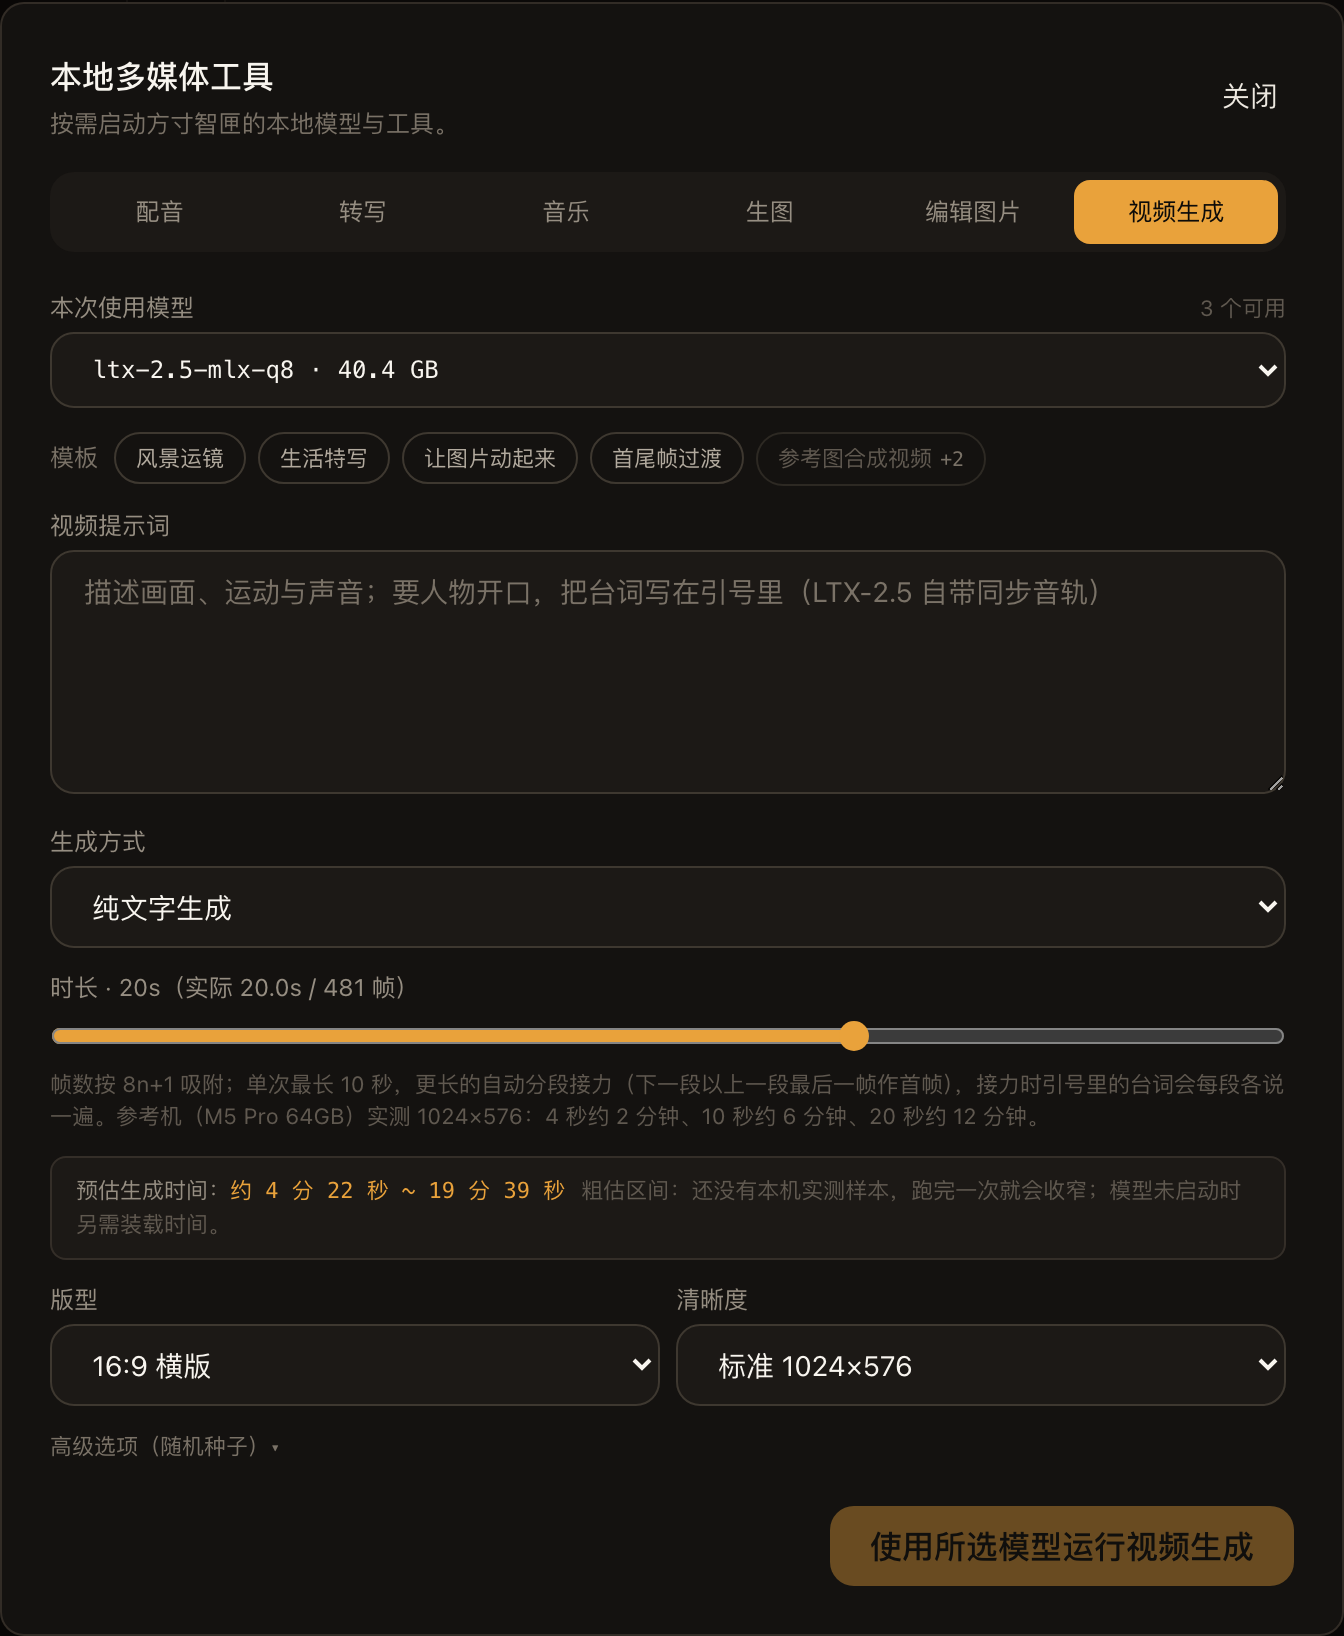
时长和耗时基本是线性的:4 秒 2 分钟,10 秒 6 分钟,20 秒 12 分钟出头。20 秒那条的内存要单独说,后面讲接力时再展开。
说话人那段是最让我意外的地方。画面里的人口型、表情和手势都跟着台词走,Whisper 转出来就是提示词里写的那句。换成 mlx-community 的文件以后,同一个种子又跑了一次:人物、构图和手势都一样,只是窗外的摩托车变成了停着的车;台词完整,但结尾多说了半句 “Welcome to…”。
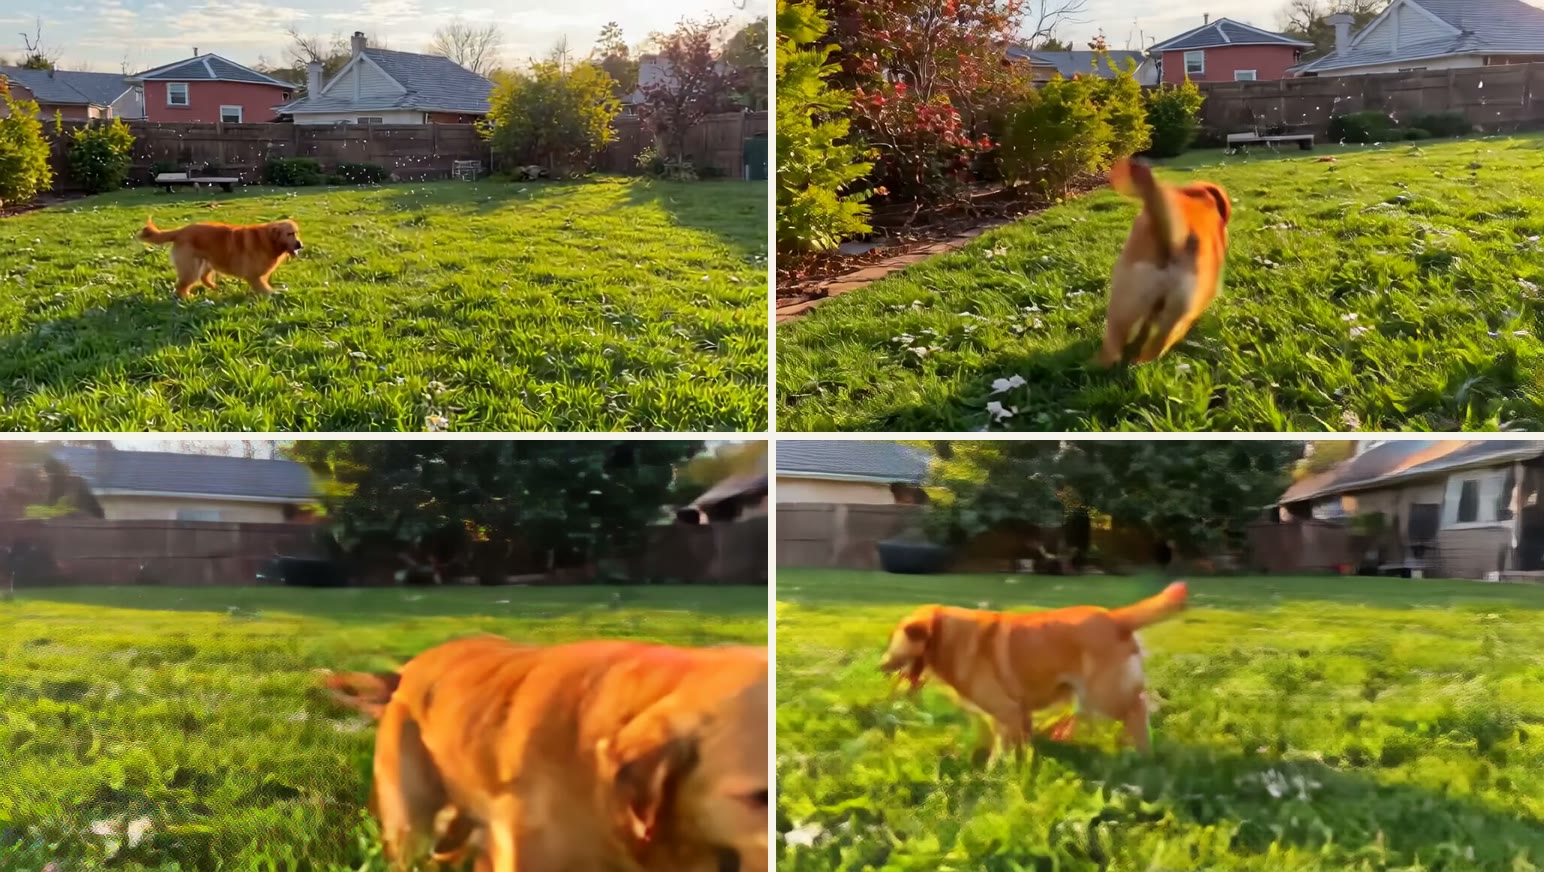
它也有很直观的毛病。10 秒的小狗追泡泡,后半段背景从红砖房漂成了另一栋米色房子,提示词里的肥皂泡基本没出现,小狗冲到镜头前那几帧糊成一团。4 秒的蒸汽火车,前半段蒸汽是从桥墩里冒出来的,和车头脱了节。片子越长,越容易「忘掉」开头的场景,这一点 10 秒的样本已经看得很清楚。
▍54 GB 从哪来
回到开头那个 54 GB。
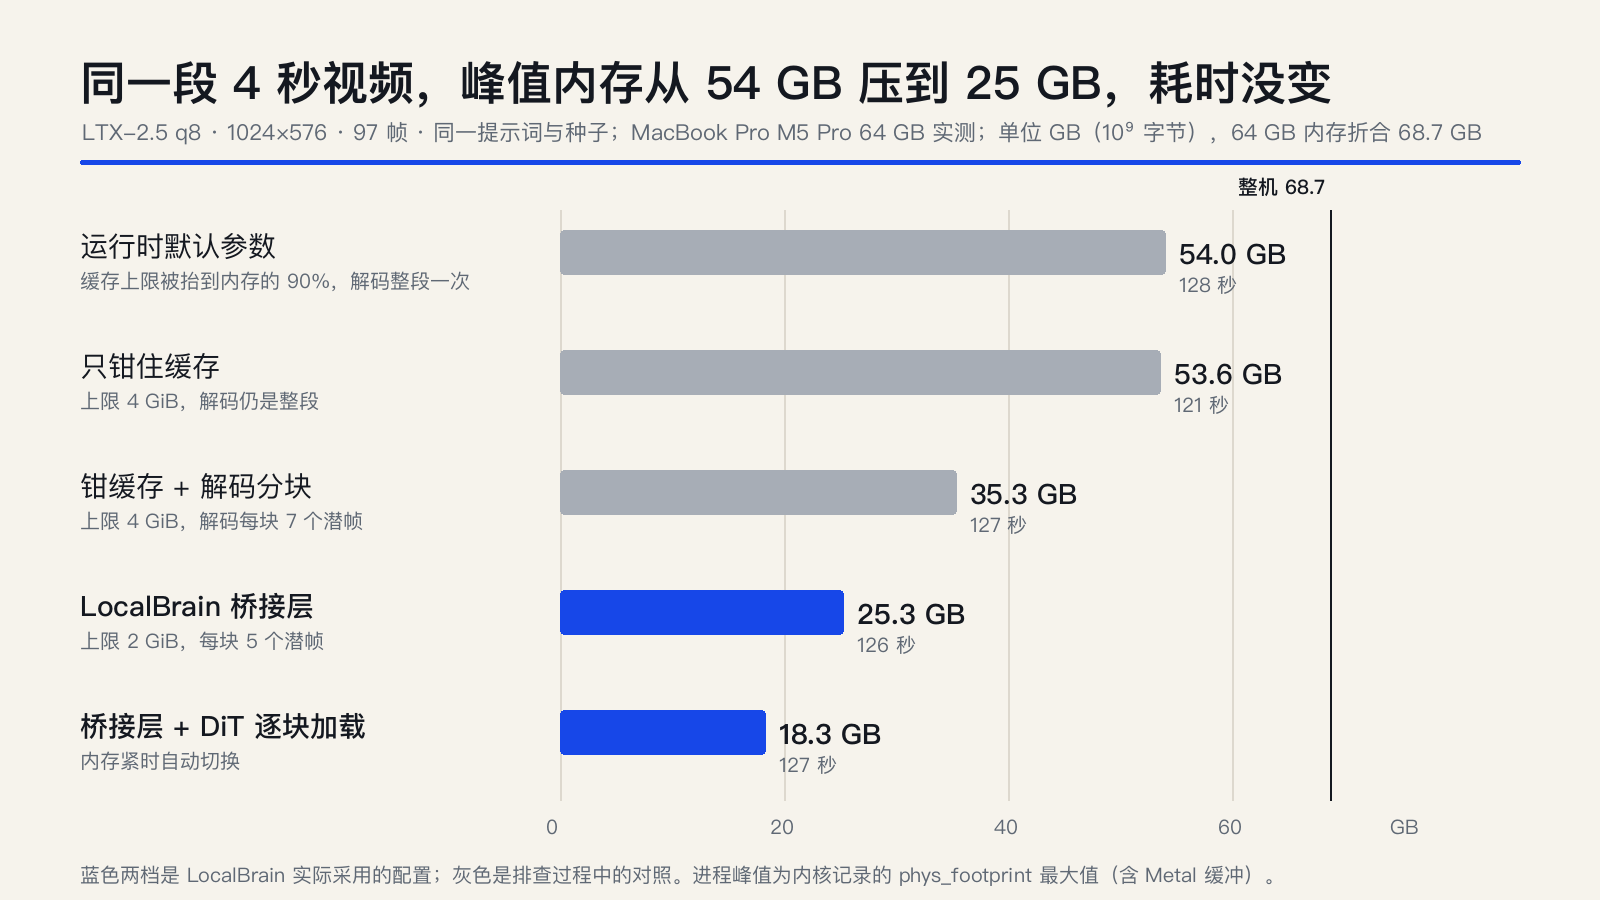
我在运行时里每 0.25 秒采一次 MLX 的内存,按阶段对齐以后发现,真正在用的最多只有 21.5 GiB,剩下三十多 GB 是两件事攒出来的:
第一,Gemma 编码器在编码提示词时,会把 MLX 的缓存上限抬到整机内存的 90%。释放掉的缓冲不还给系统,攒着备用,于是越跑越大;运行时自带的 --low-ram(把缓存上限设成 0)也因为被这一步覆盖,从来没生效过。
第二,解码从不分块。运行时估算解码要多少内存时,只按其中一层的张量算,比实测低了大约 40 倍,在默认 8 GB 预算下永远判定「放得下」,于是整段一次解码。
LocalBrain 的桥接层改了两处:把缓存上限钳在 2 GiB,之后谁再调都压回这个数;解码按每块 5 个潜帧切开。同一段视频,峰值从 54.0 GB 降到 25.3 GB,耗时 128 秒对 126 秒。分块解码和整段解码逐帧比,PSNR 平均 44.5 dB,最低 40.9 dB,块的边界上看不出接缝。
内存再紧时,桥接层会改成从磁盘逐块加载 DiT。旧的 4bit 编码器布局下,这样能压到 18.3 GB;现在发现页下载的是 8bit 编码器,编码提示词这一步就要约 25.5 GB,这成了下限。
▍国内下载:Xet 和 ModelScope
这个模型的 Hugging Face 仓是 Xet 存储。hf-mirror 对 Xet 文件只做 302 跳转,把请求转回境外,自己不缓存——不开代理,基本就下不动。
办法是换源。mlx-community 的这两个仓在 ModelScope 上有同名镜像。我把两边的文件清单逐个比过,只差 ModelScope 自带的 configuration.json 和 .gitattributes,所有大文件的 SHA-256 一模一样。9 月 30 日从 ModelScope 直连下载,19 个文件共 43.38 GB,aria2c 跑到每秒 44 MiB 左右,逐个文件对过 SHA-256。
发现页本来就能在 ModelScope、HF-Mirror 和 Hugging Face 之间测速选最快。这次顺手补了一个洞:ModelScope 的清单里其实给每个文件都列了 SHA-256,之前 LocalBrain 没读,从魔搭下的模型只比大小。1.4.8 起内容也核对,40 多 GB 的权重下坏了会当场报出来,不会等到生成时才莫名失败。
至于为什么是 q8:mlx-community 的模型卡写着,bf16 的 DiT 常驻约 38 GB,放在 64 GB 机器上要占掉 96% 的预算;int8 降到 57%。他们也做过 int4,没过自己的质量检查,就没有发。
▍文件一个字节都不改
LocalBrain 用的运行时是固定提交的 ltx-2-mlx,它原本按另一种目录布局写:文本编码器要放在 text_encoder/,DiT 里要有 96 个视频前馈层的偏置。mlx-community 的文件两样都对不上:编码器在 gemma4-12b-ltx-v1/,DiT 里没有这些偏置。
最省事的办法是下载完改文件,但那样文件的 SHA-256 就和上游对不上了,更新检查从此失效。我选了另一条路:文件保持原样,由一个兼容层在生成进程里打补丁——加载 DiT 时补上全零的偏置,找编码器时认 gemma4-12b-ltx-v1/。补零和原布局在数值上完全等价:9 月 29 日我实测过,原布局的 DiT 就是这一份再加 96 个全零张量,重建后 SHA-256 一致。
▍30 秒是怎么来的:接力
它单次最多生成 241 帧,也就是 10 秒。H3 的面板能拉到 30 秒,为了两个引擎用起来一样,超过 10 秒的请求由桥接层拆成几段:段数取最少,帧数尽量均分,下一段以上一段的最后一帧作首帧,拼接时去掉重叠的那一帧。
20 秒的海岸航拍就是两段各 10 秒接起来的。接缝落在第 240 到 241 帧之间,相邻两帧的平均差是 1.11,和前后 24 帧的中位数 1.10 一样,放大逐帧看也找不到跳变。声音差一点:接缝后 0.4 秒里比接缝前响了 3.35 dB,是整段里最大的一次起伏,随后回落。
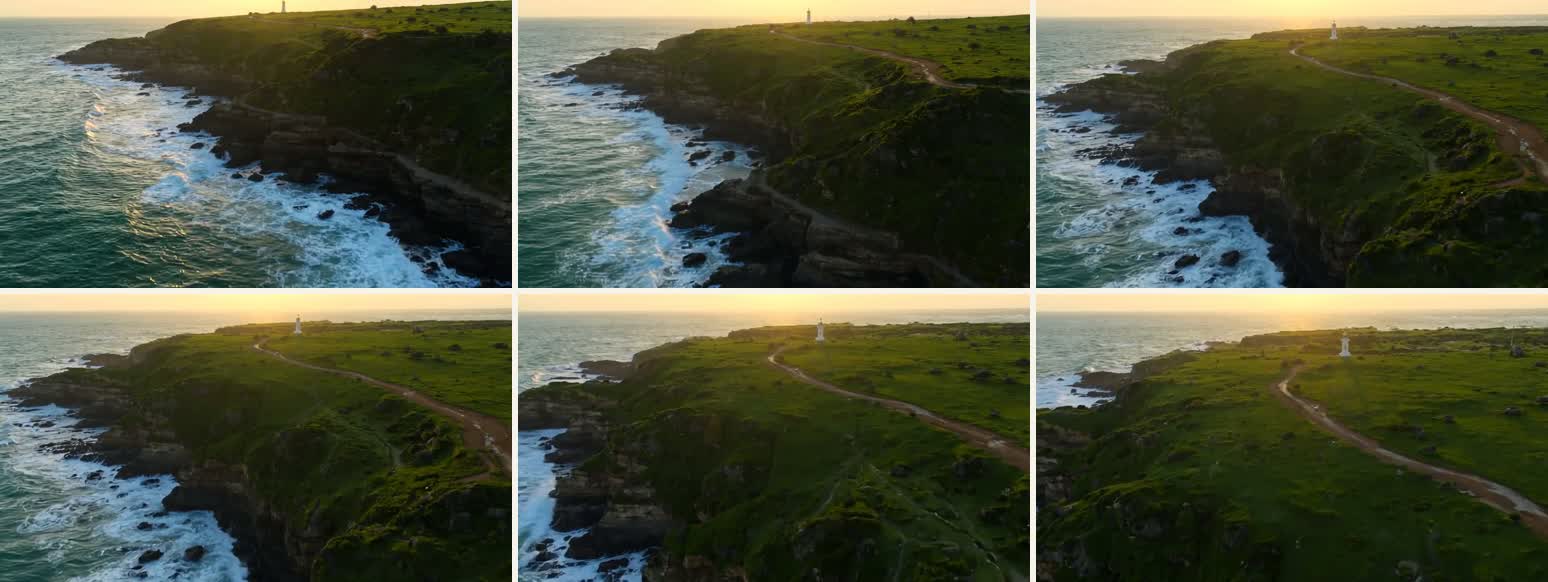
这一条还让我抓到了一个内存模型的漏洞。第一段峰值 27.3 GB,第二段 36.8 GB,多出 9.5 GB,而桥接层原本只预测了 26.6 GiB。原因在首帧:带首帧(或尾帧)生成时,运行时给每个 token 一个去噪掩码,DiT 的时间步调制因此变成每个 token 一份。3 秒的首帧模板同样多出 2.65 GB。1.4.8 把这一项算了进去,并按每一段是否带首帧分别估算;现在这套文件的六个实测点,预测都不低于实测,最多高出 1.4 GB。
接力也有一个用法上的坑:每一段用的是同一段提示词,所以引号里的台词会在每段各说一遍。要人物开口的片子,控制在 10 秒以内。
▍谁在付账,为什么现在做
这次接 LTX-2.5,最花时间的不是模型本身,而是两笔被别人默认下来的账。
第一笔是内存。运行时的两个默认值——缓存上限抬到 90%、解码不分块——放在大内存机器上无所谓,落到 64 GB 的 Mac 上就是 54 GB 峰值,别的模型都得给它让路。改掉它们不花一点速度,这笔账本来就不该由用户付。
第二笔是下载。Hugging Face 从 2025 年 5 月 23 日起,让新注册的用户和组织默认使用 Xet 存储:文件切成约 64 KB 的块去重,上传省流量,更新只传改动的部分,对平台和上传者都是实打实的节省。成本转嫁到了国内用户身上:hf-mirror 这类按整文件缓存的镜像接不住 Xet 的块,只能把请求转回境外。接住这部分流量的是 ModelScope,mlx-community 的仓在那边有同名镜像。谁在沉默?下载工具本身——卡在境外时,它不会告诉你为什么慢。
至于为什么现在做:Lightricks 在 8 月放出 LTX-2.5 的开放权重,同时经营收费的在线平台 LTX Studio 和托管 API。开放权重换生态和口碑,云端服务靠什么赚钱一目了然,这更像是开源模型公司的两条腿。我的理由更直接:同一条 3 秒模板,H3 的 REF2VA 要 382 秒,模型包 64.5 GB,我需要一个在 64 GB 机器上更快、还能说台词的本地引擎。LocalBrain 本身免费,靠自愿赞助。
▍毛病和边界
- 长片段会漂:10 秒后半段背景换了一栋房子,提示词里的次要元素(肥皂泡)可能直接没有。
- 声音大小不稳定:同样的桥接层,生成出来的原始响度从 −8.4 到 −43.8 LUFS 都有。LocalBrain 统一拉到 −16 LUFS,但特别轻的那条拉完也只有 −18.9 LUFS。
- 人脸只测了两位虚构人物,各一段,都是正脸、小动作。侧脸、大动作、多人同框稳不稳,这次不能证明。
- 32 GB 的 Mac 按规划够用(最低约 25.5 GB),但我手上没有 32 GB 的机器,没实测。
▍谁适合用、怎么上手
| 你想要 | 选 |
|---|---|
| 让画面里的人说指定台词 | LTX-2.5 |
| 3~10 秒、要快 | LTX-2.5 |
| 给一套人物、商品、场景的参考图,按图拍 | H3 REF2VA |
| 首尾帧定起止、中间让模型补 | 两个都行,LTX-2.5 更快 |
上手四步:在「发现」找到 LTX-2.5 蒸馏版 · 8bit,测速后国内选 ModelScope,下载 43.4 GB。然后在设置里把它选成视频模型。第一次启动时,LocalBrain 会自动装好它的运行时,约 404 MB。最后在对话页「工具 → 视频生成」里写提示词,或者先点一个模板。
有 64 GB 以上的 Apple Silicon、想让视频里的人按你写的台词开口、又不想把素材传上云的,值得装。只有 32 GB,或者要参考图一致性、要 2K 成片的,先别急着上头:前者我还没实测,后两样 LTX-2.5 这一版做不到。我的建议是先用模板跑一条 3 秒的,看速度和声音合不合意,再往长了拉。
摘要:64 GB 的 Mac 上,本地有声视频能用了,代价是时间和一点耐心 4 秒约 2 分钟、10 秒约 6 分钟、20 秒约 12 分钟,峰值内存 25~37 GB;台词写进引号能说出来,片子越长越容易漂。适合手上有 64 GB 以上 Apple Silicon、想让画面里的人按你写的台词开口、又不想把素材传上云的人。要参考图一致性、要 2K 成片,或者内存只有 32 GB 的,先别急着上头。
建议 下载页:https://github.com/HackerChi-Hub/localbrain-releases/releases 模型(ModelScope):https://modelscope.cn/models/mlx-community/ltx-2.5-mlx-q8 运行时:https://github.com/MrMoferFRAN/ltx-2-mlx
🧰 我做的工具
这些工具都由我持续维护。预览版会明确标注,下载、更新和已知边界以发行页为准。
信息:黑粉盒子 HyphenBox 状态: 初步构建 · 预览版
免费大模型 API 雷达:持续复测可用性,本地统一接口,Key 只存本机
信息:方寸智匣 LocalBrain 状态: 正式迭代
本地模型的多模态 MCP 工具箱:TTS / Whisper / 视频生成一站接入
信息:ScreenLex 光影词库 状态: 正式迭代
看美剧顺手把生词背了,Mac/Windows 双平台,免费
信息:黑粉录屏 HyphenScreen 状态: 正式迭代
录屏 + 智能剪辑一体:达芬奇式时间线、自动打码、导出前成片体检,免费
引用:黑粉科技 让AI成为你的超能力 本地部署 · 免费白嫖 · 自制软件 https://hyphentech.top
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取

留言
正在加载留言…