摘要 心算容易丢中间数,写竖式就稳一些。模型也学会了先留草稿,可同一道题多等几秒,买到的究竟是正确答案,还是更长的错误解释? 黑粉科技 · 2026-10-05
17.7%到78.7%:2022年的零样本思维链研究,在MultiArith任务上报告过这样的准确率变化。数字很漂亮,可它到底证明了什么?不是随便让任何模型“多想想”都会更准,而是特定模型、提示与答案提取流程,在特定题集上有明显收益。下面从小数题、纸上算式和推理训练,把这个差别拆开。
上一篇把补全机与助手的训练目标分开;这一篇继续问:为什么写中间过程可能帮忙,专门推理训练又多做了什么,以及额外计算怎样才算值得?问题不是草稿越长越好,而是多花的预算能不能换回可验收的结果。
同一道小数题,知识库留下了两个答案
先看一道出了名的“送分题”:9.11 和 9.9,哪个大?
2026年9月11日的知识库记录把它交给Qwen3.6-35B-A3B-Uncensored-4bit(Qwen3.6),先关着“思考”开关问一次,再打开开关问一次:
| 用时 | 输出了多少 token | 答案 | |
|---|---|---|---|
| 思考关 | 0.3 秒 | 4 个 | 9.11 ❌ |
| 思考开 | 6.2 秒 | 456 个(其中 450 个是“想”) | 9.9 ✅ |
这是两题四次旧记录,不是本轮复测,也不是通用成功率。记录中开关与推荐采样配置同时变化,差异不能全部归因于开关。关着开关,它 0.3 秒就给出了一个错误答案;打开开关,它先写了 450 个 token 的草稿,花了二十倍的时间,答对了。
这张表的价值不是准确率统计,而是把成本具体化:一次用0.3秒给出4词元,另一次用6.2秒生成456词元,其中记录标注450词元为思考。用时约20.7倍,输出量约114倍;这两种倍数也不能混成同一种“成本”。完整原始输出尚待补齐、开关和推荐采样又同时变化,更不能把差异全部归因于思考。
要认真比较,至少固定题目、模型版本、工具、采样与评价规则,再说明改变了哪些推理设置,多次统计成功率和延迟。先把控制变量说明白,才知道这笔额外计算换回了什么。
按小数比较,9.9就是9.90,大于9.11;按软件版本比较,“9.11”又可能晚于“9.9”。同一字符串可以进入不同规则。版本号干扰是一个可能的解释,但没有分析该次内部计算,就不能认定它是这次答错的实际原因。先把问题类型写清楚,比替模型编一段心理活动有用。
再看另一道题:“我 6 岁的时候,妹妹的年龄是我的一半。现在我 70 岁了,妹妹几岁?”这一次,两种模式都答对了(67)。可打开思考的那次,照样多花了 7 倍的时间、多写了 384 个 token 的草稿。
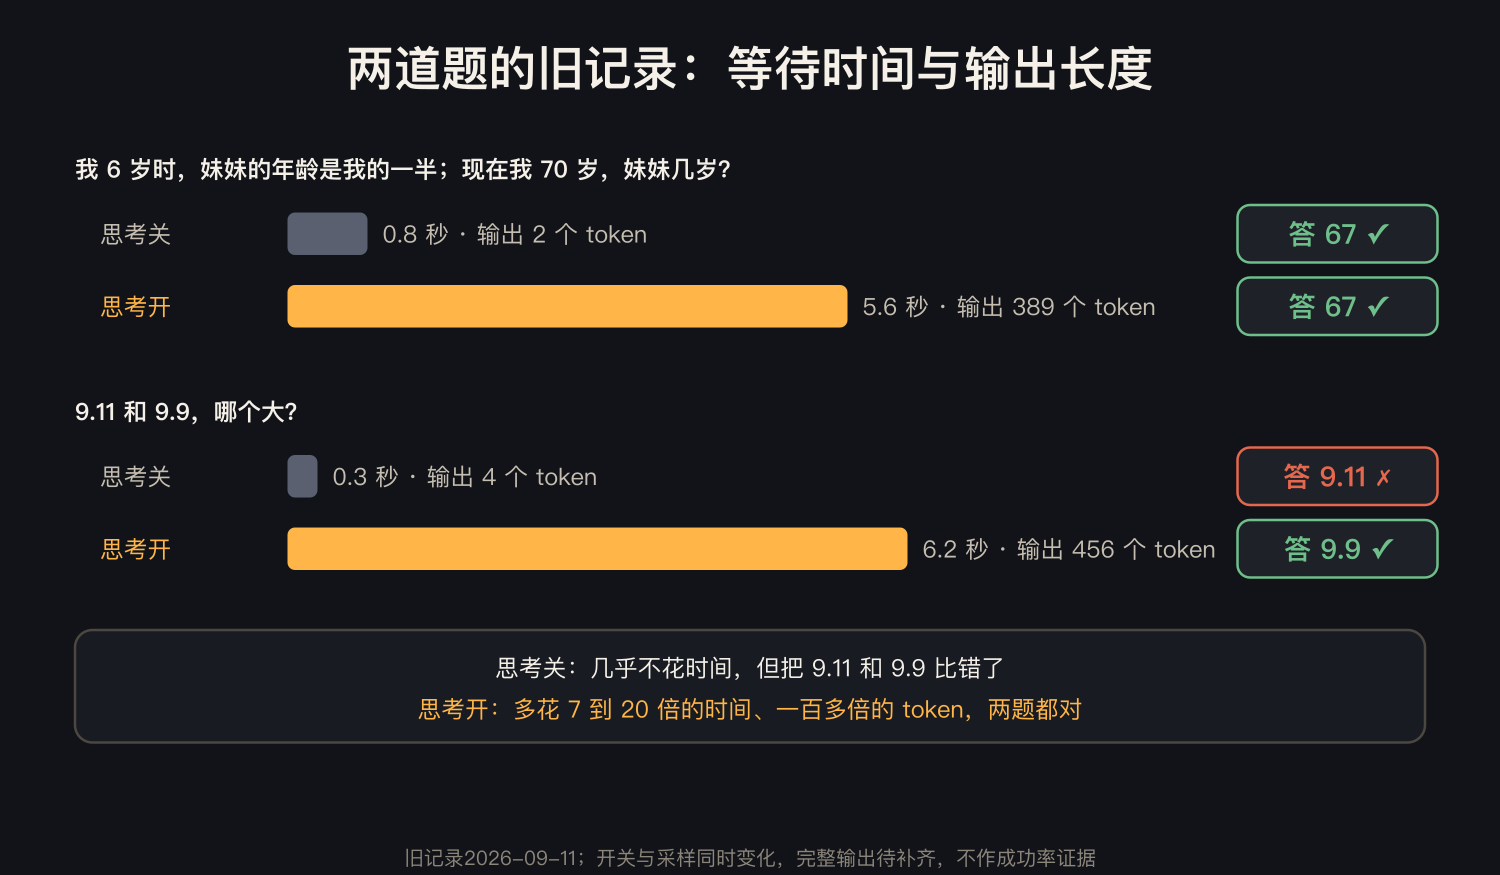
两道题、四次旧回答,展示了一种很直观的取舍:思考可能改变答案,也会改变等待与生成开销。四次记录不够估计可靠性,更不能推出“开关一开就会正确”。
“想”,其实是先打草稿
打开思考之后,模型到底在干什么?我们把那 450 个 token 的草稿翻出来看,开头是这样的:
Here's a thinking process:
1.  **Analyze User Input:**
    - Question: "9.11 和 9.9 哪个大?只回答那个数。"
这份旧记录公开了部分文字草稿,说明中间步骤可以以词元序列出现。但英文草稿并不能证明它“觉得英文更顺手”,也不能保证界面文字就是全部内部过程。观察到什么,就先说到什么。
为什么写步骤有时能帮忙?先拿一件可以独立核对的事比较,不靠模型的自述。
想想你自己心算 37×48:脑子里要同时记住好几个中间结果,很容易出错;拿张纸列个竖式,就稳多了。竖式并没有让你变聪明,它只是把中间结果写在纸上,让你不必同时记住所有东西。
生成草稿会把中间步骤加入后续计算可使用的前缀。模型因此有机会沿着已经写下的结果继续推导;KV缓存可复用前文的一部分计算,不是每次从头重算。草稿可以像竖式一样帮忙,也可以把第一步错误一路传下去。
把37×48写成37×(50−2),得到1850−74=1776。此时两个中间数留在纸上,后续不用只凭一句“我算过了”。还可以反向检查:1776÷37是不是48?这是人工算例,不是本轮模型测试。
但草稿里若把37×50写成1800,后面再详细也会沿着错数走。真正的检查应该重新计算或用独立方法验证,不能只多写一句“确认无误”。对模型来说,步骤可见提高了检查机会,不自动证明那些步骤就是答案产生的真实因果解释。
| 你改变的东西 | 它可能提供什么 | 还不能推出什么 |
|---|---|---|
| 分步提示 | 显式中间步骤 | 已经更新模型权重 |
| 推理训练 | 更常出现有用解题策略 | 每题都更准 |
| 多个候选加验证 | 比较不同答案与检查结果 | 免费且无额外预算 |
| 界面思考摘要 | 便于读者检查的一部分说明 | 完整内部逐字过程 |
一句“一步一步想”,准确率翻了四倍
2022年的两项代表性研究,让“把中间步骤写出来”成为广受关注的提示方法。它们不是所有分步推理思想的历史起点。
2022 年初,Google 的研究者发现:给模型看几道“写出了解题步骤”的例题,它也会跟着写步骤,数学题就做得好得多。他们把这种做法叫思维链(chain of thought)——让模型把推理的中间步骤写出来。
Kojima等人的2022年研究报告,在text-davinci-002上,MultiArith准确率从17.7%提升到78.7%。方法用逐步思考提示生成中间过程,再提取答案;不能压缩成“其他一切不变,只加一句中文就行”。原始论文
2022年的实验除了MultiArith,还报告GSM8K从10.4%到40.7%。两组提升不同,恰好提醒我们不要把一个漂亮数字换成通用保证。论文的零样本思维链流程还包含答案提取,不只是任意聊天框里加一句中文提醒。
这种方法利用已有模型,通过提示与流程改变作答方式,不等于重新训练参数。结果也不是全凭运气:任务、模型、提示和提取规则都值得系统比较;但单个成功例子仍不能替代代表性题集上的测量。
2024 年:从“让它想”到“教它想”
2024年9月12日,OpenAI发布o1,把经过训练的推理行为与回答前的计算投入放在产品核心。和“请一步一步想”的提示方法相比,这里还涉及训练怎样奖励解题策略,不能只叫它自动多写一段。
OpenAI的o1研究把“怎么答题”也摊在了成绩旁边:在AIME 2024中,o1单样本平均约74%,64个样本取共识约83%,对1000个样本用学习到的评分函数重排约93%。同一个模型,计算方式不同,数字就不同。不能把83%写成随便问一次的正确率;这恰好说明测试时预算也是成绩的一部分。官方研究说明
训练算力影响模型如何学,测试时算力影响同一次任务愿意投入多少计算。OpenAI在o1研究中观察到两者与表现改善的关系。多给一点时间有时能换来更好的结果,但不是对每个问题都单调成立。 这就是测试时算力的价值,也是预算需要单独记录的原因。
它像做同一道题时分配检查时间:可以直接交卷,也可以列式、重算,或者比较几份独立草稿。额外工夫有没有价值,要看它是否发现错误,而不是纸上写满了多少字。对模型来说,作答时增加的计算可能用于更长的中间步骤、更多候选或验证;具体方法不同,成绩和等待也会不同。前面的几组数字正是要连同这些作答条件一起读。
奖励怎样让它学会检查草稿?
o1怎样被训练,官方没有公开完整配方。四个月后的DeepSeek-R1报告公开了另一条路线;它能帮助我们理解推理训练,但不能当作o1内部做法的答案。
2025年1月,DeepSeek公开R1与训练方法。实验版R1-Zero从已经预训练的DeepSeek-V3-Base起步,在这一阶段的强化学习前没有加入监督微调;不是一张从未读过任何解题材料的白纸。官方训练介绍
正式R1不是简单把Zero改个名字。官方介绍的训练流程加入冷启动数据,并有多阶段强化学习和监督微调。把实验版本的特点全部当成正式产品的训练过程,会把关键差别抹掉。
R1-Zero用可核验的正确性与格式等奖励训练。可以把它想成一种给结果与规则评分的反馈,不是老师只检查最后一行、其他全部不管。
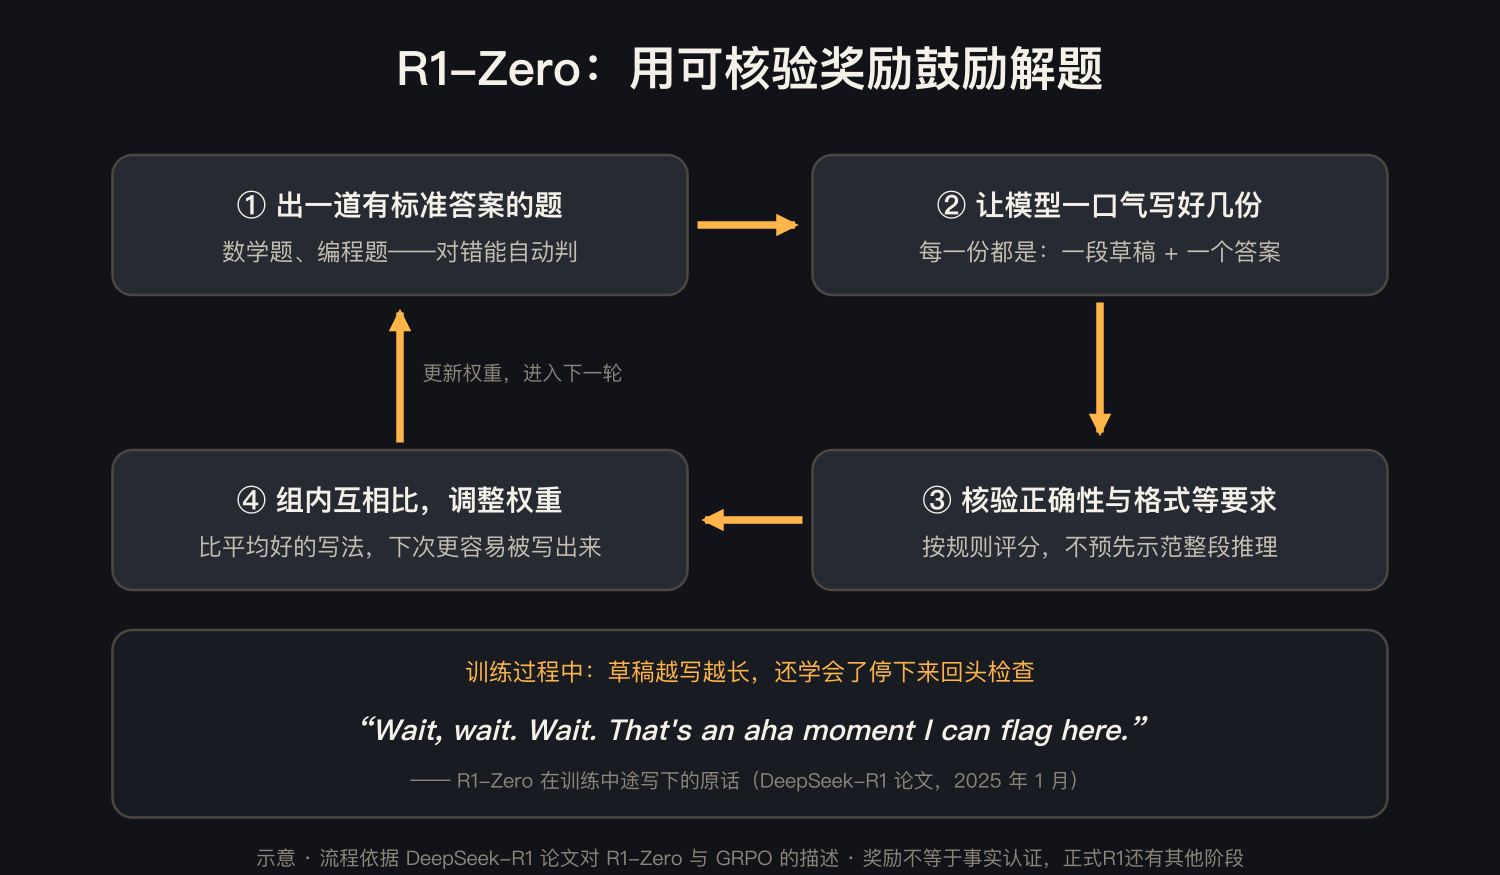
如果某些检查、重算与分步行为更常得到奖励,训练就可能提高这些行为的出现概率。它需要大量候选、评估与参数优化,不是一次做对题以后马上凭空掌握通用思考。
R1-Zero用基于规则的正确性与格式等奖励训练。数学答案可以核验,编程题可通过测试检查;组相对策略优化GRPO比较同一道题一组候选的奖励,以推动更有利的行为。它不需要另训练一个与策略同规模的价值模型,但这不等于不需要评分,也不是所有强化学习都只看最后一行。
组相对策略优化可以借同一题的几份草稿理解:先按规则评估,再比较这一组里哪些相对更好,用这些信号调整后续生成倾向。这里不是谁写得最长谁赢,而是评价规则究竟奖励了什么。强化学习会更新参数;给已经训练好的模型临时多一点解题时间,则属于作答时的计算投入。一个是在训练中改变做法,一个是在这次任务中多花工夫,两笔预算不能混在一起。
没有人告诉它“要一步一步想”。可训练到一半,研究者发现它的草稿越写越长,还开始回头检查自己的思路。论文里记下了它在一道题中间写下的一句话:
Wait, wait. Wait. That’s an aha moment I can flag here. (等等,等等,等一下。这是一个可以标记出来的“顿悟时刻”。)
论文把这类自我检查行为作为有意思的观察。它能说明训练后的生成策略发生变化,却不能单凭一句“等等”认定模型拥有人的顿悟体验。故事很有趣,证据的边界也要一起留下。
想,是要花钱的
回到开头那张表。思考不是免费的,它至少有三笔代价:
- 更慢。两道题,打开思考后分别慢了 7 倍和 20 倍。
- 更贵。草稿也是词元。是否可见、如何计费、怎样进入完成预算,依具体服务规则而定,不拿屏幕字数猜账单。
- 吃掉额度和上下文。在自己电脑上跑的时候,这一笔最容易被忽略:你设了“最多写 400 个 token”,结果 400 个全被草稿吃掉,正式回答一个字都没有——这是需要检查的一个截断风险。如果软件把草稿也重新送入后续输入,多轮上下文就可能继续膨胀,所以 Qwen 的模型卡专门建议:历史记录里只留最终回答,别留思考过程。
推理预算会增加生成或其他计算的投入,从而影响等待与成本。具体服务是否对思考词元计费、怎样限制预算,要看所用版本与说明;本篇不把某家旧费率当成所有产品的共同账单。
部分模型与产品提供了思考开关或预算设置。2025 年 4 月发布的 Qwen3,可以用 enable_thinking 整体开关,也可以在一句话后面加上 /think 或 /no_think 逐轮切换;很多模型还支持“思考预算”,限定它最多想多少个 token。
什么时候开,什么时候关?
| 适合开思考 | 适合关思考 |
|---|---|
| 数学、逻辑、多步推理 | 闲聊、寒暄 |
| 写代码、找代码里的错 | 翻译、改写、润色 |
| 需要比较和权衡的问题 | 查一个简单事实 |
| 答错代价很大的事 | 要求秒回的场景 |
这和评测有什么关系? 同一个模型,9.11 和 9.9 这道题,关着思考答错,开着答对。所以“思考开没开、给了多少思考预算”,是成绩单上必须写明的配置——不写清楚,分数就没法比。比较两份成绩单时,也要同时写清推理预算、工具与采样配置。
还要注意题型差别。事实已经过时,多想十分钟也不会凭空获得刚发布的通知;这时应查来源。题目要求精确计算,可以把步骤交给计算工具核验。需要行动,则要读回文件、发件箱或目标对象。给推理预算加码,不能替这三种验证。
所以我更愿意先问:哪一步最可能错,哪种证据能发现它?再决定预算。比较模型时,也把首词等待、思考长度、工具时间与最终正确性分开记。一次答对值得保留,但要让它成为稳定能力的证据,还需要重复与覆盖。
亲手拨一次开关
最省事的办法:打开任何一个带“深度思考”按钮的聊天软件(DeepSeek、豆包、千问等都有),关着按钮问一遍,打开按钮再问一遍:
- “9.11 和 9.9 哪个大?”
- “一根绳子对折,再对折,再对折,然后从正中间剪一刀,一共变成几段?”
留意三件事:两次的答案一样吗?打开按钮时你等了多久?它的思考过程里,有没有“等等”“我再检查一下”这样的字眼?
绳子题若采用两端对齐、连续对折3次且剪在折好后中段的通常设定,会穿过8层,相当于原绳上的8处切口,得到9段。若题目改变剪的位置、绳端位置或折法,就不能直接套9段。保留条件,比记住一个“送分答案”更有用。
回到开头的问题
也不是所有推理系统都只写一份长草稿。有些会生成多个候选、调用验证工具,或通过其他策略分配计算。界面给你看的“思考摘要”,也不一定是内部过程的完整逐字记录。
普通的分步提示,是要求现有模型把中间过程写出来;专门的推理训练,则可以奖励更有机会得到正确结果的生成行为。两者可以组合,但不是同一件事。前面17.7%到78.7%的历史实验,首先说明当时那套提示方法在那组任务上有效,不能单靠这组数字宣布所有推理训练都已被解释。
草稿提供可使用的中间结果,推理训练可以鼓励更有效的检查行为,额外候选与验证还可以改变计算分配。它们都可能有收益,也都需要验证。真正值得保留的不是“等得久所以更聪明”,而是同一任务下,时间、配置和可核对结果之间的关系。
故事里出现的几个名词
| 术语 | 人话 |
|---|---|
| 推理模型 | 专门优化多步推理等行为;内部过程未必完整可见 |
| 思维链 chain of thought | 把推理的中间步骤一步步写出来 |
| 测试时算力 test-time compute | 回答时投入的计算预算;收益依任务和方法变化 |
| 强化学习 RL | 根据奖励信号更新生成策略、让模型自己摸索做法的训练方式 |
| GRPO | DeepSeek 用的强化学习办法:同一道题写好几份,组内互比 |
| 思考预算 | 限定模型最多想多少个 token |
| enable_thinking | 部分Qwen模板使用的开关;不能套用于所有模型 |
下一篇接着看:零件拆过了,现在把它们装回去。跟着“今天天气真”走进一间只认数字的翻译社,看一句话怎样变成概率,再变成你屏幕上的文字。
参考资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
把 Mac 变成私有 AI 盒子:本地转写、配音、生图、视频和 MCP 工具一站管理。
本轮公开 Apple Silicon Mac 安装包。聊天模型现在可通过同一代理按需调用已集成的语音、转写、图像、图片编辑、音乐和视频工具,并把实际产物交给下一项工具继续处理。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
在 AI 面板打开「制作动画」,输入讲解及自己的要求,从三组19种风格方法中选择。模型结合当前内容设计主体、动作与镜头,生成可编辑的原生动画图层和关键帧。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取
留言
正在加载留言…