摘要 草莓还是那颗草莓,前面多一个空格,机器看到的块数却变了。一个来自数据压缩的老办法,怎样走进聊天框,改变你的费用、速度和上下文? 黑粉科技 · 2026-10-05
一个会写代码的模型,数strawberry里的r却可能翻车。不是草莓太难,是文字进入模型以后,未必还是我们眼前那十个字母。先拆这个笑话,再看看同一套切法怎样同时影响账单、速度和上下文。
上一篇说,神经网络吃进去的是数字,吐出来的也是数字。可你打给它的是一句话。 这一篇讲这句话变成数字的第一步:切块。这一步看起来最不起眼,却能解释三件怪事——模型为什么数不清字母,中文和英文为什么“价钱”不一样,以及评测表上的速度数字为什么不能直接拿来比。
一个会写代码、却数不清字母的模型
2024 年,网上流行过一个小测验:问当时最强的几个聊天模型,“strawberry 这个词里有几个 r?”
很多模型信心满满地回答:两个。
正确答案是三个。同一批模型能写出几百行能跑的代码,能在各种考试里拿高分,却在一个小学生都不会错的问题上翻了车。你大概会猜:它粗心了,或者它其实不太懂英文。
分词让它面对的表示不同,但不能据此断言它永远不会数。模型也可能学到拼写,或通过逐字符展开和工具完成计数。
在模型输入里,strawberry通常先被分词器变成词元编号,未必是十个独立字母。下面的切法来自知识库2026年9月11日保留的记录,展示版本差异,不是本轮重跑:
| 切块器 | 单独的 strawberry | 句子中间的“空格 + strawberry” |
|---|---|---|
| Qwen3.6 | str · aw · berry(3 块) | 1 整块 |
| GPT-4o 用的 o200k | st · raw · berry(3 块) | 1 整块 |
| Gemma 4 | 1 整块 | 1 整块 |
注意最后一列。在英文句子里,单词经常带着前导空格,词表可以把“空格+strawberry”收成一个词元。开头、标点之后或采用不同预处理规则时,切法还会不同,不能说英文单词前面总有空格。
问模型这个词里有几个 r,就像指着一张号码牌问它:这上面有几个 r?它还可能通过逐字展开或代码工具核算,不只一种路线。
现在把号码牌展开:s、t、r、a、w、b、e、r、r、y。r在第3、8、9位,一共3个。这个展开不是让模型换一个漂亮说法,而是把验证对象从“这个词大概怎样拼”变成“这十个位置逐项检查”。
同样的方法适用于身份证明编号、订单号和文件名。让它改写段落时,关键字符串可以单独提取并比较。模型说“原样保留”,只是一个声称;逐字符一致,才是这项要求的证据。草莓笑话的价值,不在于宣布模型笨,而在于找到一套不靠信任的检查。
但“切成整块”不是不能计数的死刑判决。模型可能学到拼写,也可能把字母显式展开,或借助代码检查。真正的问题是:词元预测与逐字符计数不是同一个操作,单凭它平时英语写得好,不能保证这次字母数就可靠。
模型看见的,是一串编号
要理解切块器,最好的类比是一件中国人一千年前就发明了的东西:活字印刷。
北宋的沈括在《梦溪笔谈》里记下了毕昇的做法:把字一个个刻成泥活字,排版时从字盘里挑出来拼成一页。常用的字,比如“之”“也”,每个都备着二十多枚,免得一页里重复出现时不够用;碰到字盘里没有的冷僻字,就“旋刻之”——当场现刻一个。
模型读文字的方式,在“固定字盘与编号”的层面很适合类比,实际算法当然不同:
- 字盘:模型出厂时就带着一副固定的“活字”,叫词表(vocabulary)。Qwen3.6 的字盘里约有 24.8 万枚,Gemma 4 有 26.2 万枚。
- 活字:字盘里的每一枚叫一个 token,中文常译作“词元”。它可以是一个字、半个字、一个词,也可以是一个词连同它前面的空格。
- 格子号:每枚活字在字盘里有一个固定编号。模型真正读到的,就是这一串编号。
分词器在推理时通常按固定词表、规则与预处理方式编码文本;它不是另一个理解整段语义的聊天模型。但词表可以从语料学习出来,不能把固定执行规则误写成整个制作过程都没有学习。
来看一句最普通的话——**“今天天气真好,我们去公园散步吧。”**这一篇会一直跟着它走。四个切块器,切出了四种样子:
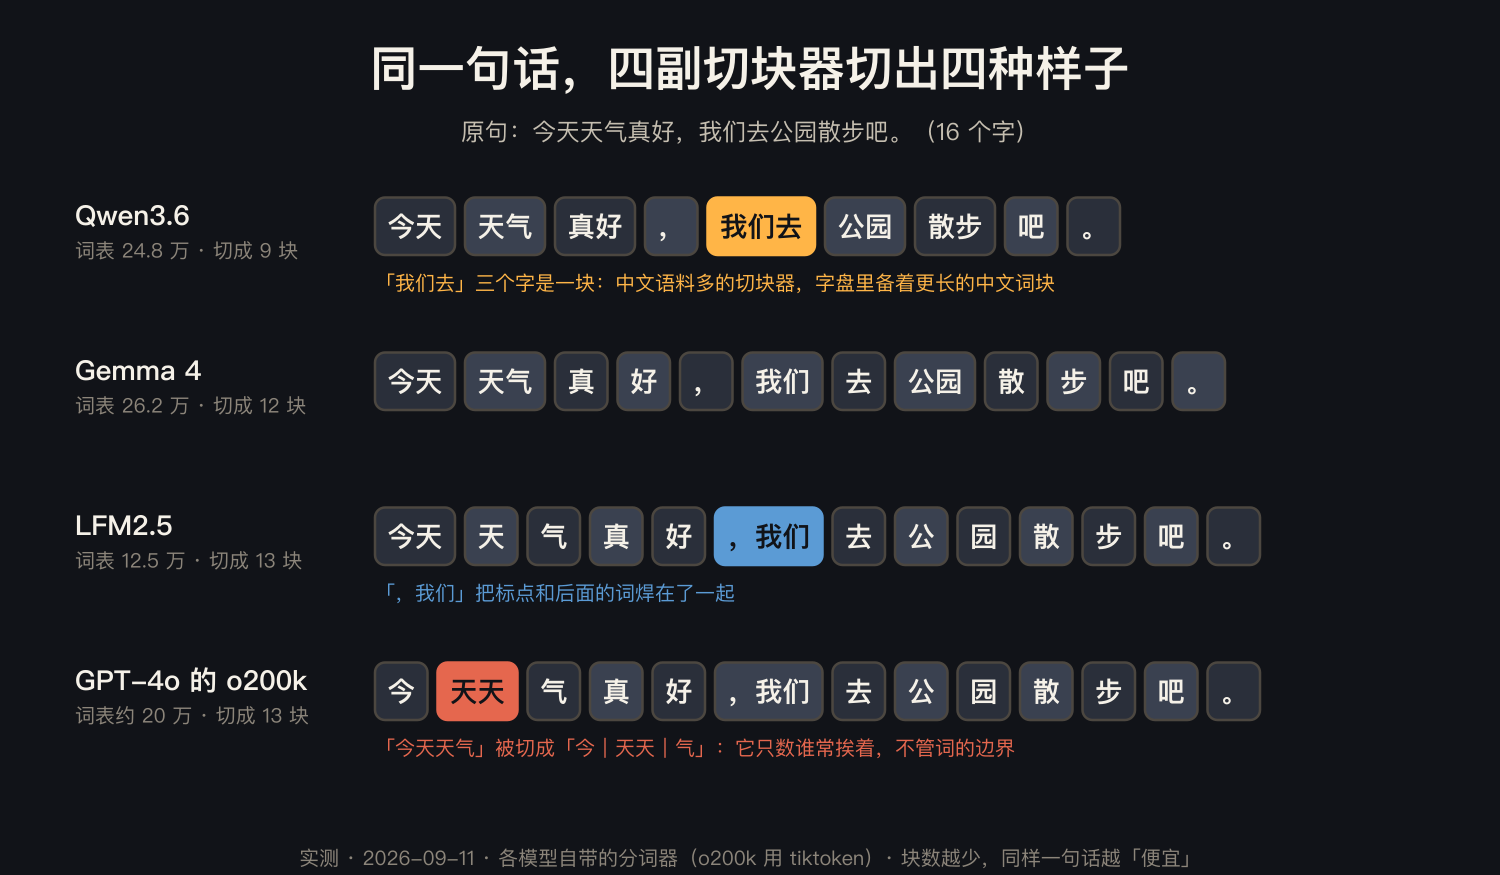
这句中文有16个字符:14个汉字加逗号、句号。旧记录里,Qwen3.6切成9块,另外三个切成12到13块。o200k把“今天天气”切成“今|天天|气”,没有遵循人会选择的词边界。
最有意思的是最下面一行。“天天”是个很常见的词(好好学习,天天向上),所以 o200k 的字盘里备了它;结果“今天天气”被切成了“今”“天天”“气”,把两个词拆开,又焊错了地方。切块器不懂中文的词是什么,它只记得统计上哪些片段最常一起出现。
这副活字是怎么造出来的?
那么,字盘里备哪些活字,是谁定的?
答案来自一个意想不到的地方:数据压缩。1994 年,程序员菲利普·盖奇(Philip Gage)在一本编程杂志上发表了一个压缩文件的小技巧:找出文件里最常挨在一起的两个字节,用一个新符号替换掉;再找下一对,再替换……一直做到没有可替换的为止。这个方法叫字节对编码,英文缩写 BPE。
森里奇与同事在2016年的机器翻译论文中,把BPE用于子词表示,缓解罕见词问题。今天常见的分词方案还包括Unigram等,不能把所有分词器都当成同一种合并算法。
它的思路一句话就能说完:从单个字母开始,数一数哪两块最常挨在一起,把它们焊成一块,放进字盘;反复做,直到字盘装满。
下面这段代码真的能跑。语料是四个英文词和它们出现的次数,“_”表示词尾:
import re
from collections import Counter

# 一份迷你语料:词 → 出现次数。先把每个词拆成单个字母,“_”表示词尾
vocab = {"l o w _": 5, "l o w e r _": 2, "n e w e s t _": 6, "w i d e s t _": 3}

for step in range(1, 7):
    pairs = Counter()
    for word, freq in vocab.items():              # 数一数:哪两块最常挨在一起
        s = word.split()
        for a, b in zip(s, s[1:]):
            pairs[a, b] += freq
    (a, b), n = pairs.most_common(1)[0]
    pat = re.compile(r"(?<!\S)" + re.escape(f"{a} {b}") + r"(?!\S)")
    vocab = {pat.sub(a + b, w): f for w, f in vocab.items()}   # 把这一对焊成一块
    print(f"第 {step} 次合并:{a} + {b} → {a + b}(一共出现 {n} 次)")

print(list(vocab))
知识库2026年9月留存的输出:
第 1 次合并:e + s → es(一共出现 9 次)
第 2 次合并:es + t → est(一共出现 9 次)
第 3 次合并:est + _ → est_(一共出现 9 次)
第 4 次合并:l + o → lo(一共出现 7 次)
第 5 次合并:lo + w → low(一共出现 7 次)
第 6 次合并:n + e → ne(一共出现 6 次)
['low _', 'low e r _', 'ne w est_', 'w i d est_']
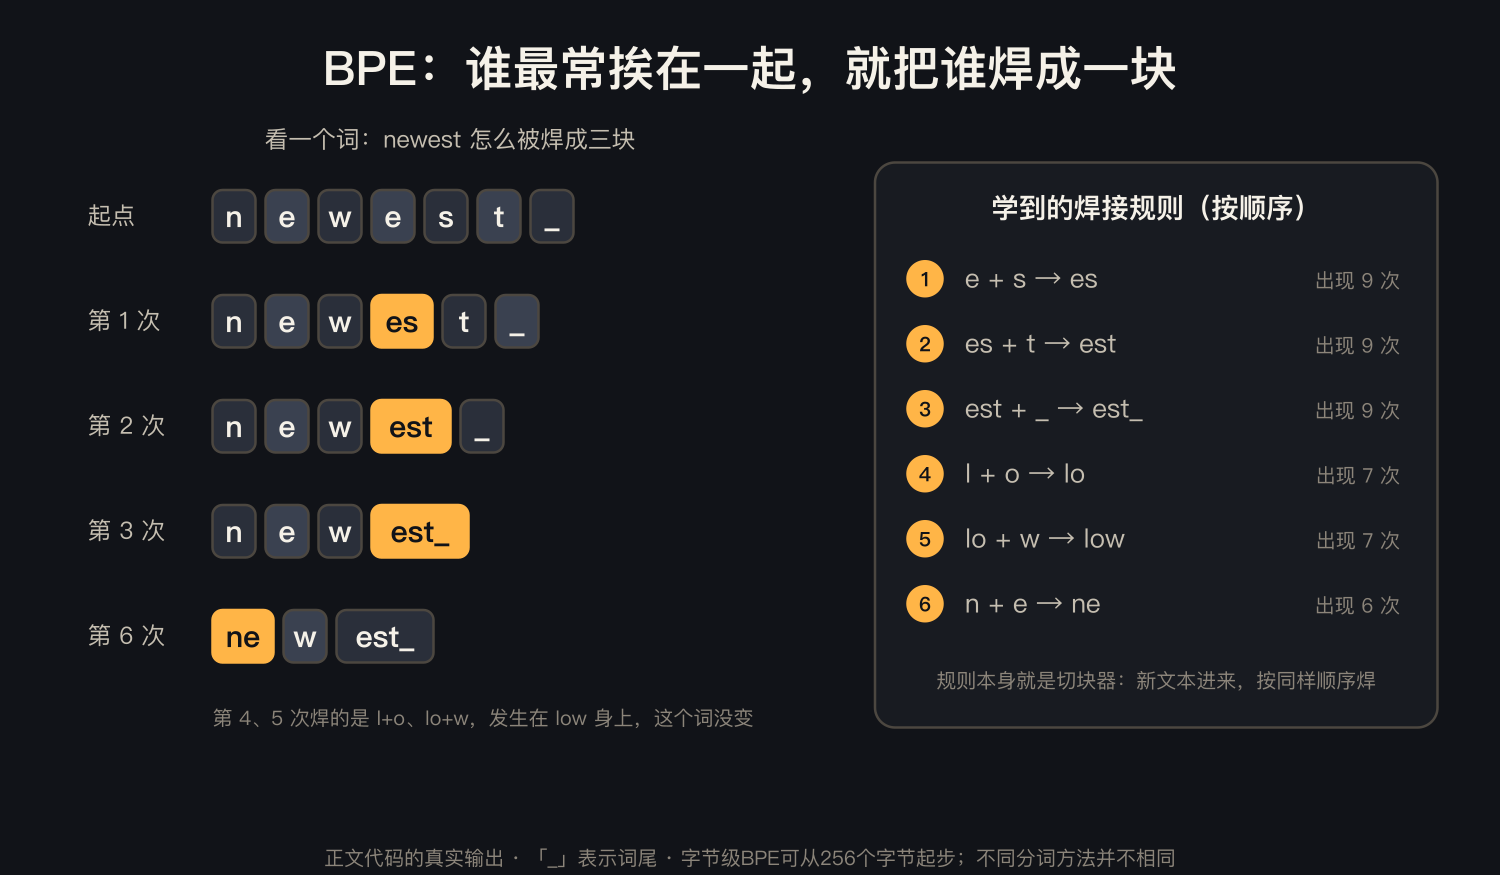
newest 出现 6 次、widest 出现 3 次,所以“e s”一共挨在一起 9 次,第一个被焊上。焊过六次之后,newest 变成了 ne、w、est_ 三块。
这段代码演示的是合并频繁相邻片段的思路,不是任何产品分词器的完整复刻。字节级BPE可以从256种字节开始;另一些方案以字符或其他初始单元起步。词表规模、预分词、规范化与特殊标记,也会改变实际结果。
这个过程也像小店备打包袋:经常一起买的东西,预先装成组合,零散需求仍从小件开始拼。BPE的“合并”对应经常相邻的片段逐步组成更大的片段,词表则记录有哪些零件及编号;真正切一段新文字时,再按这套学好的规则编码。它不是每次聊天都重新观察你的购买习惯,也不保证一种语言永远打包得更省。接下来的冷僻字,考的就是组合袋里没有现成货时怎样处理。
这也解释了开头的 strawberry:它在英文语料里出现得足够多,“空格 + strawberry”早就被焊成了一整块。焊成一块之后,里面有几个 r,模型并非直接得到十个独立字母;这不等于永久丧失拼写能力。
字盘里没有的字,怎么办?
毕昇碰到冷僻字,可以当场现刻。切块器不会刻字,它只能拿更小的零件去拼。
在支持字节表示或字节回退的方案里,可以用更小的字节单元编码词表未直接收录的字符。常见汉字在UTF-8中通常占3字节,某些生僻字符占4字节;分词规则决定这些字节落到几个词元中。这不是所有分词器都具有的相同保证。
拿“饕餮耄耋”这四个生僻字旧分词记录:
| 切块器 | 切成几块 | 单独看每一块 |
|---|---|---|
| Qwen3.6 | 8 块(每个字 2 块) | 全是“�” |
| GPT-4o 的 o200k | 光“饕餮”两个字就 4 块 | 全是“�” |
| Gemma 4 | 4 块(一个字一块) | 饕 · 餮 · 耄 · 耋 |
单独解码一个不完整的UTF-8字节片段,可能显示“�”。它不是严格意义上的“半个汉字”,也不必然是文件损坏;把完整序列的字节拼回去后,可能正常恢复原文。图里的不同切法,需要连同解码方式一起看。
数字也很有意思。“1234567890”在 Qwen3.6 和 Gemma 4 里是 10 块,一个数字一块;在 LFM2.5 里却是“123|456|789|0”四块。把数字一位一位切开,是很多新模型刻意的设计:Meta 在 2023 年发布 LLaMA 的论文里,专门写了两条——把所有数字拆成单个数位;碰到不认识的字符,退回到字节。道理不难想:如果“123”和“124”是两个毫不相干的编号,模型要学会进位,就难得多。
同样一句话,中文和英文的价钱不一样
词元数量会进入成本计算,但块数不等于整张账单。输入、输出、缓存命中可能采用不同费率,具体还要看所用服务的价格与统计口径。
知识库旧记录比较了固定中文样本与英文字符样本,各取3000字符。它适合观察同样文本长度如何编码,不保证两组文字表达了等量信息:
| 切块器 | 3000 个汉字 → 块数 | 平均每块几个字 | 3000 个英文字符 → 块数 | 平均每块几个字符 |
|---|---|---|---|---|
| Qwen3.6 | 1861 | 1.61 | 871 | 3.44 |
| Gemma 4 | 2075 | 1.45 | 926 | 3.24 |
| LFM2.5 | 2335 | 1.28 | 882 | 3.40 |
能看出两条规律。
第一,同一段中文,换个切块器,块数能差出四分之一。 Qwen3.6 最省,LFM2.5 最费。字盘里备的中文词块越多,切得就越省。
比较两种语言,最好尽量控制表达内容,而不只是字符数。这里中文例句有16字符;英文“The weather is really nice today, let’s take a walk in the park.”含64字符。旧记录对这两个样本给出了9词元与16词元。它说明这次编码的差别,不足以推出中文永远更便宜,更不能拿字符数当信息量。
跨语言分词研究发现,不同语言表达相近内容时,词元数量可能不均衡。差距也会随分词器版本与样本变化。因此,判断自己的中文任务,最直接的办法是拿实际输入计数;不要把某篇研究中的平均倍率贴到所有模型与所有文章上。
token 同时是三种单位
之所以要专门讲一篇切块,是因为 token 不只是模型肚子里的事,它还是你在外面会碰到的三种单位:
- 计费单位。在线大模型按 token 收钱,通常报“每百万 token 多少钱”,输入和输出分开计价。
- 速度单位。“每秒 50 个 token”,说的是模型每秒吐出几块。
- 长度单位。“支持 128K 上下文”,通常以词元计算容量,具体K口径、输入输出与多模态占用看所用服务;历史、资料和输出也要占预算。
三种单位,同一把尺子。切块器一换,三笔账就全变了。
三笔账不能一起粗略乘个系数。先看上下文:它装的不只是这次问题,还有系统指令、历史、检索资料、工具回执,并且需要为输出预留位置。下面是假设总预算10000词元的算例,不对应任何接口的真实套餐。
上下文窗口像当前摊开在桌面上的工作材料:你的问题、前面的对话、找到的资料和工具回执都占位置,还要给新答案留空间。它和长期档案柜不同;软件可以把旧记录存到别处,但下次若没重新放回桌面,模型就未必能用上。计费又像运输账单,装进来的材料和送出去的结果可能分别计价。因此,“桌面放得下多少”和“这一趟付多少钱”,不能只报一个词元数就算完。
| 占用部分 | 词元预算 | 为什么不能漏算 |
|---|---|---|
| 系统指令与模板 | 1000 | 界面上未必全部可见 |
| 历史对话 | 4000 | 旧回答也会进入后续输入 |
| 本次问题与资料 | 3000 | 附件转文本与检索片段也占位 |
| 输出预留 | 2000 | 前面占满,答案就没空间 |
再看费用:同样2000输出词元,未必与2000输入词元同价;缓存优惠也要确认服务是否命中及怎样收费。最后看等待:输入预填、逐步解码、网络和工具时间不是同一个指标。词元数量帮你算预算,但不能独自说明端到端体验。
128K窗口也是同样道理。它首先是特定模型或服务定义的容量;能否放进本机内存、长文中间是否可靠取回信息,是另外两个问题。按一段文章估出的“能装多少汉字”,只能用于那类文本的近似预算,不是任意材料都适用的兑换率。
两个模型都报每秒50词元,不能据此认定读者收到的内容一样多。若输出文本的统计密度分别为每词元1.61与1.28个汉字,才可估算为每秒80.5与64个汉字;上表测的是输入样本,不能直接证明输出也有同样密度。实际横评应保留原始输出,同时记录词元、字符、首词延迟与总时间。
字盘里的幽灵活字
字盘里有某个词元,不代表语言模型总能稳定处理它。有些异常字符串,恰恰把分词器与模型训练之间的接口问题暴露出来。
2023 年初,两位研究者杰西卡·朗伯洛(Jessica Rumbelow)和马修·沃特金斯(Matthew Watkins)在 GPT-2、GPT-3 的字盘里翻出了一批怪异的 token。最出名的一个是“ SolidGoldMagikarp”,本来是一个 Reddit 用户名。这位用户常年泡在一个“大家接力从 1 数到无穷大”的版块里,名字出现的次数多到切块器把它焊成了一整块。
研究者讨论过分词器语料与模型训练覆盖不一致等解释。可以明确的是:词表里能编码一个字符串,不代表模型能稳定处理它;对某个词元的异常,不能仅凭一个故事断言唯一内部原因。
这些案例被称为故障词元。它们提醒我们检查编码、训练覆盖与生成行为,但某个异常究竟由什么引起,还需要实验。一个有趣的用户名故事,不能替所有故障词元给出唯一诊断。
亲手切一次
装一个 OpenAI 开源的切块器库,五行代码就能看见一句话被切成了什么样:
import tiktoken                                   # pip install tiktoken
enc = tiktoken.get_encoding("o200k_base")         # GPT-4o 等模型用的分词器
for s in ["今天天气真好,我们去公园散步吧。", "strawberry", " strawberry", "饕餮"]:
    ids = enc.encode(s)
    print(len(ids), [enc.decode([i]) for i in ids])
真实输出:
13 ['今', '天天', '气', '真', '好', ',我们', '去', '公', '园', '散', '步', '吧', '。']
3 ['st', 'raw', 'berry']
1 [' strawberry']
4 ['�', '�', '�', '�']
换几句话看看:你的名字、一句方言、一行代码、一个表情符号。哪里切得特别碎,哪里就要消耗更多词元。 这会影响费用与长度预算;但不能单凭块数推断回答必然更差,能力还取决于训练覆盖与具体任务。
回到开头的问题
更稳的判断是:逐字符操作与词元生成不是同一件事。长随机串、生僻词、重复字符计数等任务,更需要验证。问一句“有几个r”,只得到答案,还没有看到它采用了什么可靠方法。
拿strawberry这个具体例子,手工拆开是s、t、r、a、w、b、e、r、r、y;r在第3、第8、第9位,总计3次。这是对字符的核算,不是本轮模型能力测试。让它输出拆分,再用程序检查,比让它自信再答一遍有用。
对密码、序列号、订单号尤其如此。模型说“已原样保留”,不如做字符串对照。把验证码逐字符保留这件事,交给普通代码通常更省心,不必专门请一个会聊天的网络来背锅。
观察单个词元时,还可能看到替换字符“�”:一个完整Unicode字符可能被分进不同字节片段。单块解码显示异常,不表示整串文本坏了;核对完整序列的还原结果才有意义。
回到草莓:词元改变了机器收到的表示,但不是失败的万能解释。计数要核对,账单看实际使用量,速度看原始输出,上下文看完整输入预算。同一把尺子连接了几件事,却不能替它们完成验收。
故事里出现的几个名词
| 术语 | 人话 |
|---|---|
| token(词元) | 文字编码的单元,可以是词、字符片段、标点或字节 |
| 分词器 tokenizer | 按词表、规则与预处理编码文字;词表本身可从语料学习 |
| 词表 vocabulary | 词元与编号的清单;规模取决于具体模型和版本 |
| token ID | 每个 token 在词表里的编号,是模型真正读到的东西 |
| BPE 字节对编码 | 反复把最常挨在一起的两块焊成一块,焊出整张词表 |
| 字节回退 byte fallback | 词表里没有的字,拆成字节来表示 |
| 故障 token glitch token | 某些模型不能稳定处理的异常词元;内部原因需具体核查 |
| 每块字数 | 特定文本平均每词元对应的字符数;输入输出和不同语言要分别统计 |
下一篇接着看:猫和狗像,猫和内阁不像。把这种直觉放进数字里,词语就有了距离;可“允许商用”和“不允许商用”也可能挨得很近。相关资料,不等于正确答案。
参考资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
把 Mac 变成私有 AI 盒子:本地转写、配音、生图、视频和 MCP 工具一站管理。
本轮公开 Apple Silicon Mac 安装包。聊天模型现在可通过同一代理按需调用已集成的语音、转写、图像、图片编辑、音乐和视频工具,并把实际产物交给下一项工具继续处理。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
在 AI 面板打开「制作动画」,输入讲解及自己的要求,从三组19种风格方法中选择。模型结合当前内容设计主体、动作与镜头,生成可编辑的原生动画图层和关键帧。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取
留言
正在加载留言…