摘要 模型、仓库、软件、工作流 四件套 + 三个能直接抄的点子 拆解自 Greg Isenberg 播客 · 2026-09-15
Greg Isenberg 上周发了一期 38 分钟的单人播客,叫《Local AI Clearly Explained》。我从头听到尾,中间倒回去听了三遍同一句话。
大多数人问的是“这个模型是不是比云上最强的模型聪明”。该问的是——它够不够干这个活?跑在我自己机器上,会不会让产品变得更好?
—— Greg Isenberg
问句一换,整件事就换了性质。
我顺手去翻了 Gemma 4 的官方模型卡,想看看“旧笔记本”到底是个什么水平。结果是这样的:E4B 在 4-bit 量化下,官方估算占用约 4.5 GB 内存;更小的 E2B 约 2.9 GB。 一台 16 GB 内存的 2021 款笔记本,跑起来绰绰有余。
那台在抽屉里吃灰的机器,配置从来不是问题。是我们从来没想过它能干什么。
“本地 AI”到底是什么,一句话讲完
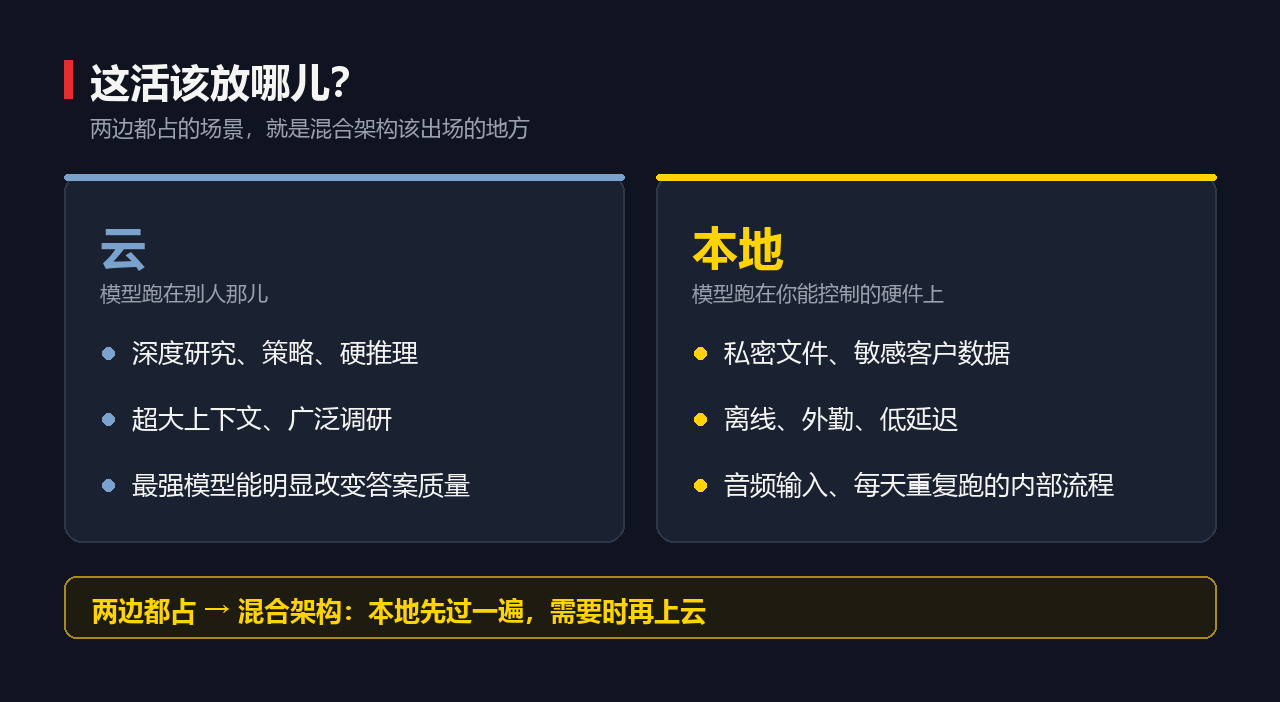
本地 AI = 模型跑在你能控制的硬件上。 就这么一句,没有别的了。这个硬件可以是 MacBook、Windows 笔记本、安卓手机、iPhone,可以是浏览器,可以是树莓派,也可以是办公室里那台工作站。
云 AI = 模型跑在别人那儿,你通过网页或者 API 去够它。区别就这么点。
打个不太严谨但很好用的比方:云 AI 像是把你家的账本寄到会计事务所,人家专业,但账本得寄出门;本地 AI 是请了个会计坐在你家客厅,水平差一点,但账本一步都没离开过你家。
| 该用云 | 该用本地 |
|---|---|
| 深度研究、策略、硬推理 | 私密文件、敏感客户数据 |
| 超大上下文、广泛调研 | 离线、外勤、低延迟 |
| 最强模型能明显改变答案质量 | 音频输入、每天重复跑的内部流程 |
两边都占的场景,就是混合架构该出场的地方
四件套:这张地图记住就够了
这期把整个空间拆成四块。我觉得这是全片最值钱的结构,比任何工具推荐都管用。
- ① 模型——大脑文件。Gemma、Llama、Qwen、Mistral 都是家族,不是单个模型
- ② 仓库——去哪儿找模型,答案是 Hugging Face:模型卡、许可证、格式、跑分、量化版本
- ③ 软件——谁负责把模型跑起来,对绝大多数人就两个:LM Studio 和 Ollama
- ④ 工作流——你围着前面三样做出来的那个产品
前三件都是零件,第四件才是生意。后面三个点子全部长在这一条上。
重点 130 亿 — 美元,Nvidia 收购 Hugging Face 2026-09-03 官宣,含最高 10 亿美元员工留任股权包
Greg 在录这期的时候说“我记得 Hugging Face 现在正在被 130 亿美元收购”。这事已经落定了,而且是 Nvidia 历史上第二大的一笔收购。
重点 四件套里“仓库”那一层,被卖硬件的那家公司买走了。
拆机制:这些数字决定了你能不能上车
概念好听,落到机器上才算数。下面的数字来自 Google 官方模型卡,不含上下文开销。
| 型号 | 定位 | BF16 | 8-bit | 4-bit |
|---|---|---|---|---|
| E2B | 手机 / 边缘 / 浏览器 | 11.4 GB | 5.7 GB | 2.9 GB |
| E4B | 本地起步最实际的一档 | 17.9 GB | 8.9 GB | 4.5 GB |
| 12B Unified | 笔记本 | 26.7 GB | 13.4 GB | 6.7 GB |
| 26B A4B | 每 token 激活 4B 的 MoE | 57.7 GB | 28.8 GB | 14.4 GB |
| 31B | 服务器级 / 本地工作站 | 69.9 GB | 34.9 GB | 17.5 GB |
小模型上下文窗口 128K,中型 256K;E2B/E4B/12B 原生支持视频和音频
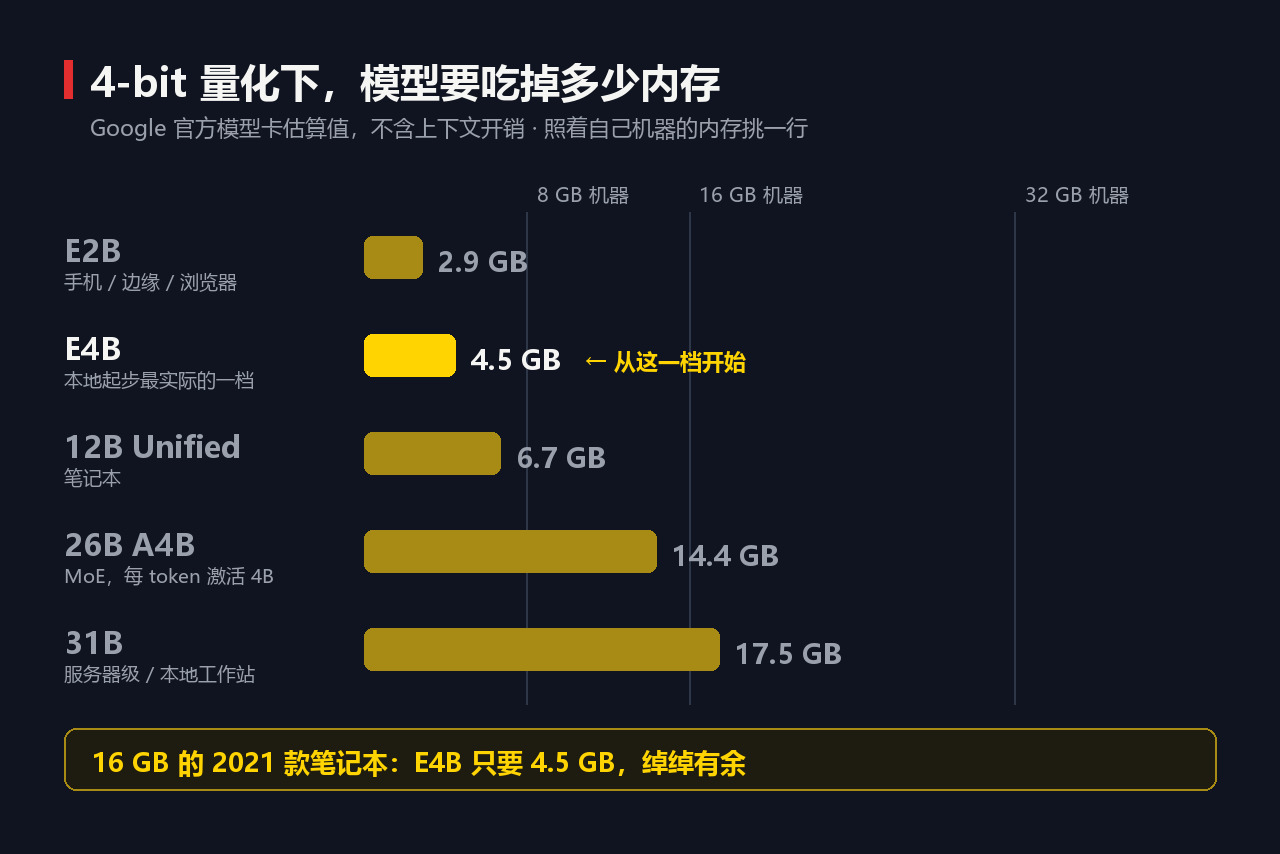
对照一下内存:8 GB,老老实实从最小的开始;16 GB,E4B 加量化模型能跑出有用的东西;32 GB,更大的工作流有空间了;有强 GPU 或者工作站,那些大家伙才变得现实。
还有一层很多人不知道:专用模型
- EmbeddingGemma:把文字变成向量,让你按意思搜自己的文档和工单。3.08 亿参数,量化后 200 MB 内存以内,支持 100 多种语言
- FunctionGemma:结构化函数调用,把“模型给了我一个答案”变成“模型让软件做了下一步”。已有 270m 规模的微调版本在做离线设备控制
- 另外还有做视觉的、做安全过滤的、做可解释性的
建议 第一天这些全都可以先不管。从 E4B 开始,把一个工作流跑通,再挪。
泼点冷水:这事儿没那么美
警告 这期播客是 Google 赞助的。Greg 自己在开场第 57 秒就说了,这点他很坦荡。但结果就是全片举例集中在 Gemma 和 Google 的端侧工具链上。四件套这个框架跟厂商无关,照用;具体选哪个模型,你得自己横着比一遍。
“够不够用”这个问题,得靠测,不能靠信。 办法很朴素:同样 10 份材料,一份用本地模型跑,一份用云端前沿模型跑,然后对着看——本地那份抓到同样的问题了吗?引语摘对了吗?格式守住了吗?漏了什么?
这个对比会直接告诉你分界线在哪儿。没跑过这一轮就说“本地够用了”,那是信仰不是判断。
另外有几条是 Greg 的个人判断,不是事实:比如“这些行业还在用 2000 年代初的软件”,来源是他自己家漏水时看到的那套系统;比如“有 24 个月的窗口期”,没有数据支撑;比如他说微软的 Phi 系列“很多场景我没见它跑得多好”,也没给测试条件。当观点听可以,当依据用不行。
至于我自己这边——那台旧笔记本上的实际跑分我还没做,等跑完单独出一期,把首 token 延迟和吞吐一起摆出来。在那之前,上面这些数字都是官方口径,不是我的实测。
谁在笑,谁在哭,谁一言不发
信息:谁赚了 卖硬件的。Nvidia 花 130 亿美元买下模型仓库,不是做慈善——当算力回到设备上,谁卖设备谁吃饭。做端侧运行时的也赚:Google 把 LiteRT-LM 从安卓一路扩到 Swift API 和 JavaScript API,AI Edge Gallery 已经上架 macOS。这不是随手做的 demo,是在正经铺渠道。
信息:谁亏了 按 token 计费的那部分云收入——高频、重复、推理难度不高的批处理最先跑掉。还有那些界面停留在二十年前的垂直行业软件:护城河从“你的数据存在我这儿”变成“谁的审阅清单更准”,而清单是一个人访谈十个客户就能做出来的东西。
信息:谁一言不发 按量计费的那一方。他们没有任何动机告诉你,哪些活根本就不该上传。
重点 沉默方的立场,往往就是结论。
这也不是第一次算力往回跑。手机拍照就走过一模一样的路:早年修图要上传云端,后来整套计算摄影全塞回端侧的 ISP 和 NPU 里。当年把算力拽回设备的理由和今天一字不差——延迟、隐私、高频。区别是摄影那套模型厂商预置,你没得选;这次模型可下载、可替换、可以自己挑。
三个点子,直接抄
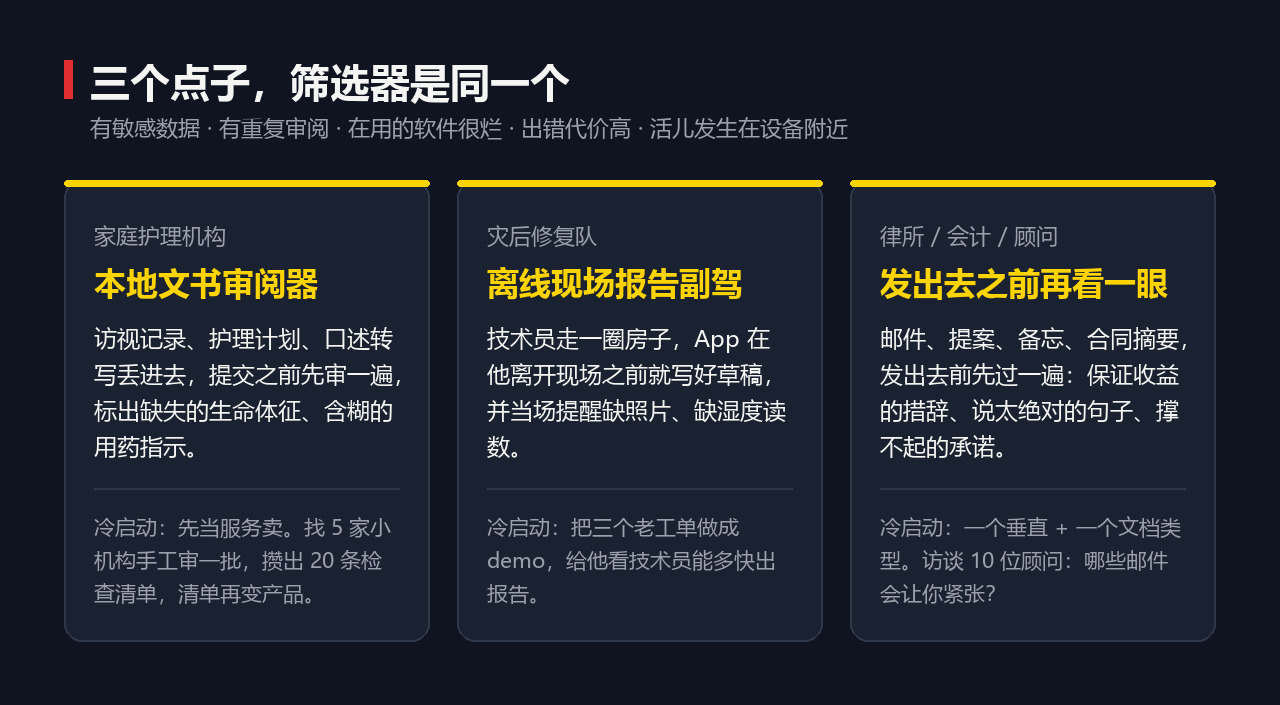
先给筛选器,这个比点子本身重要:找一类客户,同时满足五条——有敏感数据、有重复的审阅工作、在用的软件很烂、出错代价很高、活儿发生在设备附近。 五条凑齐的地方,就是有意思的区域。
点子一:家庭护理机构的本地文书审阅器
护士和护工上门,回来要写访视记录、更新护理计划、走账单和合规。漏一个细节就是账单延迟,记录含糊就是额外行政工作,访视和护理计划对不上就是风险。
第一版做成给机构用的本地桌面应用:把记录、护理计划、口述转写丢进去,提交之前先审一遍,标出来——“这条记录提到头晕,但缺生命体征”、“护工写了用药变更,但后续指示不清楚”、“这条记录可能撑不起申报的服务级别”。
建议 怎么冷启动:先当服务卖,别一上来做产品。找 5 家小机构,帮他们审一批记录,背后用本地模型跑但自己先人工复核,把反复出现的 20 个问题记下来。这 20 个问题变成检查清单,检查清单再变成产品。
点子二:灾后修复队的离线现场报告副驾
水灾、火灾、霉菌治理这些活,技术员在现场拍照、录语音、记录损害,最后要给房主和保险理赔员出报告。这活是视觉的、体力的、远离办公桌的。
第一版做成手机应用:技术员在房子里走一圈,App 在他离开现场之前就把报告草稿写好,并且当场提醒——“你提到了地下室,但没有地下室照片”、“你拍了天花板损伤,但没有湿度计读数”。
还有一条被严重低估:“给房主的这段解释太技术了,这是一个他能听懂的版本。” 房子泡了水,人正在最烦躁的时候。把话说清楚,本身就是产品的一部分。
建议 Demo 极其好做:把三个老工单发我,我给你看你的技术员能多快出报告。
点子三:专业服务的“发出去之前再看一眼”
律所、会计、财富顾问、猎头、咨询,几乎每一家都有同一个动作:有人写了客户邮件、提案、备忘、合同摘要,然后找另一个人在发出去之前看一眼。
- 财富顾问:标记听起来像“保证收益”的措辞——这是红线
- 律所:标记说得太绝对的句子
- HR:标记不该出现在这条线程里的员工信息
- 代理商:标记合同范围撑不起的承诺
- 会计:标记和附件对不上的数字
Greg 管这个叫 schmuck insurance(傻事保险),还顺口报了个域名说你们拿去。为什么好卖? 因为买方已经在做这个动作了。你不是教育市场,你只是给了他一个更快的第一遍,而且这一遍离他的客户数据更近。
建议 冷启动:一个垂直 + 一个文档类型。只做“独立财富顾问的邮件审阅”,先别碰大银行。访谈 10 位顾问,问一个特别具体的问题——哪些邮件会让你紧张?
今天晚上就能做的那件事
就算你一个点子都不打算做,这套东西也值得学,因为它会改变你处理自己文件的方式。
桌面建一个文件夹,扔 10 份对你工作真正重要的东西进去——销售通话记录、会议纪要、旧的想法笔记、客户工单都行。然后让本地模型产出一个文件:一份周度业务脉搏,或者“客户对话里到底什么变了”,或者把功能请求按背后的真实痛点重新分组。
重点 要的是一个文件,不是一段对话。聊天窗口里的回答关掉就没了,只有可复用的产物才会真的改变工作流。
跑完一轮是这样的:模型读文件夹 → 模型写文件 → 你检查 → 你改工作流 → 再跑一次。跑上几轮,你会开始注意到两件事:哪些私密数据被困在文件夹里出不来,以及哪些审阅动作你每周都在重复做。
上手路径,按顺序来
| 路径 | 适合谁 | 关键动作 |
|---|---|---|
| LM Studio | 完全不写代码 | 搜 Gemma 4 → 机器好选 E4B/旧选 E2B → 挑量化版本 → 直接聊;之后开 developer 区的本地服务器 |
| Ollama | 会敲两行命令 | ollama pull gemma4;ollama run gemma4:e4b;本地 API 在 11434 端口 |
| Google AI Edge + LiteRT-LM | 要做真正的 App | 模型装进手机/浏览器/桌面/边缘设备 |
第三条是从“本地 AI 是个 demo”到“本地 AI 是个产品”的那条路
第一句话别打“你好”,浪费了。直接上业务提示词:读这些客户记录,把它们变成一页备忘录——客户在为什么发愁、什么变了、这周公司该先修哪一个问题。 然后粘一批真实工单进去。那一刻你会意识到:这段提示词一个字都没发出去过。
一旦你不再把本地 AI 当成“跑分对比”,而是当成“产品对话”,这件事一下就好懂了。
—— Greg Isenberg
要问自己的就五个问题:活发生在哪儿?数据在哪儿?设备在哪儿?信任问题在哪儿?那个每周都在重复的烦人审阅循环在哪儿? 答完这五个问题,点子是自己冒出来的,不是想出来的。
摘要:一句话总结 至于那台吃灰的笔记本——4.5 GB 而已。它一直都够用,只是我们一直没让它干活。
原视频:Greg Isenberg《I’m Obsessed With Local AI. Here’s Why》,38 分 46 秒,2026 年 9 月 8 日发布,本期由 Google 赞助。模型参数、内存占用、上下文窗口来自 Google AI for Developers 官方模型卡;Hugging Face 收购数据来自 Bloomberg、CNBC 2026 年 9 月 3 日报道。
<!-- HFKJ_FIXED_FOOTER_START:由脚本生成,请勿手改 -->
🧰 我做的工具
这些工具都由我持续维护。预览版会明确标注,下载、更新和已知边界以发行页为准。
信息:黑粉剪辑 HyphenCut 状态: 初步构建 · 预览版
Rust 写的本地专业视频剪辑:达芬奇键位、AI 助理直接改真实工程,免费
信息:黑粉盒子 HyphenBox 状态: 初步构建 · 预览版
免费大模型 API 雷达:持续复测可用性,本地统一接口,Key 只存本机
信息:方寸智匣 LocalBrain 状态: 正式迭代
本地模型的多模态 MCP 工具箱:TTS / Whisper / 视频生成一站接入
信息:ScreenLex 光影词库 状态: 正式迭代
看美剧顺手把生词背了,Mac/Windows 双平台,免费
信息:黑粉录屏 HyphenScreen 状态: 初步构建 · 预览版
录屏 + 智能剪辑一体:达芬奇式时间线、自动打码、导出前成片体检,免费
引用:黑粉科技 让AI成为你的超能力 本地部署 · 免费白嫖 · 自制软件 https://hyphentech.top
<!-- HFKJ_FIXED_FOOTER_END -->