摘要 猫和狗像,猫和内阁不像。把这种直觉放进数字里,词语就有了距离;可“允许商用”和“不允许商用”也可能挨得很近。相关资料,不等于正确答案。 黑粉科技 · 2026-10-05
猫和狗像,猫和内阁不像——把这种直觉变成数字,是向量有用的起点。但“可以商用”和“不可商用”也可能高度相似。你最想找的答案,恰好藏在那个“不”字里。
第5期把一句话切成了一串编号。可编号本身没有意思——3721 号和 5893 号之间,看不出谁和谁更像。 这一篇解决那个跨越性的问题:怎么把“意思”这种最不像数学的东西,变成机器能算的数字? 答案是语言学里关于词与上下文的朴素洞察。
最笨的办法,和它为什么不行
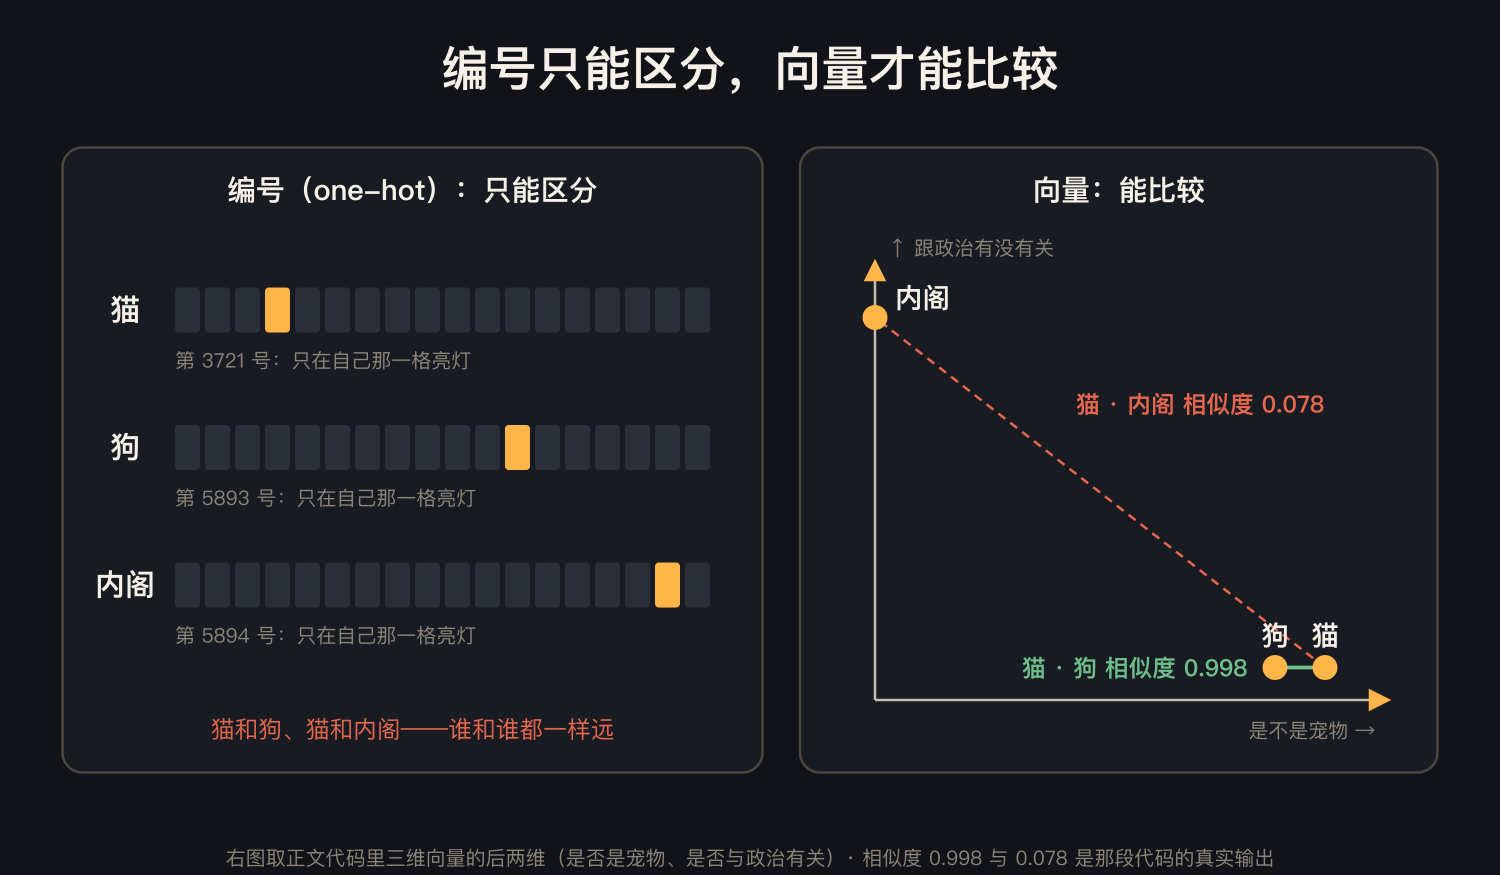
最直接的想法:给词表里每个词发一个编号。“猫”是 3721,“狗”是 5893,“内阁”是 5894。
可以把每个编号写成one-hot:词表有十万项,就用十万维向量,仅对应位置是1,其余是0。这是说明表示性质的办法;实际嵌入查表通常直接使用编号,不必真的为每个词元存下一长串零。
这个方案有两个致命伤:
如果把每个one-hot都按稠密向量存储,大量零会浪费空间。不过稀疏表示与直接查表可以避免这种浪费,所以重点不只是它长。
二、更致命的——它本身没有编码语义远近。 在这种表示下,任意两个词之间的距离完全相同。“猫”和“狗”的距离,等于“猫”和“内阁”的距离,等于“猫”和“量子力学”的距离。
单看这种表示,机器无法据此判断猫和狗更相近。后续训练仍可以学出有用表示。你把词变成了数字,但没把“意思”变成数字。
再往前一步:假设嵌入矩阵有十万行,每行是几百个数。“猫”的编号只负责找到相应行,不是把3721当成大小参与比较。把这一行取出来,就是猫的初始向量;在训练中,预测错误通过梯度影响有关参数,包括这张表的值。
编号与向量的差别,可以拿超市货架理解:商品条码负责找到商品,不是条码越接近,商品就越像;另一张记录表才可以列出重量、口味等可比较的信息。嵌入查表做的是前一种定位后取出一组数,训练再让这些数对任务有用。真实向量的每一维通常不能直接叫作“甜度”或“动物程度”,货架的比喻只帮我们分清索引与数值表示。
所以,从编号到向量不是给编号加一点小数,也不是先把词翻译成“动物、宠物、可爱”几个人工标签。它是把一个离散索引接到一组可学习的连续数值上。第4期的旋钮没有消失,只是现在它们组织成了一张可供查取的表。
那个朴素的洞察
转机来自语言学,而且比深度学习早了半个世纪。
1957 年,英国语言学家约翰·弗斯(J.R. Firth)留下一句被引用了无数次的话,大意是:看一个词跟哪些词做伴,你就知道它是什么意思。
这就是分布假说(distributional hypothesis)。它的主张听起来近乎废话,细想却极其锋利:
常出现的上下文提供语义与用法线索。它能支持学习表示,却不意味着字典定义没有价值,也不意味着同一上下文里的词都能互换。
举个例子。假设你完全不认识“醍醐”这个词,但你见过一万个含它的句子,发现它总出现在“灌顶”“顿悟”“豁然开朗”附近,在这个假设语料中很少出现在“炒菜”“轮胎”旁边。你可以推测它的常见用法与语气,却未必知道所有字典义项——语境能提供线索,不等于完整定义。
机器可以利用大量上下文训练数值表示。有效的地方不是“读得比人多”这句话,而是把表示接到可优化的任务上,错误会反过来更新参数。
word2vec:让向量学会算术
2013 年,Google 的托马斯·米科洛夫(Tomas Mikolov)团队发布了 word2vec,把这个想法工程化了。
方法本身很像第4期那十五行代码:搭一个小网络,给它一个任务——看到一个词,猜它周围会出现什么词(或者用周围词预测中心词)。训练完成后,那个任务的答案其实没人关心,真正的产物是训练过程中每个词学到的那串数字。
这串数字通常是几百维,每一维是个小数。它有个正式名字:词嵌入(word embedding),因为它把词“嵌入”到了一个几百维的空间里。
结果令人震惊。在这个空间里,语义关系变成了几何关系:
- 意思相近的词,位置相近——“猫”和“狗”挨着,“内阁”在很远的另一片区域
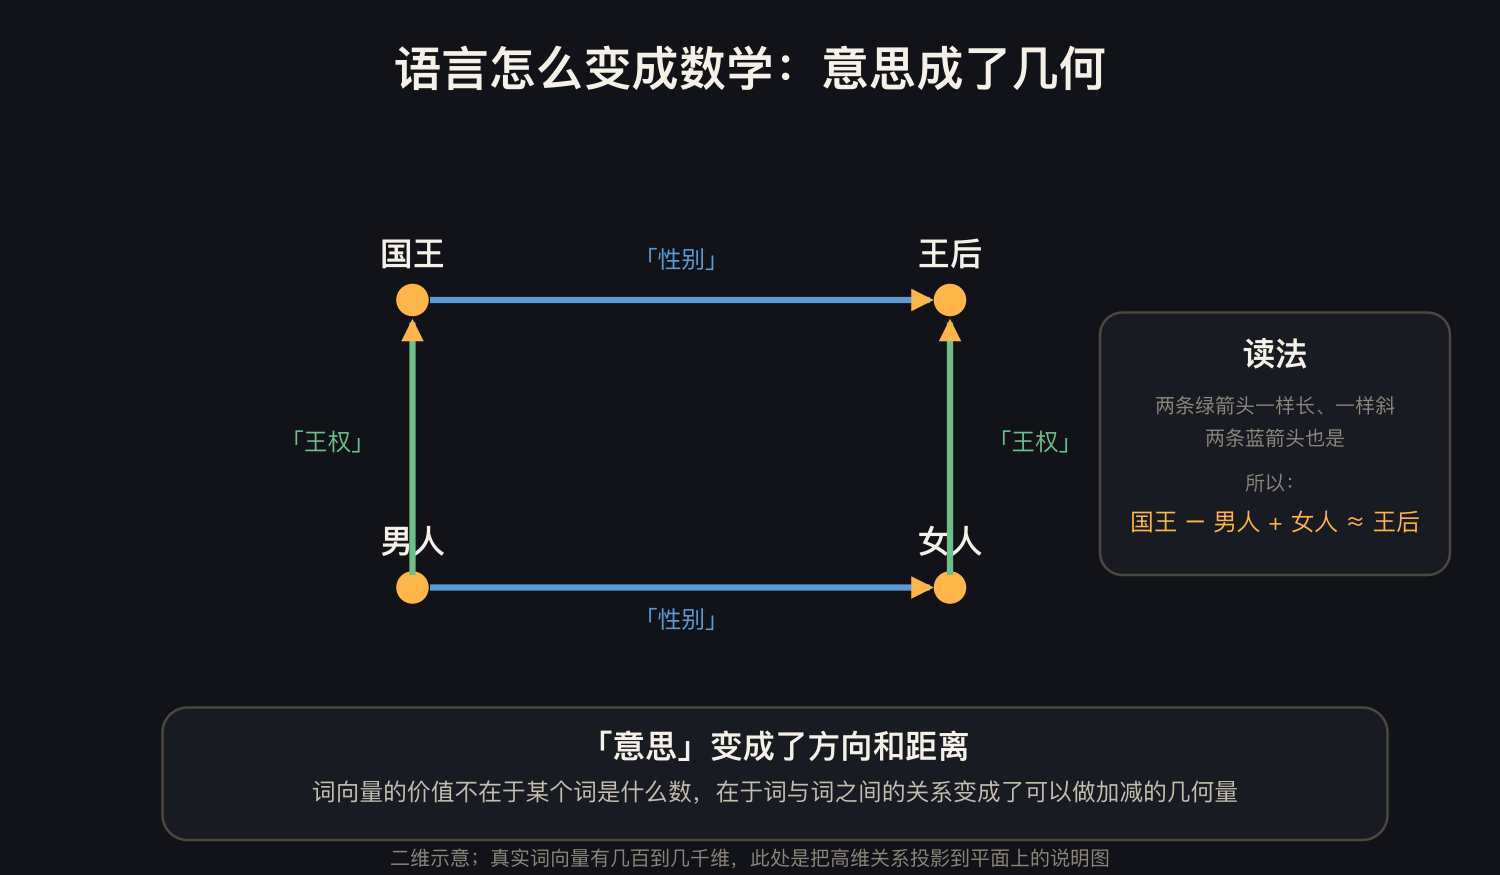
- 更惊人的是,关系本身也变成了方向。最著名的例子是:
向量(国王) - 向量(男人) + 向量(女人) ≈ 向量(王后)
“从男人指向女人”的那个方向,和“从国王指向王后”的方向几乎平行。某些语义或句法关系在特定训练得到的向量空间里,可以用近似方向描述。但这不是恒等式,依赖语料、模型和检索方法;不能要求任何嵌入模型都复现同一个类比。
为什么能做算术,又不能把它当逻辑计算器?因为训练可能让某类关系形成近似一致的方向,却没有承诺每一对词都满足这条式子。换语料、换训练目标、换检索方法,最近的词也可能变。一个成功类比证明某些关系被表示出来,不证明整套知识都遵循向量加减法。
另外,余弦相似度比较方向,不是答案正确的概率。0.9不能解释成九成可靠;不同嵌入模型的0.9也没有天然相同的含义。检索阈值必须结合实际资料与任务校准,而不是看这个数字顺眼就定下来。
从同一个位置出发,两个箭头都朝东,只是一个长、一个短;余弦相似度主要比较它们朝向有多接近,不把长度当成同一种差别。在向量里,这能用来比较表示的方向。再想想点外卖:“加辣”和“不加辣”说的是同一道菜,字也很像,送到嘴里的结果却完全不同。检索相似度把相关候选找出来了,那个会改变要求的“不”字仍须核对。接下来查商用许可时,也是这个道理。
没有人设计这些方向。它们是从“谁和谁做伴”这一件事里自己长出来的。这也意味着它会把训练文本里的偏见一起学走:2016 年有研究者在 word2vec 的向量里做同样的算术,得到了“男人之于程序员,如同女人之于家庭主妇”,论文的标题就是这句话。
动手感受一下
不用下载模型也能理解核心机制。下面这段代码手工编了几个词的三维向量,演示怎么用余弦相似度衡量语义距离:
import numpy as np

# 三个维度我们假装分别代表:[是否有生命, 是否是宠物, 是否与政治有关]
vec = {
    "猫": np.array([0.9, 0.9, 0.0]),
    "狗": np.array([0.9, 0.8, 0.0]),
    "内阁": np.array([0.1, 0.0, 0.9]),
}

def 相似度(a, b):
    # 余弦相似度:看两个向量的"方向"有多一致,1=完全同向,0=方向正交;不直接等于语义毫不相干
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))

print("猫 vs 狗 :", round(相似度(vec["猫"], vec["狗"]), 3)) # → 0.998
print("猫 vs 内阁:", round(相似度(vec["猫"], vec["内阁"]), 3)) # → 0.078
代码里的维度是我手工赋予含义的示意,不是某个模型的真实参数。实际向量通常由训练共同学得,很难稳定把每一维命名为宠物、政治或生命。0.998和0.078也是这三个手工向量的计算结果,不是猫狗语义的统一标准答案。
一个关键的缺陷,和 Transformer 的登场
word2vec 有个硬伤:每个词只有一个固定向量。
可是“苹果”在“我吃了个苹果”和“苹果发布了新手机”里显然不是一个意思。静态词向量只能给出一个折中的平均值,两边都不讨好。
解决它需要一种能读完整句话、再决定每个词此刻是什么意思的机制——也就是说,词向量必须随上下文变化。
这正是下一篇要讲的 Transformer 干的事。输入词元的嵌入通常仍可从参数表查得;进入Transformer之后,内部表示再经过上下文计算,同一个词元在不同句子中的隐藏表示可以不同。“苹果”这个词在两个句子里,会得到两个不同的向量。
这里要把两个“向量”分开:输入嵌入是参数表里的初始表示;经过多层网络后得到的是依赖上下文的内部表示。我们常用的检索嵌入模型,又可能把一整段资料压成一个向量。三者有关联,但不保证维度、训练目标与距离意义相同。
这也解释了为什么知识库换了嵌入模型,通常需要重新建立索引。旧资料向量与新问题向量若不在兼容的同一空间,数字长度即使相同,也不能直接比较。就像两套地图都写经纬度,却偷偷使用不同坐标规则,不能把两个数字对上就算定位成功。
这是从“词典”到“理解语境”的关键一跃。
这和评测有什么关系? 向量能算相似度,所以“两段话意思像不像”可以变成一个数——不少自动评分就是这么做的:把模型的回答和标准答案各变成一个向量,看它们挨得有多近。可它量的是像不像,不是对不对:把“会”改成“不会”,两句话的向量可能依然挨得很近。看到这类方法打出来的分数,先问一句:它量的是语义相似,还是经过核查的正确性?
相似度找到候选,条件核查才能做决定
假设你的知识库有两段许可说明:一段允许商业使用,一段只允许个人非商业使用。检索问题是“这个工具能不能拿来接商业项目?”两段都谈工具、许可与商业,可能同时进入候选。向量检索做的是找相关资料;最终回答必须保留版本、主体和否定条件,不能把第一段的许可嫁接给第二个工具。这是假设场景,不是一次真实检索测试。
把这个许可例子走完整。资料A写“版本1允许商用”,资料B写“版本2仅限个人使用”,用户问的是版本2。两段都在讲同一个软件与商用,向量可能都很相关。若只拿最相似片段,再让模型润色,错版本就可能被写成很自信的答案。
| 步骤 | 这次要检查的对象 | 遗漏后的后果 |
|---|---|---|
| 先限定 | 产品名、版本2、生效日期 | 取到旧许可 |
| 再检索 | 相关候选及出处 | 只找到不完整一句话 |
| 复核条件 | 允许范围、否定词与例外 | 把不允许改成允许 |
| 组织回答 | 结论及支持它的原文 | 流畅答案没有可追查依据 |
这不是声称我刚做了一次许可评测,而是一个说明检索错误怎样进入回答的场景。重排序可以改善候选选择,元数据过滤可以减少版本混淆,最后仍要核对原文的适用条件。检索增强的价值是提供证据,不是给模型的口气加一道保险。
把整套检索流程想成去档案室查文件:向量检索先找谈同一件事的材料;元数据过滤先限定日期、版本或主体;重排序再仔细比较哪些候选更贴合问题;检索增强把选出的原文交给模型参考。每一步都能帮忙,只有最后回到文件中的适用条件,才能回答“这份许可对我是否有效”。这也解释了为什么补一个检索入口,还不等于给答案加上事实保证。
以后看到某个评分用“回答与标准答案的向量相似度”,也要作同样区分。“允许”与“不允许”可能只差一个字,却改变整个结论;评测必须确定它是否真正识别了这类差别。找到相关话题,和判断事实成立,是两种任务。
| 相邻概念 | 解决什么 | 遗漏了什么 |
|---|---|---|
| 词元编号 | 让模型区分输入符号 | 编号大小没有语义远近关系 |
| 嵌入与相似度 | 找语义相关的候选 | 不自动核实事实、日期和否定条件 |
| 检索与重排 | 从资料里挑更可能有用的片段 | 可能漏检或选错版本 |
| 生成与引用核实 | 组织答案并检查原文是否支持 | 引用存在不等于主张被支持 |
带着这件事,试一次
准备3对短句:“允许商用/不允许商用”“版本1支持/版本2不支持”“收费接口/免费接口”。先不算分,标出会改变行动的词。如果以后测试嵌入模型,要同时记录模型版本、实际相似度、排序和关键条件有没有保留;不能把手工三维算例当真实语义模型评测。
向量让语义关系成为可计算的候选线索,不让“相关”自动变成“正确”。词元编号负责查表,训练决定表示,上下文进一步改变内部状态;检索则要用适合的嵌入模型和核查流程,把候选接成有依据的回答。
故事里出现的几个名词
| 术语 | 人话 |
|---|---|
| one-hot | 只有一位是 1 的超长向量;浪费且无语义 |
| 分布假说 | 上下文分布能提供语义线索;不能代替全部词义 |
| 词嵌入 embedding | 把词表示成几百维小数向量,语义近则位置近 |
| word2vec | 2013 年把分布假说工程化的方法 |
| 余弦相似度 | 用两个向量方向的一致程度衡量语义接近度 |
| 向量算术 | 国王-男人+女人≈王后;抽象关系变成空间方向 |
| 维度 | 表示包含多少个分量;检索嵌入输出维度不一定等于语言模型hidden_size |
| 静态 vs 上下文嵌入 | 每词一个固定向量 vs 随句子动态计算 |
下一篇接着看:一站一站传话,和随时查找前文,是两种不同的组织方式。2017年的论文改变了语言模型,但它没有送给机器一份永不遗忘的记忆。
参考资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
把 Mac 变成私有 AI 盒子:本地转写、配音、生图、视频和 MCP 工具一站管理。
本轮公开 Apple Silicon Mac 安装包。聊天模型现在可通过同一代理按需调用已集成的语音、转写、图像、图片编辑、音乐和视频工具,并把实际产物交给下一项工具继续处理。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
在 AI 面板打开「制作动画」,输入讲解及自己的要求,从三组19种风格方法中选择。模型结合当前内容设计主体、动作与镜头,生成可编辑的原生动画图层和关键帧。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取
留言
正在加载留言…