摘要 31 GiB 权重,M5 Pro 上 20 步 69 秒;中文书法写对四字。接入 LocalBrain 时踩中三处依赖与进程陷阱。 黑粉科技 · 2026-09-22
31 GiB 的权重下完,我在自己写的方寸智匣里点「生成」,报错。改一处,再点,还是报错。第三次才出图——而三次报错里有两次,连一句能看懂的提示都没有。
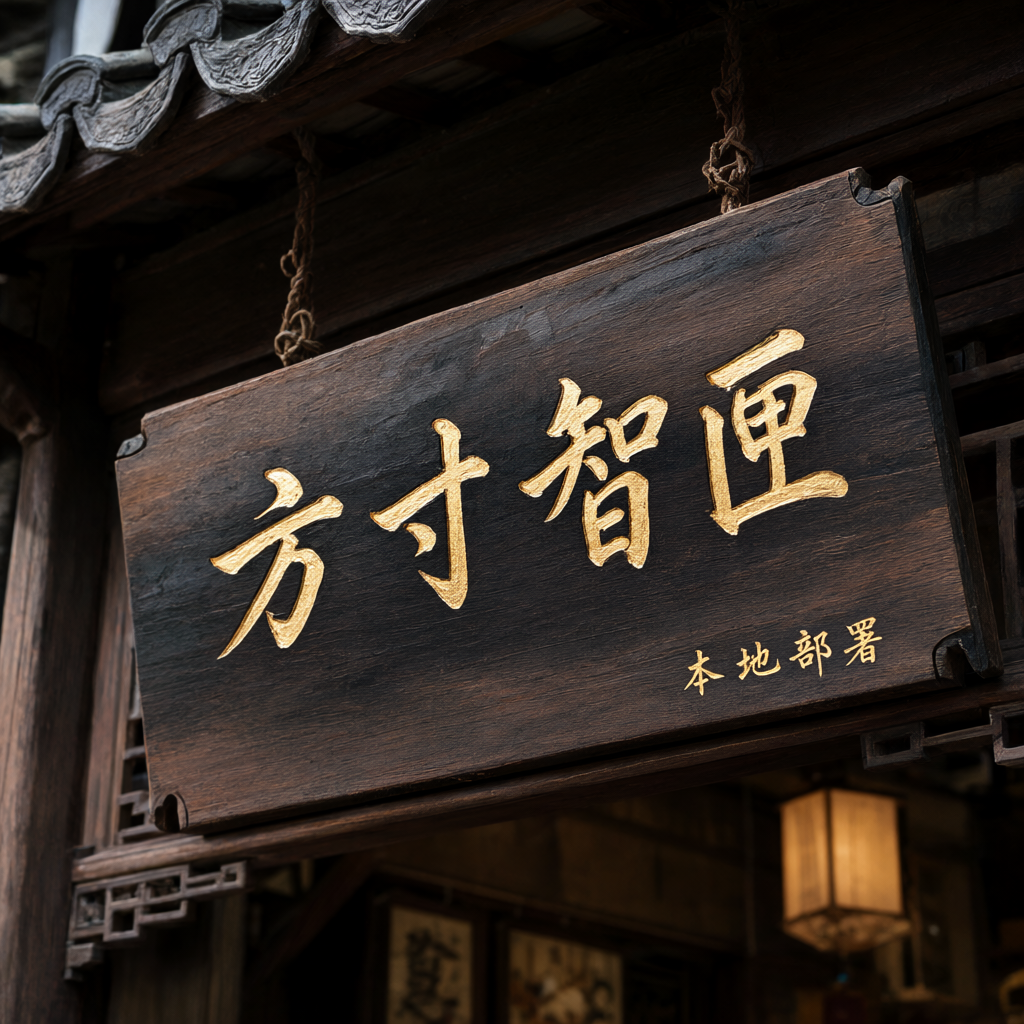
先把结论放前面:**这个模型值得装,理由是中文。**它能在一块木质牌匾上写对「方寸智匣」四个金漆楷书大字,也能在水墨荷塘的左上角竖写「痴心妄想」。速度是 M5 Pro 上 1024×1024、20 步 69 秒。但从「权重下完」到「第一张图」之间那三个坑,我觉得比速度更值得说。
先说这次测什么、什么算通过
我这次不是跑基准分。我要回答的是一个很具体的问题:把它接进一个已经在跑 Z-Image 的本地应用,需要付出什么?
所以验收口径是三条:权重能不能完整加载;同一条代码路径能不能同时喂给两个模型;出来的图有没有达到「值得占 31 GiB 硬盘」的程度。速度我只记单次实测,不做跨引擎对比——我没装别的推理引擎,那种对比我做不了。
机器是 M5 Pro、20 核 GPU、64GB 统一内存。权重按 bf16 加载到 Metal,没有做 CPU 卸载。下面所有数字都是这一台机器、这一套配置跑出来的。
权重 30.8 GiB,加载 15 秒
建议 先看它由什么组成。这不是一个单体模型,是四个部件拼起来的流水线:
| 部件 | 是什么 | 权重 |
|---|---|---|
text_encoder |
Qwen3-VL-8B | 16.33 GiB(4 片) |
transformer |
QwenImage21Transformer2DModel | 13.25 GiB(2 片) |
vae |
AutoencoderKLQwenImage21 | 1.26 GiB |
processor / scheduler |
纯配置,没有权重 | — |
合计 30.8 GiB。文本编码器比出图的那部分还大——一个八十亿参数的视觉语言模型专门用来读你的提示词。这也解释了它为什么能把中文写对:理解汉字的那一半,本来就是个正经的中文大模型。
从磁盘加载到 Metal 显存用了 15 秒。之后每张图的成本是固定的:1024×1024、20 步 69 秒;28 步我连跑四张,分别是 90.9、89.1、94.0、98.6 秒。步数和耗时基本是线性的,没有什么意外。
第一个坑:缺一个库,而它不报这个错
建议 第一次点生成,报的是这个:
ImportError: Qwen3VLVideoProcessor requires the Torchvision library but it was not found
它的 processor 是 Qwen3VLProcessor,会顺手拉起 Qwen3VLVideoProcessor,而后者硬依赖 torchvision。我的环境里没有——因为原来跑的 Z-Image 不需要它。
这个坑真正难受的地方在于它躲过了所有提前检查。应用装完运行环境会当场验一句 from diffusers import QwenImage21Pipeline,这句能过,因为那只是导入一个类。要等到 from_pretrained 真的去加载 processor,缺的库才暴露。
换句话说:你装好环境、看到绿色的「安装完成」、下完 31 GiB、点了生成,才第一次看见这个错。**导入级的检查挡不住加载级的依赖。**我现在把 torchvision 加进了依赖清单,并且在安装后那道检查里补了一句 import torchvision——能在装完当场问的,就别留到用户点生成时。
第二个坑:两个模型的同一个参数,名字不一样
建议 装上 torchvision,流水线加载成功了。再点,换了个错:
TypeError: QwenImage21Pipeline.__call__() got an unexpected keyword argument 'guidance_scale'
建议 我去读了签名,对比很干净:
| 流水线 | 引导参数 |
|---|---|
ZImagePipeline |
guidance_scale |
QwenImage21Pipeline |
true_cfg_scale,没有 guidance_scale |
而我的代码里写死了前者。Z-Image 一直正常,所以这个假设从没被质疑过。
修法我选了「问签名」而不是「按模型名分派」:程序去读流水线 __call__ 的实际参数表,看它认哪个名字就传哪个。这样将来再进第三个流水线,这里不用再改。
顺带一个值得知道的细节:true_cfg_scale 的默认值是 1.0,而且官方文档写得很直接——这个模型 meant to be sampled without guidance,本来就该不加引导采样,要大于 1 并且带负向提示词才会真正启用。我第一次测试时手贱传了 4.0,它直接回了一句提醒说没有负向提示词所以没启用。这说明我的参数默认值对这个模型偏高,但我这轮没改——那是用户可调的设置,改默认值影响面超出这次范围。
第三个坑:我改对了代码,但改错了地方
改完参数名,自己写了个小脚本测,一次通过。高高兴兴接到应用里,再点生成——
name 'inspect' is not defined
我加的那个 import inspect 在服务端文件的开头。但真正跑生成的不是服务端,是它拉起的一个 worker 子进程,那段代码作为一个独立字符串传给 python -c,不共享服务端的任何 import。
这个坑让我记了一笔:我自己写的复刻脚本永远测不出它,因为复刻脚本里压根没有「子进程」这一层。一个只在真实路径上存在的结构,只能在真实路径上测。改完之后重跑本体,69 秒出图。
图怎么样:中文是它的主场
四张图都是 1024×1024、28 步,提示词一次成型,没有反复抽卡。
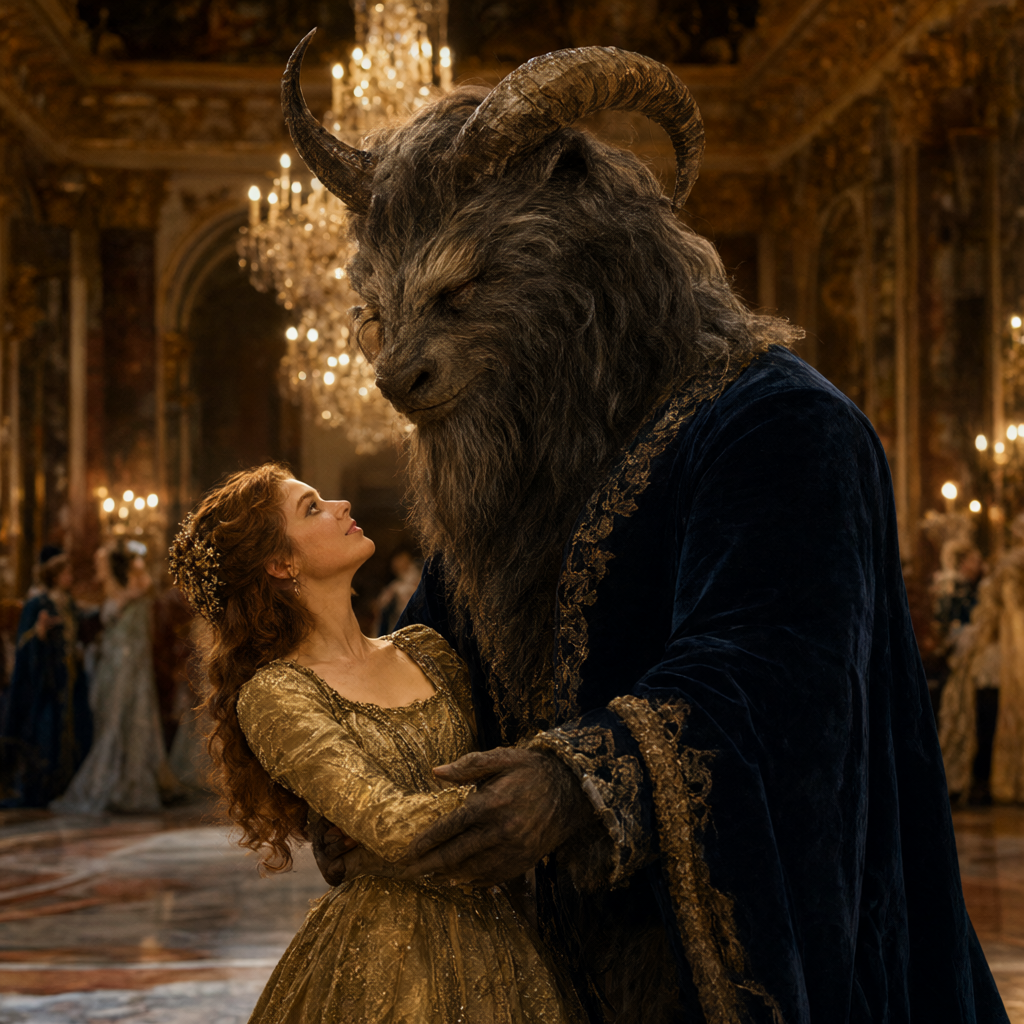
美女与野兽这张是纯粹的画面能力:兽角的弯度、鬃毛的层次、金裙的织物反光、背景舞者的景深虚化,都没有塌。
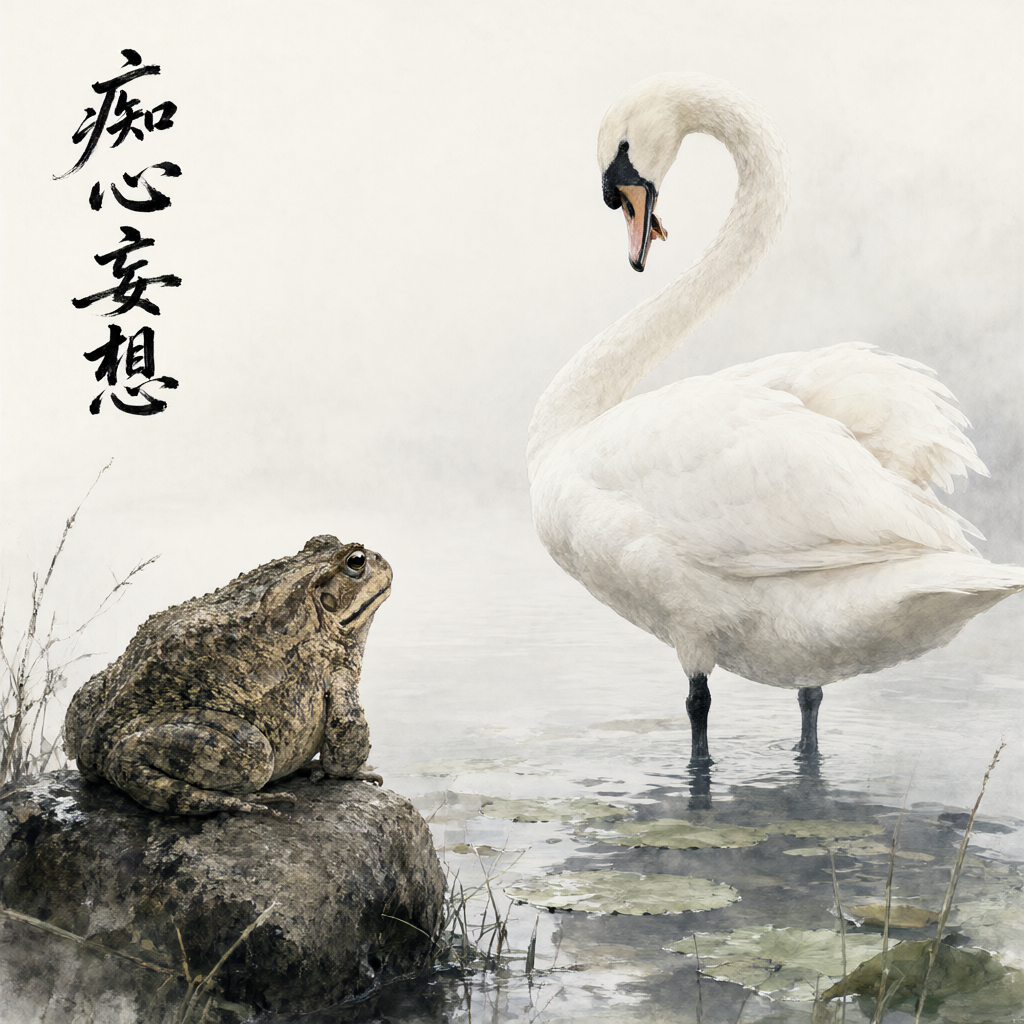
这张才是我眼睛一亮的地方。左上角那四个毛笔字——「痴心妄想」,一个不错,竖排,笔锋和飞白都在。我用过不少文生图模型,中文写到四个字还能全对的不多,更别说写成书法。
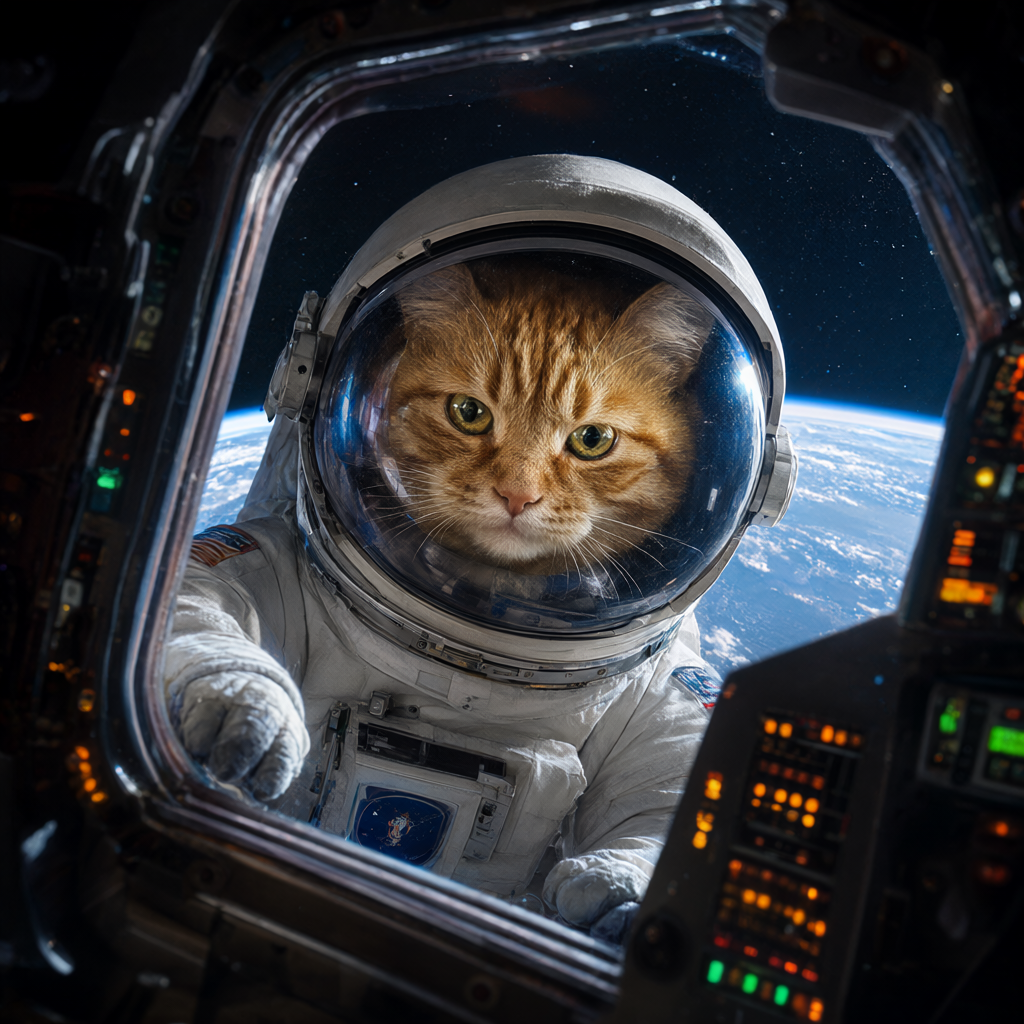
宇航猫用来看质感:面罩上地球的反光、舱内仪表盘的橙绿微光、猫瞳的高光,三层光源没有互相打架。
也有没做到的。那张牌匾我要求右下角小字竖写「本地部署」,它给了横写。四个大字完全正确,小字位置也对,就是排布方向没听。这一条我不打算含糊过去:它的中文很强,但不是指哪打哪。
参考图:它其实是「一个流水线两种活」
接下来是我这次专门去核实的部分。Qwen-Image-2.1 的 __call__ 里有一个 image 参数,读源码文档串写得很清楚:
One or more condition images……encoded by the text encoder as vision context and by the VAE into latent tokens prepended to the noise.
三件事:可以多张;参考图走两条路(文本编码器当视觉上下文,VAE 编成潜在 token 拼在噪声前面);传列表表示「整批共享的一组图」,不是一张图对一条提示词。
另外一条很实用:不指定尺寸时,输出跟随参考图的宽高比(文档原话是 Derived from the condition image’s aspect ratio if omitted)。
我拿一张已经生成的橘猫图当参考,要求换到雪地里:
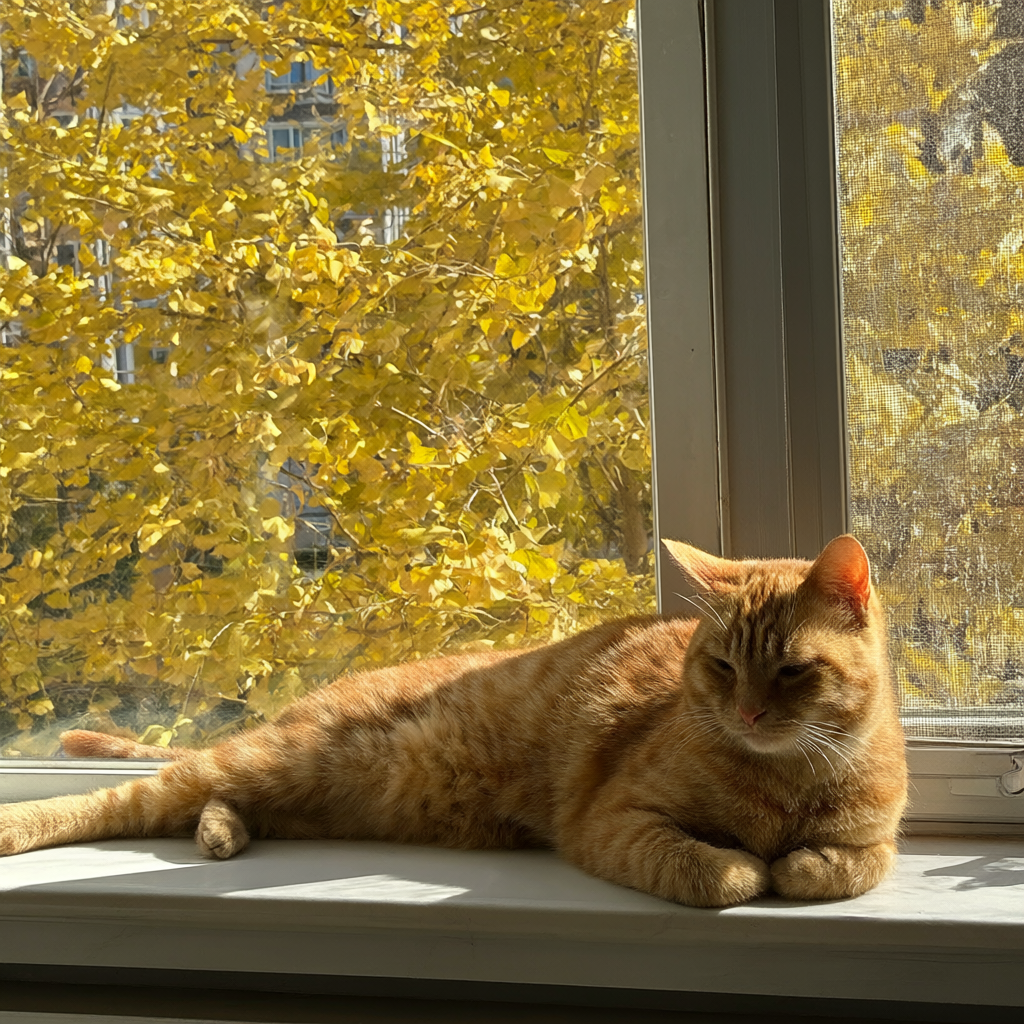
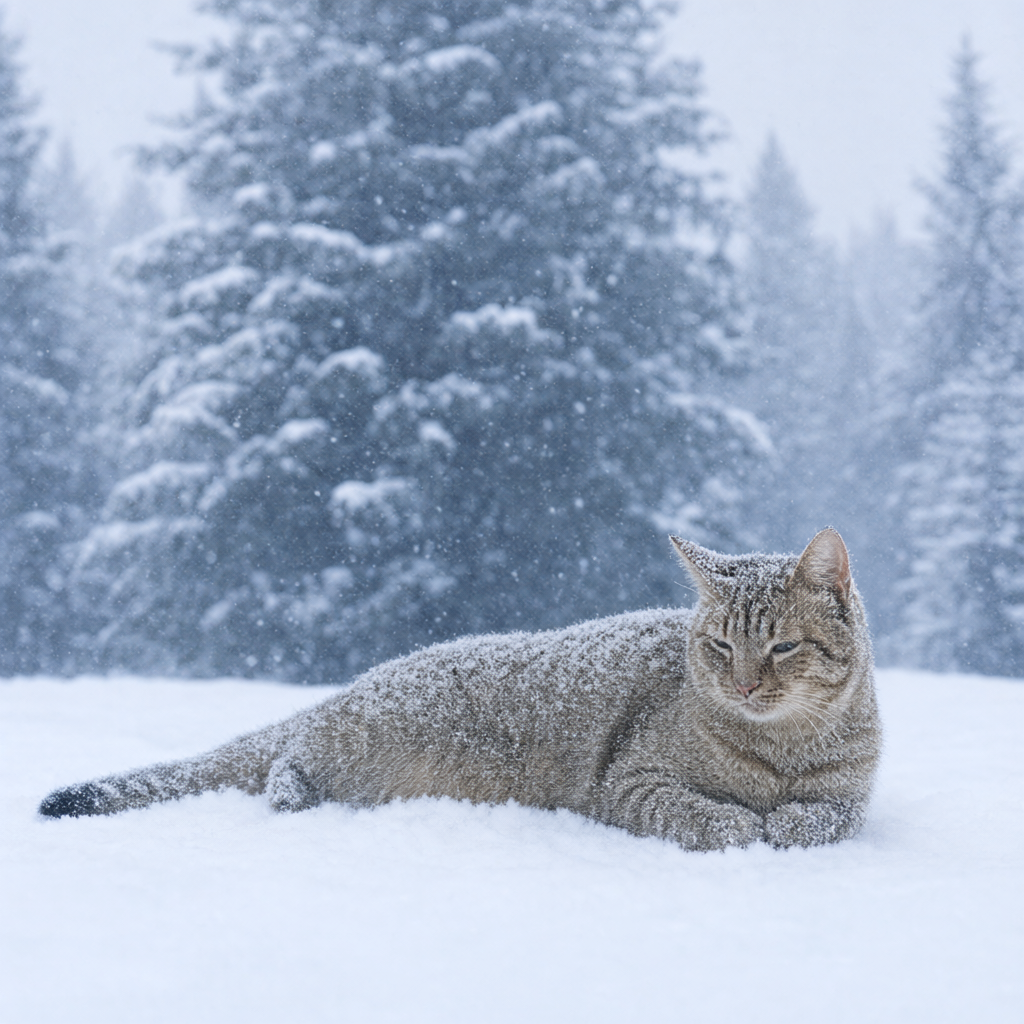
82 秒。姿态、身形、尾巴的摆法、眯着眼的神态都带过来了,场景按提示词换掉了,毛上还落了雪。色温被雪景拉冷了一档,橘色没有刚才那么明显——花纹还认得出,但「保持同一只猫」这个要求,它完成得不算满分。
🎯 官网列了四条改进,我挑能当场验证的三条跑了一遍
这篇原来只回答了一个问题:**它能不能在我的机器上出图。**但官方模型卡里列的四条改进,有三条是功能性的、可以当场验证的——原生透明、修图、多张参考图。下面逐条跑,参数沿用前面那套基线(1024×1024、20 步、seed 42),跑的是方寸智匣装好的同一份权重。
| 官方原话 | 本机实测 |
|---|---|
| Native Transparency —— 从文本直接生成常规或透明(RGBA)图像,编辑透明图层,从照片里抠主体 | 成立。直出 RGBA,约 80 秒;透明区占 43.5%(判据见下) |
| Versatile Editing —— 支持最多 10 张参考图,可用画圈、涂注或单独的蒙版指定局部修改,并保住人物与商品的身份 | 参考图两张可用(86.5 秒);但这版 diffusers 管线没有 mask 参数,画圈涂注这条我走不通 |
| Compact and Efficient —— 视觉生成部分只有 7B 参数(32 层单流 DiT) | 权重 30.8 GiB、加载 11–15 秒,与原文一致;修图一张 78.8 秒 |
| Realistic Textures —— 排版、人像光线和细节更好 | 中文四字书法原文已验证;这次不重复 |
左栏是模型卡原文的中译,右栏是本机 M5 Pro / 64 GB 的单次结果,不外推为批量稳定
官方自己的范例长这样——左边是原生透明生成,右边是用六张人像参考合成的群像。这两张是官方的,不是我跑的,放在这里是为了说明它宣称的上限在哪:
① 无背景:alpha 不是 0,是 1
透明这条有个官方推荐的提示词格式,要照抄,别自己发挥——原文是:「This is an RGBA image with transparency. …… The image has alpha channel and the background is transparent.」把要画的东西夹在中间就行。
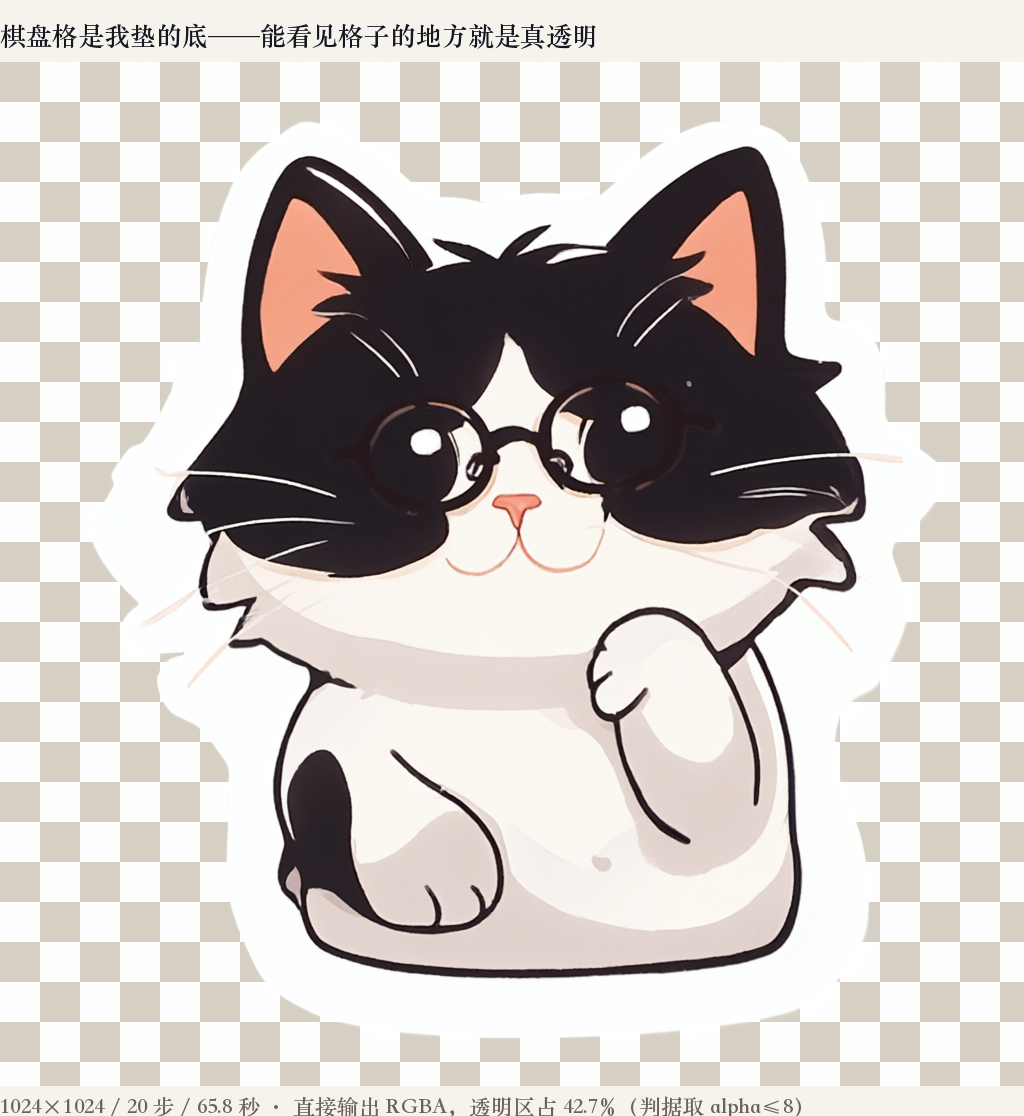
**这一项差点被我自己的判据判死。**第一次统计我数的是「完全透明的像素」(alpha 严格等于 0),结果只有 0.6%,看着像功能根本没生效。翻直方图才发现:44 万个像素落在 alpha = 1,不是 0——模型给的是近乎全透明,而不是硬零。判据改成 alpha ≤ 8,透明区立刻变成 43.5%。
建议 **做本地实测,最容易翻车的往往不是模型,是自己写的那把尺子。**这次如果只看第一版数字,我会写出「透明功能基本没用」这种结论,而它其实好好的。数字反常的时候,先怀疑判据。
② 修图:只让它换背景,猫不许动
修图就是把原图塞进 image=,提示词只说要改什么。我拿这篇文章早先生成的那张橘猫图当输入,指令是「把背景换成黄昏的雪松林,猫保持不变」:
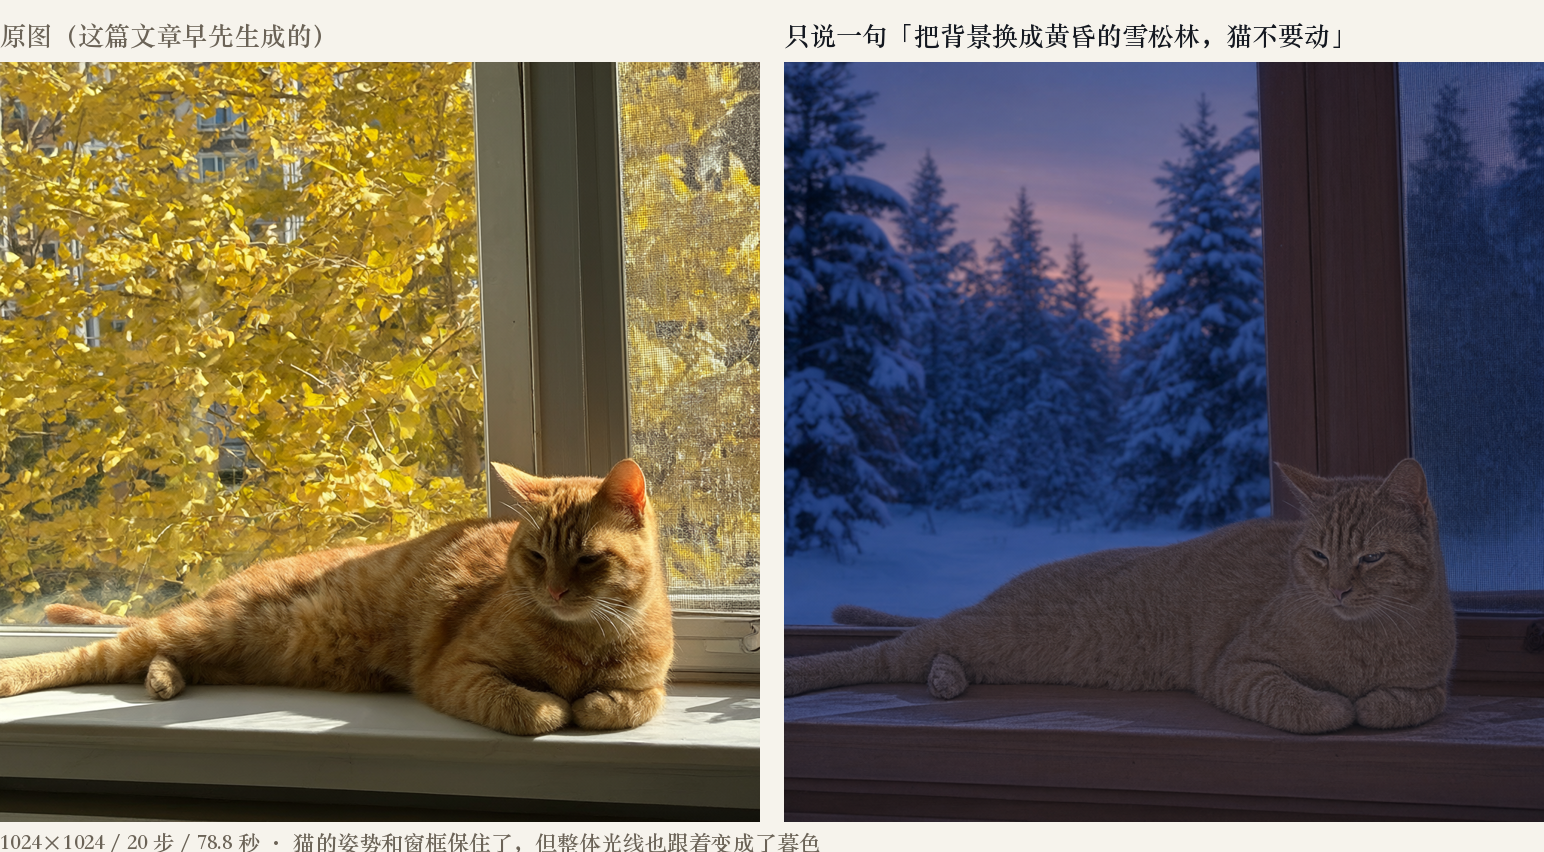
猫的姿势、爪子的位置、窗框的透视都保住了,背景换成了雪松林。但要诚实说一句:**它不只换了背景。**整张图的光线跟着变成了暮色,猫身上的暖光没了。从「黄昏」这个词看这是对的,可如果你要的是纯粹的背景替换、前景一点不动,这一版给不了——官方说的画圈和蒙版才是干这个的,而那条路我走不通:这版 diffusers 管线的参数表里只有 image、negative_prompt、true_cfg_scale、height、width,没有 mask 相关入参。
③ 参考图:这次真的喂了两张
原文在这一节留了个尾巴:「参考图我只测了单张。文档说支持多张,我核实了参数类型接受列表,但没有真的喂两张进去看效果。」现在补上——image= 直接传一个列表就行。
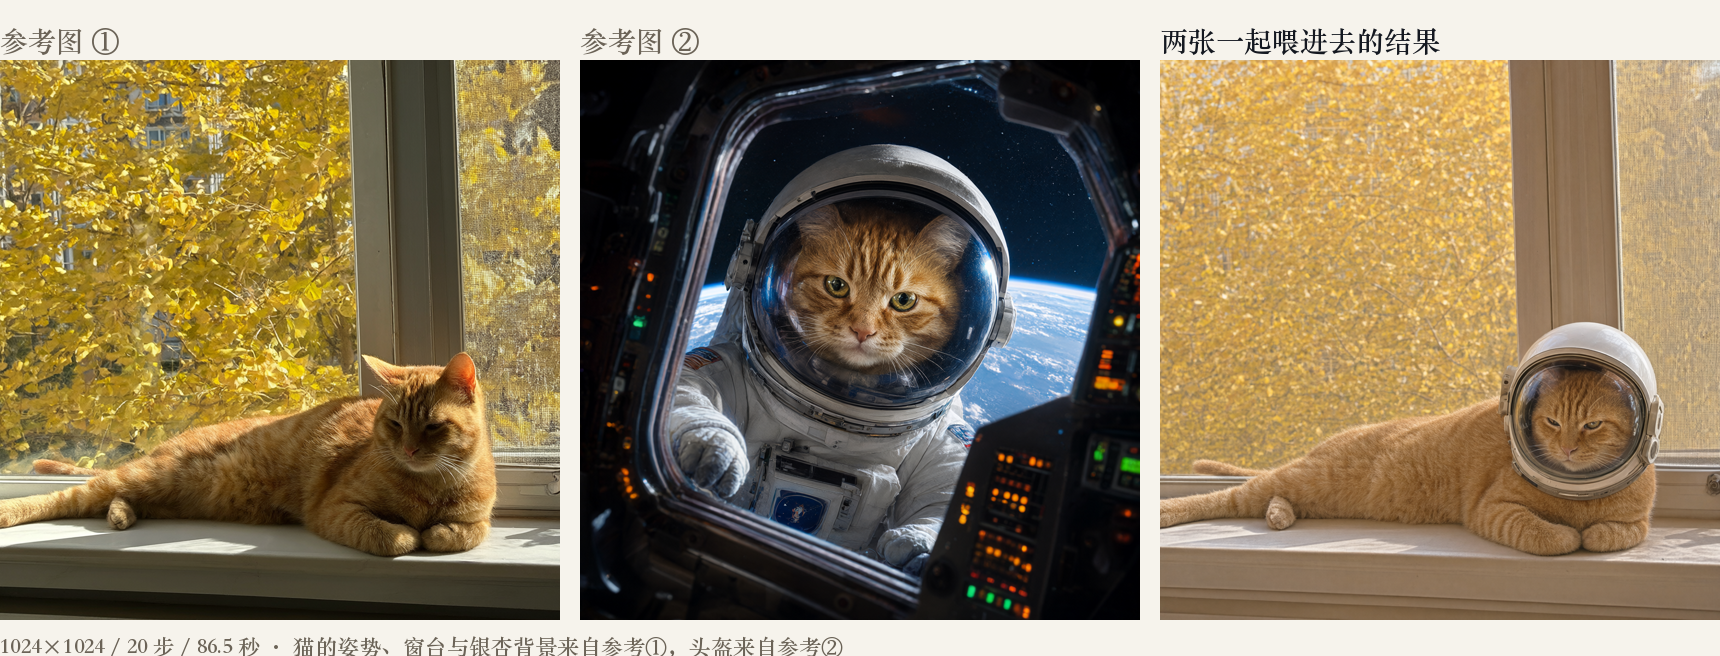
同样一张图、同样 20 步,只给一张参考图是 71.7 秒,给两张是 86.5 秒——多一张参考图要多付 21% 的时间。
④ 五次生成里有两次是空的,原因不是模型
把上面这些跑下来,我一共发起了五次生成,其中两次返回的是整张全透明的图(alpha 全为 0,文件只有 4 KB)。第一反应是「多图不支持」,第二反应是「提示词里写了 sticker 所以它给了透明贴纸」——两个都不对。
把五次按进程排一下,规律就出来了:每个进程只有第一次生成是好的。
| 进程 | 本进程第 1 次生成 | 本进程第 2 次生成 |
|---|---|---|
| 进程一 | ① 透明贴纸 ✅ | (脚本报错中断) |
| 进程二 | ② 修图 ✅ | ③ 全透明空图 ❌ |
| 进程三 | ④ 两张参考图 ✅ | ⑤ 单张参考图 全透明空图 ❌ |
| 进程四(专门验证) | 同一条提示词第 1 次 ✅ 有画面 | 同一条提示词第 2 次 ❌ 全透明空图 |
与提示词、参考图张数、是否透明都无关;只和「这是本进程第几次生成」有关
为了坐实,我又开了一个进程,用完全相同的提示词、相同的参考图、相同的种子连跑两次:第 1 次出了画面(RGB 均值 137.1),第 2 次整张全透明(RGB 均值 0.0)。变量只剩「第几次」这一个。
建议 **所以这不是模型能力问题,是这版管线在 MPS 上的状态问题。**实用办法很笨但有效:一个进程只生成一张,或者每次重新构建管线。方寸智匣里每次生图都是独立的一轮,正好绕开了它——这也解释了为什么原文一路测下来没撞上。
警告 **差点写成两条错误结论。**先是「多图不支持」(实际两张一次就成),再是「提示词提了 sticker 所以透明」(实际换成 photographic 的提示词照样空)。两次都是我拿单次结果去解释现象,而没有把变量固定住重跑一遍。异常先别急着归因,先做单变量对照。
🔁 第二遍:换成人像,因为官方那三条说的就是人
上面那一轮用的是猫和贴纸。跑完才反应过来:官方模型卡写的是「人像与商品保真」「人物光影」「文字排版」——**这三条,猫一条都验不了。**所以隔了几天又跑一轮,主体全换成人,参数换成 40 步、832×1248 竖版,走方寸智匣内置的 image_server.py 常驻服务,不再直连脚本。
透明:这次是整个人,连裙摆拖尾
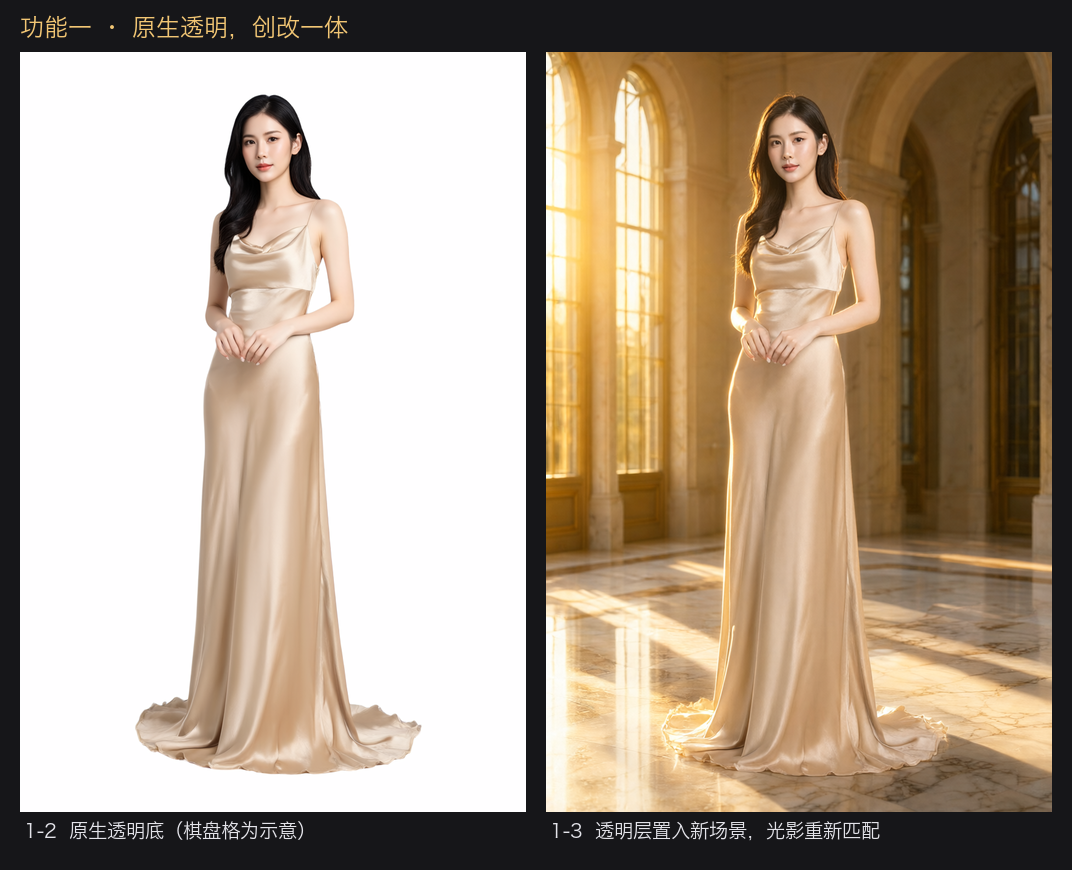
贴纸好抠,人不好抠,难点在发丝和半透明织物。左边是直出 RGBA 垫上棋盘格:alpha ≤ 31 的透明区占 76.5%,主体(alpha ≥ 224)占 23.1%,中间过渡带只有 0.4%。过渡带这么窄,说明它给的是一张干脆的蒙版,不是糊成一片的软边。
右边是把这张透明图当参考图、要求置入洒进阳光的大理石中庭。它不只是垫了个背景:左侧窗的暖光重新打在人身上,地面有投影,大理石有反射。这是第一轮用猫时看到的同一个行为——换背景会连光一起换——这次它换对了。
人像保真:耳坠是最好的证人
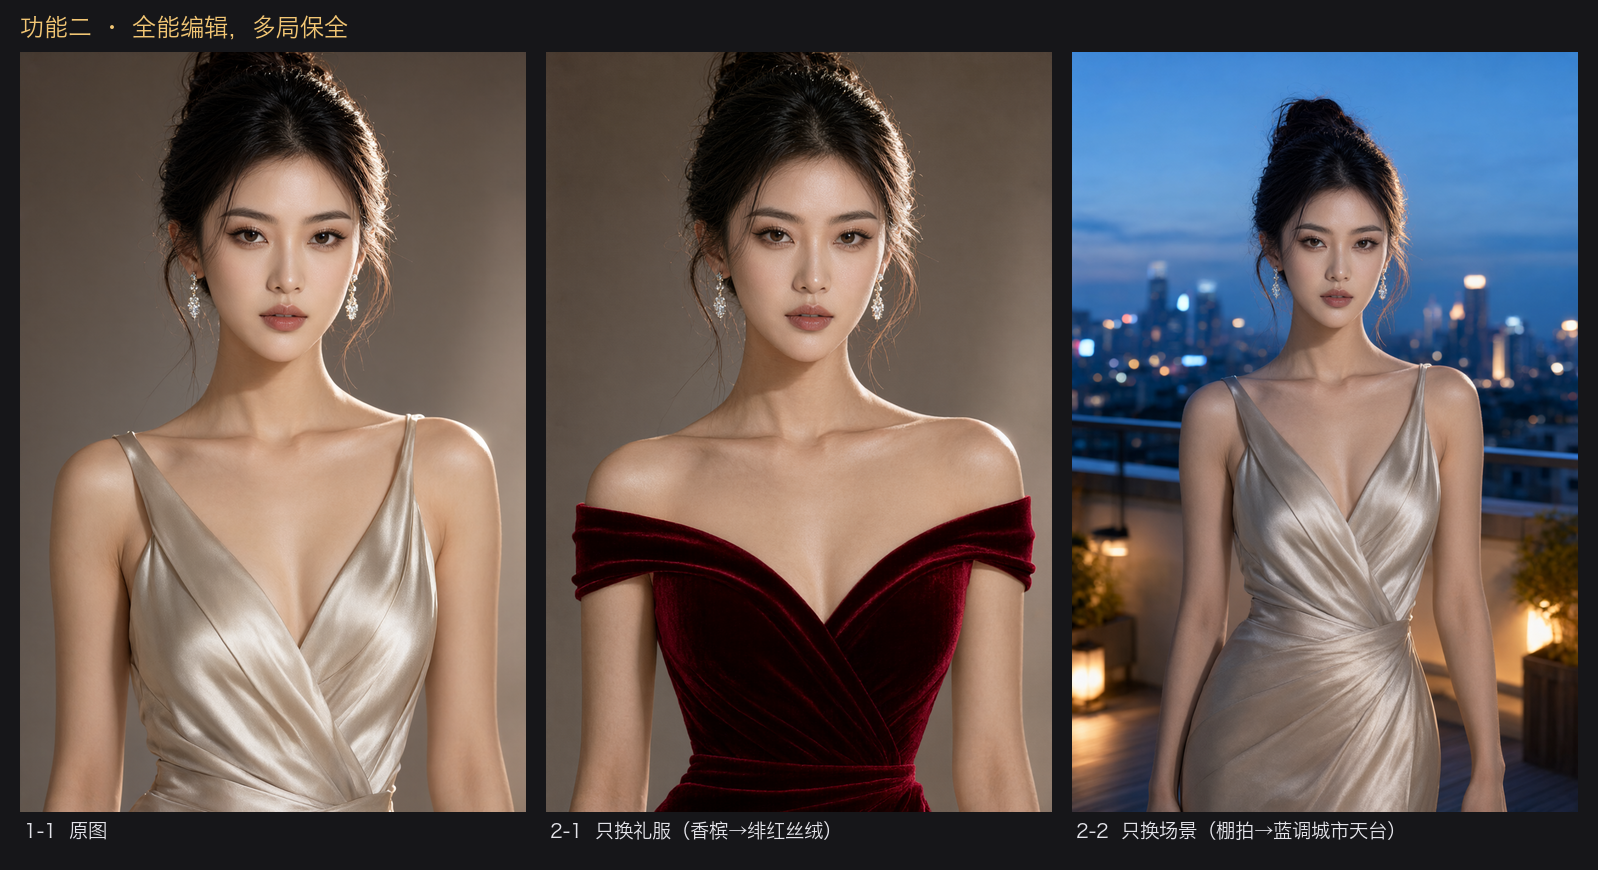
两条指令分别是「只把香槟丝绸换成绯红丝绒,其余不动」和「只把棚拍换成蓝调城市天台」。全幅看,改的地方确实改了;要看没改的地方,得放大到脸:
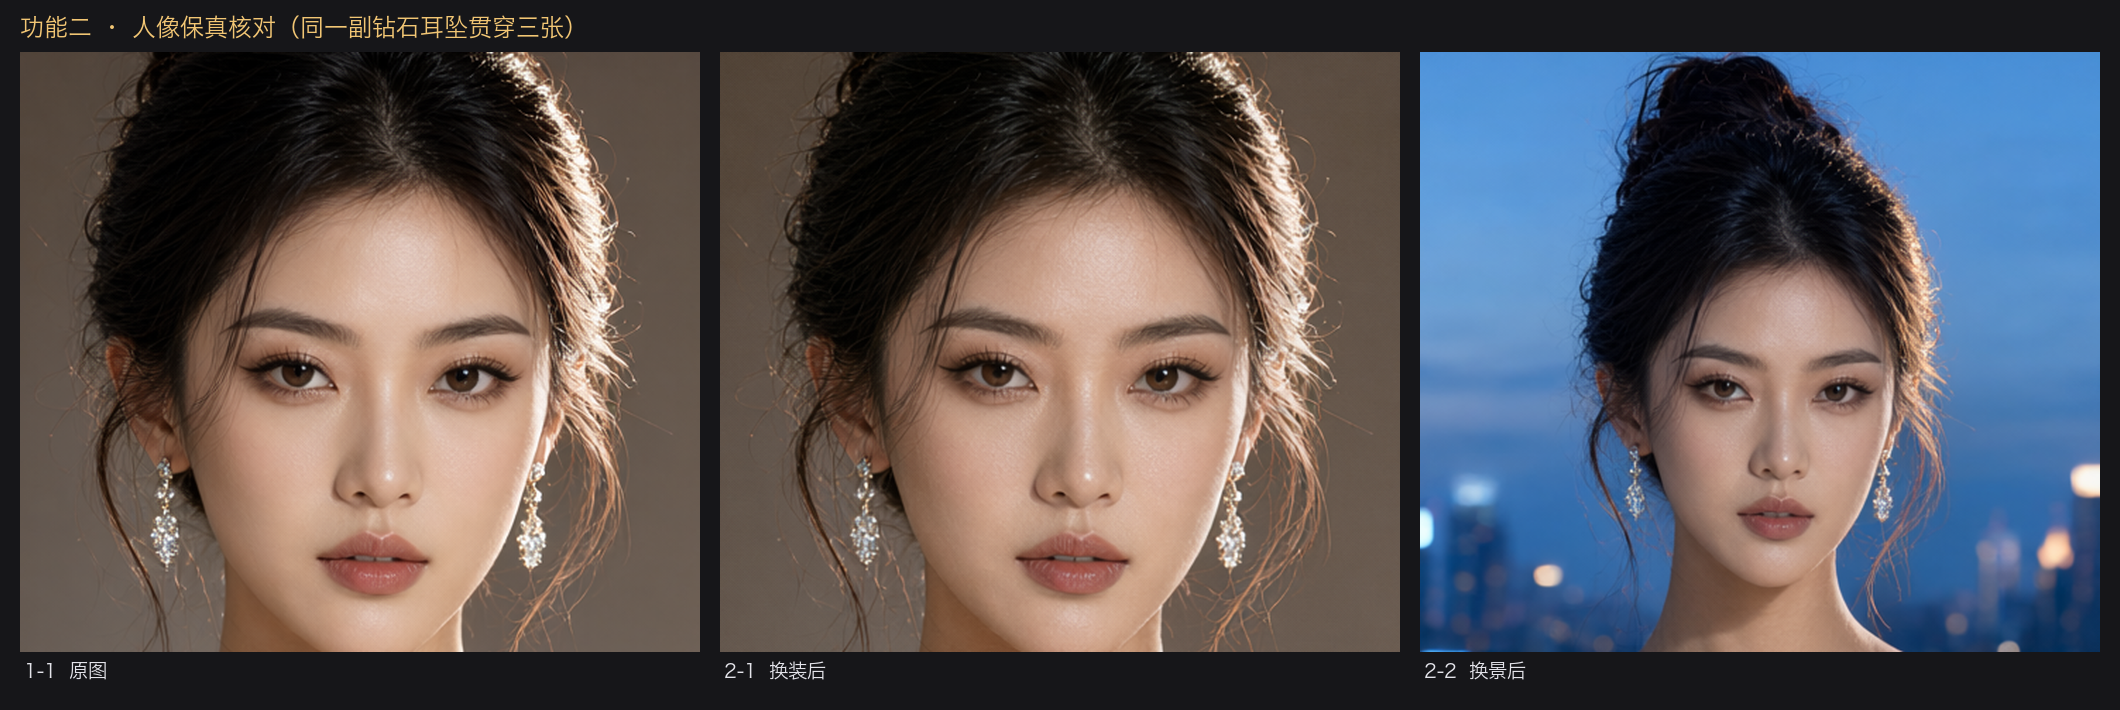
放大到脸看:五官结构、发髻、碎发走向都对得上。**最能说明问题的是那副钻石耳坠——三张里是同一副,连坠子的分叉都没变。**这种小面积高频细节最容易在重绘里丢掉,它没丢。
商品保真:我先判它不行,然后发现是我给的画面太小
这一条我差点写错。
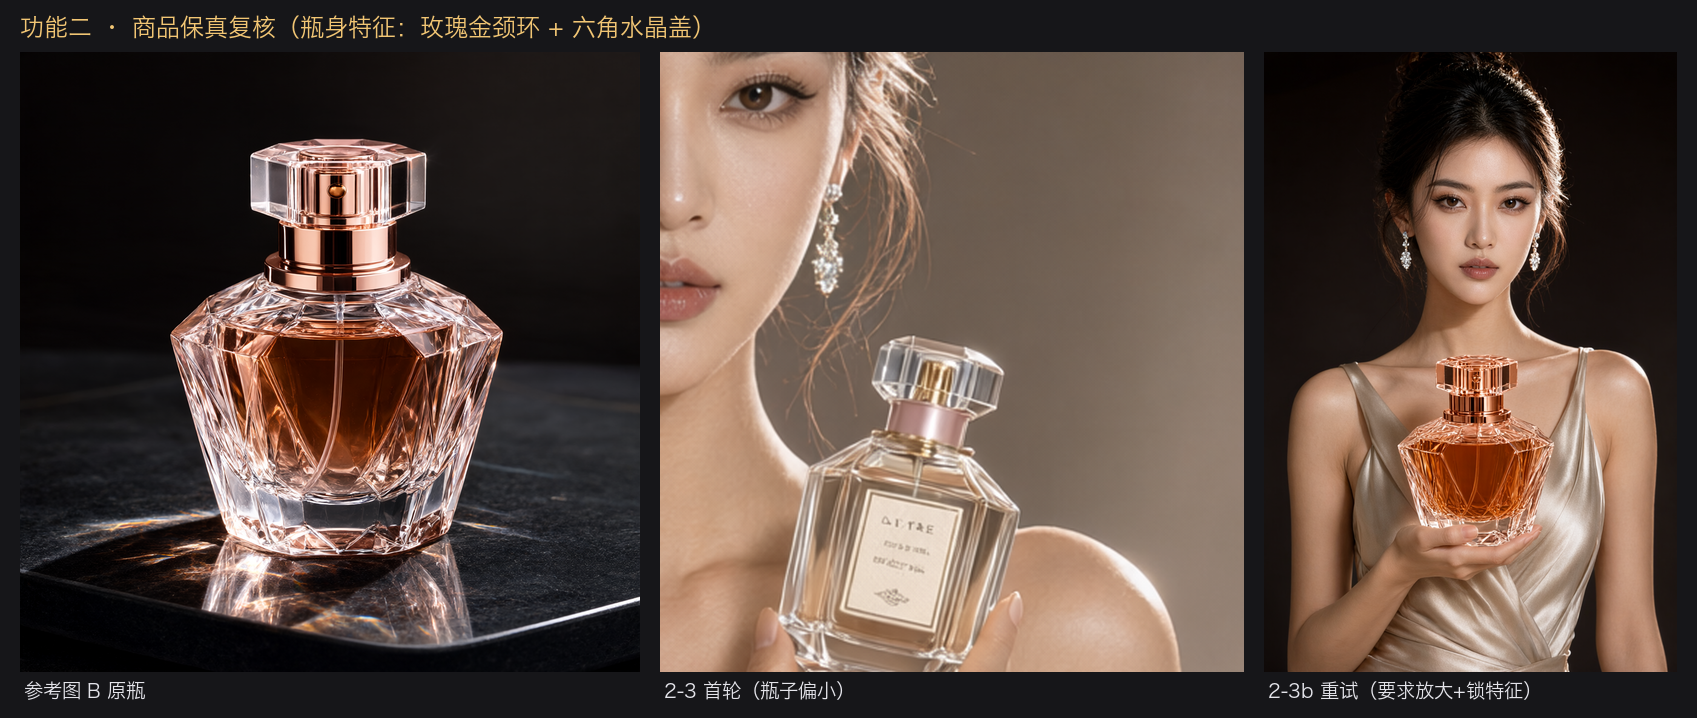
参考瓶的辨识特征有两个:玫瑰金颈环和大六角水晶盖。第一次我让模特把瓶子拿在肩侧,出来的瓶子小了一圈——颈环没了,盖子变成银白小盖,还凭空多了张标签,两个特征全丢。只看这一次,结论就是「人像保真成立,商品保真不成立」。
但瓶子在画面里只占那么一点,拿这个判模型不公平。于是同样两张参考图重喂一次,只改两件事:**要求瓶子放大到胸前,并在提示词里把颈环和六角盖写死。**右边这张,玫瑰金颈环回来了,六角切面盖回来了,琥珀色液体和无标签也对,人像同时还保着。
建议 **所以「商品保真」不是是非题,是尺寸题。**同一个模型、同两张参考图,商品在画面里占多大,直接决定它保不保得住。要拿它做电商图,别让商品缩在角落。
字雅人美:三种版式,中文一个字没崩
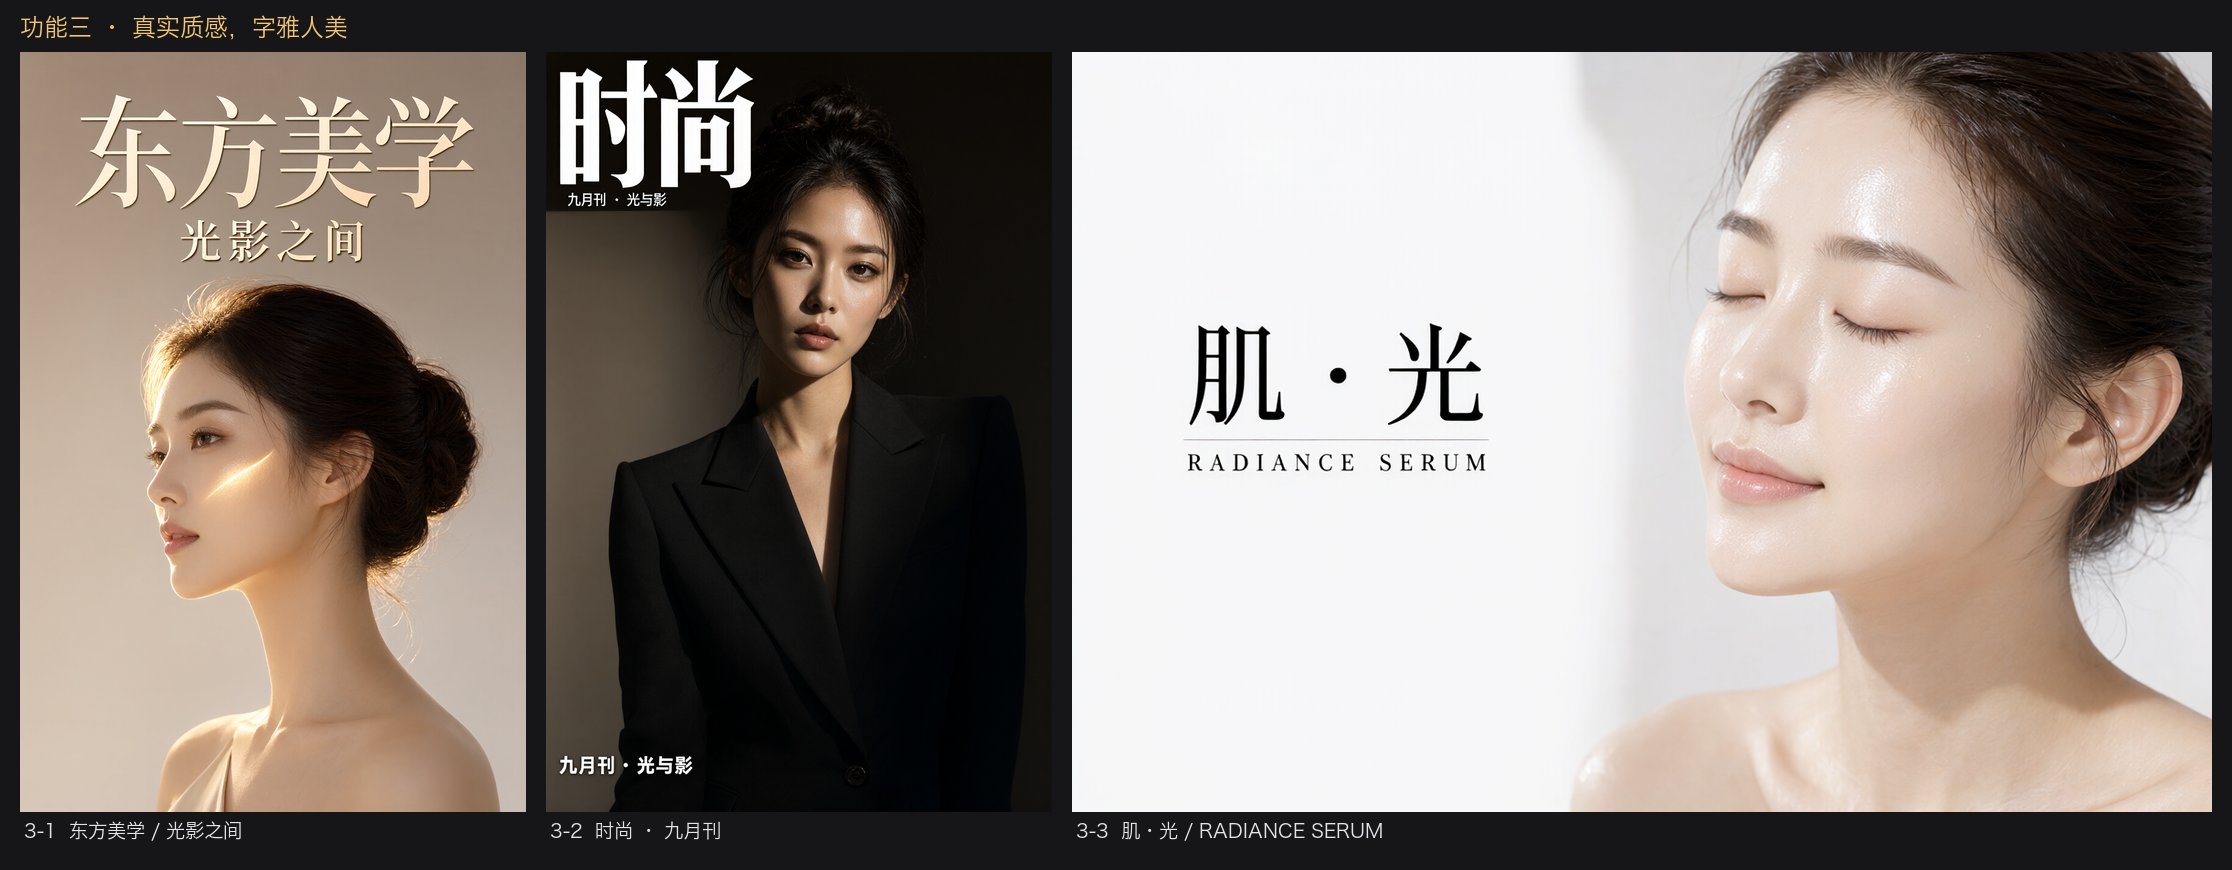
原文只验过一块牌匾四个字。这次换三种真实版式:海报大标题「东方美学」配副标「光影之间」,杂志刊名「时尚」配封面线「九月刊 · 光与影」,横版产品广告「肌 · 光」配英文副行「RADIANCE SERUM」。十九个汉字全部正确,字距、衬线粗细、中英混排的基线对齐都是能直接拿去用的水平——最后那张它甚至自己在中英文之间补了一条分隔细线。
要挑毛病有一处:杂志封面那张我只要求左下角放一行封面线,它在刊名下方又放了一行同样的字。这是版式冗余,不是字形错误。
第四个坑:参考图只收路径,不收 base64
image_server.py 的参考图入参只接受本机绝对路径。我按 OpenAI 那套习惯把图编码成 data:image/png;base64,... 传过去,服务端拿它做 os.path.isfile(),判不存在,返回 400。翻到源码那行注释才明白这是故意的:
只收本机路径——这个服务只在 127.0.0.1 上、只服务本机调用方,没有理由再解一层 base64,那会让请求体涨到几 MB 并且把解码失败混进生成失败里。
理由站得住。只是错误信息停在一个光秃秃的 400,调用方分不清是「格式不对」还是「图真没了」。
顺带修正上一轮的两个数
**第一,空图那个 bug,这一轮没再出现。**走 image_server.py 常驻服务连跑十三张,其中多次带参考图,没有一张是空的。上一轮那条「一个进程只生成一张」的土办法,对直连脚本成立;对方寸智匣走的常驻服务这条路,看起来不需要。
**第二,上一轮那句「多一张参考图要多付 21% 的时间」站不住。**翻回执才发现,被当成单张基线的那次(71.7 秒)产出的正是一张空图(rgb_mean 为 0.0)——拿一次失败的生成当基线,这个 21% 算不得数。顺手补了个更基本的对照:同一条提示词、同一个种子跑两次,输出的 SHA-256 完全相同,耗时却是 79.7 秒和 129.6 秒,差了 63%。单次计时在这台机器上的噪声就有这么大,所以本文所有秒数只当量级看,别拿去算百分比。
在方寸智匣里怎么用这三项
上面三项我是直连权重跑的,方便留回执。日常用不用这么麻烦——在方寸智匣里,主页或多媒体工具的「启动模型」下拉里选 Qwen-Image-2.1,生图面板下方可以添加参考图;透明就在提示词里照抄官方那句格式;修图把原图加进参考位、提示词只写要改的部分。
警告 **耗时口径要分清。**上面的 65.8 / 78.8 / 86.5 秒是模型本身在这台机器上的成本,不含界面排队、资源仲裁和模型热身。在应用里点一次,观感会比这个数慢——那部分是应用的账,不是模型的账。
这些能证明什么,不能证明什么
**能证明的:**在 M5 Pro、64GB、bf16 这套条件下,它能稳定出 1024×1024 的图,20 步 69 秒;中文四字书法可以写对;参考图能把主体的姿态与神态带过去。
不能证明的,有四条我得主动说清楚:
第一,我没有做跨模型横评。我没在同一台机器上跑另一个文生图模型做同题对比,所以「它比谁强」这种话我说不了。
第二,一张图不能证明批量稳定。每种题材我只跑了一次,没有重复采样,也没有换种子复测。书法那张写对了四个字,不等于换四个字还能对。
第三,我没测量化版本。用的是官方那份 bf16 权重,31 GiB 就是 31 GiB。低内存机器上量化之后会掉多少,这轮完全没碰。
第四,参考图我只测了单张。文档说支持多张,我核实了参数类型接受列表,但没有真的喂两张进去看效果。接口通了,效果没验。
谁会为它买单,谁不会
这套账很直接。吃亏的是内存不够的人:31 GiB 权重加上激活,32GB 的机器基本进不来,48GB 勉强,64GB 才舒服。再加上它的文本编码器是个 8B 的视觉语言模型,这部分内存省不掉。
**沉默的一方是量化。**开放权重的发布方没有动机告诉你「这个尺寸在消费级机器上要怎么砍」,那是社区的活。等到有人放出质量可接受的量化版,这笔账才会被重算一遍。
还有一条时间线值得单独说,因为它直接决定你能不能装上:Qwen-Image-2.1 的支持(diffusers 的 PR #14804)在 2026-09-18 合进 main,而 diffusers 最后一个发行版 v0.40.0 是 2026-08-20——任何已发行版本都加载不了它。所以依赖必须钉在那个合并提交上,它自报的版本号是 0.41.0.dev0。文本编码器那边同理:Qwen3-VL-8B 要求 transformers ≥ 5.17,而 5.17.0 是 2026-09-09 才发行的。
**一个模型的「已发布」和「你装得上」之间,可以差出一个多月。**这段时间里任何按发行版装依赖的人,拿到的都是一句看不懂的报错。
想自己跑一遍
- 机器门槛:Apple Silicon、64GB 统一内存比较稳妥;bf16 权重 31 GiB,硬盘先留够。
- 依赖:diffusers 必须钉提交(发行版不行),transformers ≥ 5.17,别忘了 torchvision——它是这次最容易漏的一个,而且漏了之后的报错离真正原因很远。
- 参数:引导用
true_cfg_scale,默认 1.0 就好;这个模型本来就是设计成不加引导采样的。想用参考图就传image,不指定尺寸让它跟随参考图的比例。 - 在方寸智匣里:主页或多媒体工具的「启动模型」下拉里选 Qwen-Image-2.1,生图面板下方可以添加参考图,画幅选「跟随参考图」。所选模型不支持参考图时,后端会明确报错,不会悄悄把你的图忽略掉。
回到开头那个「卡了三次」。三次里有两次的报错文字,都指不到真正的原因——缺 torchvision 报的是一个视频处理类,改错层报的是一个用不上的变量名。**本地部署最贵的从来不是显存,是这种「报错和病因隔着三层」的时间。**这篇写出来,就是想让下一个装它的人少卡两次。
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
把 Mac 变成私有 AI 盒子:本地转写、配音、生图、视频和 MCP 工具一站管理。
本轮公开 Apple Silicon Mac 安装包。聊天模型现在可通过同一代理按需调用已集成的语音、转写、图像、图片编辑、音乐和视频工具,并把实际产物交给下一项工具继续处理。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
在 AI 面板打开「制作动画」,输入讲解及自己的要求,从三组19种风格方法中选择。模型结合当前内容设计主体、动作与镜头,生成可编辑的原生动画图层和关键帧。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取

留言
正在加载留言…