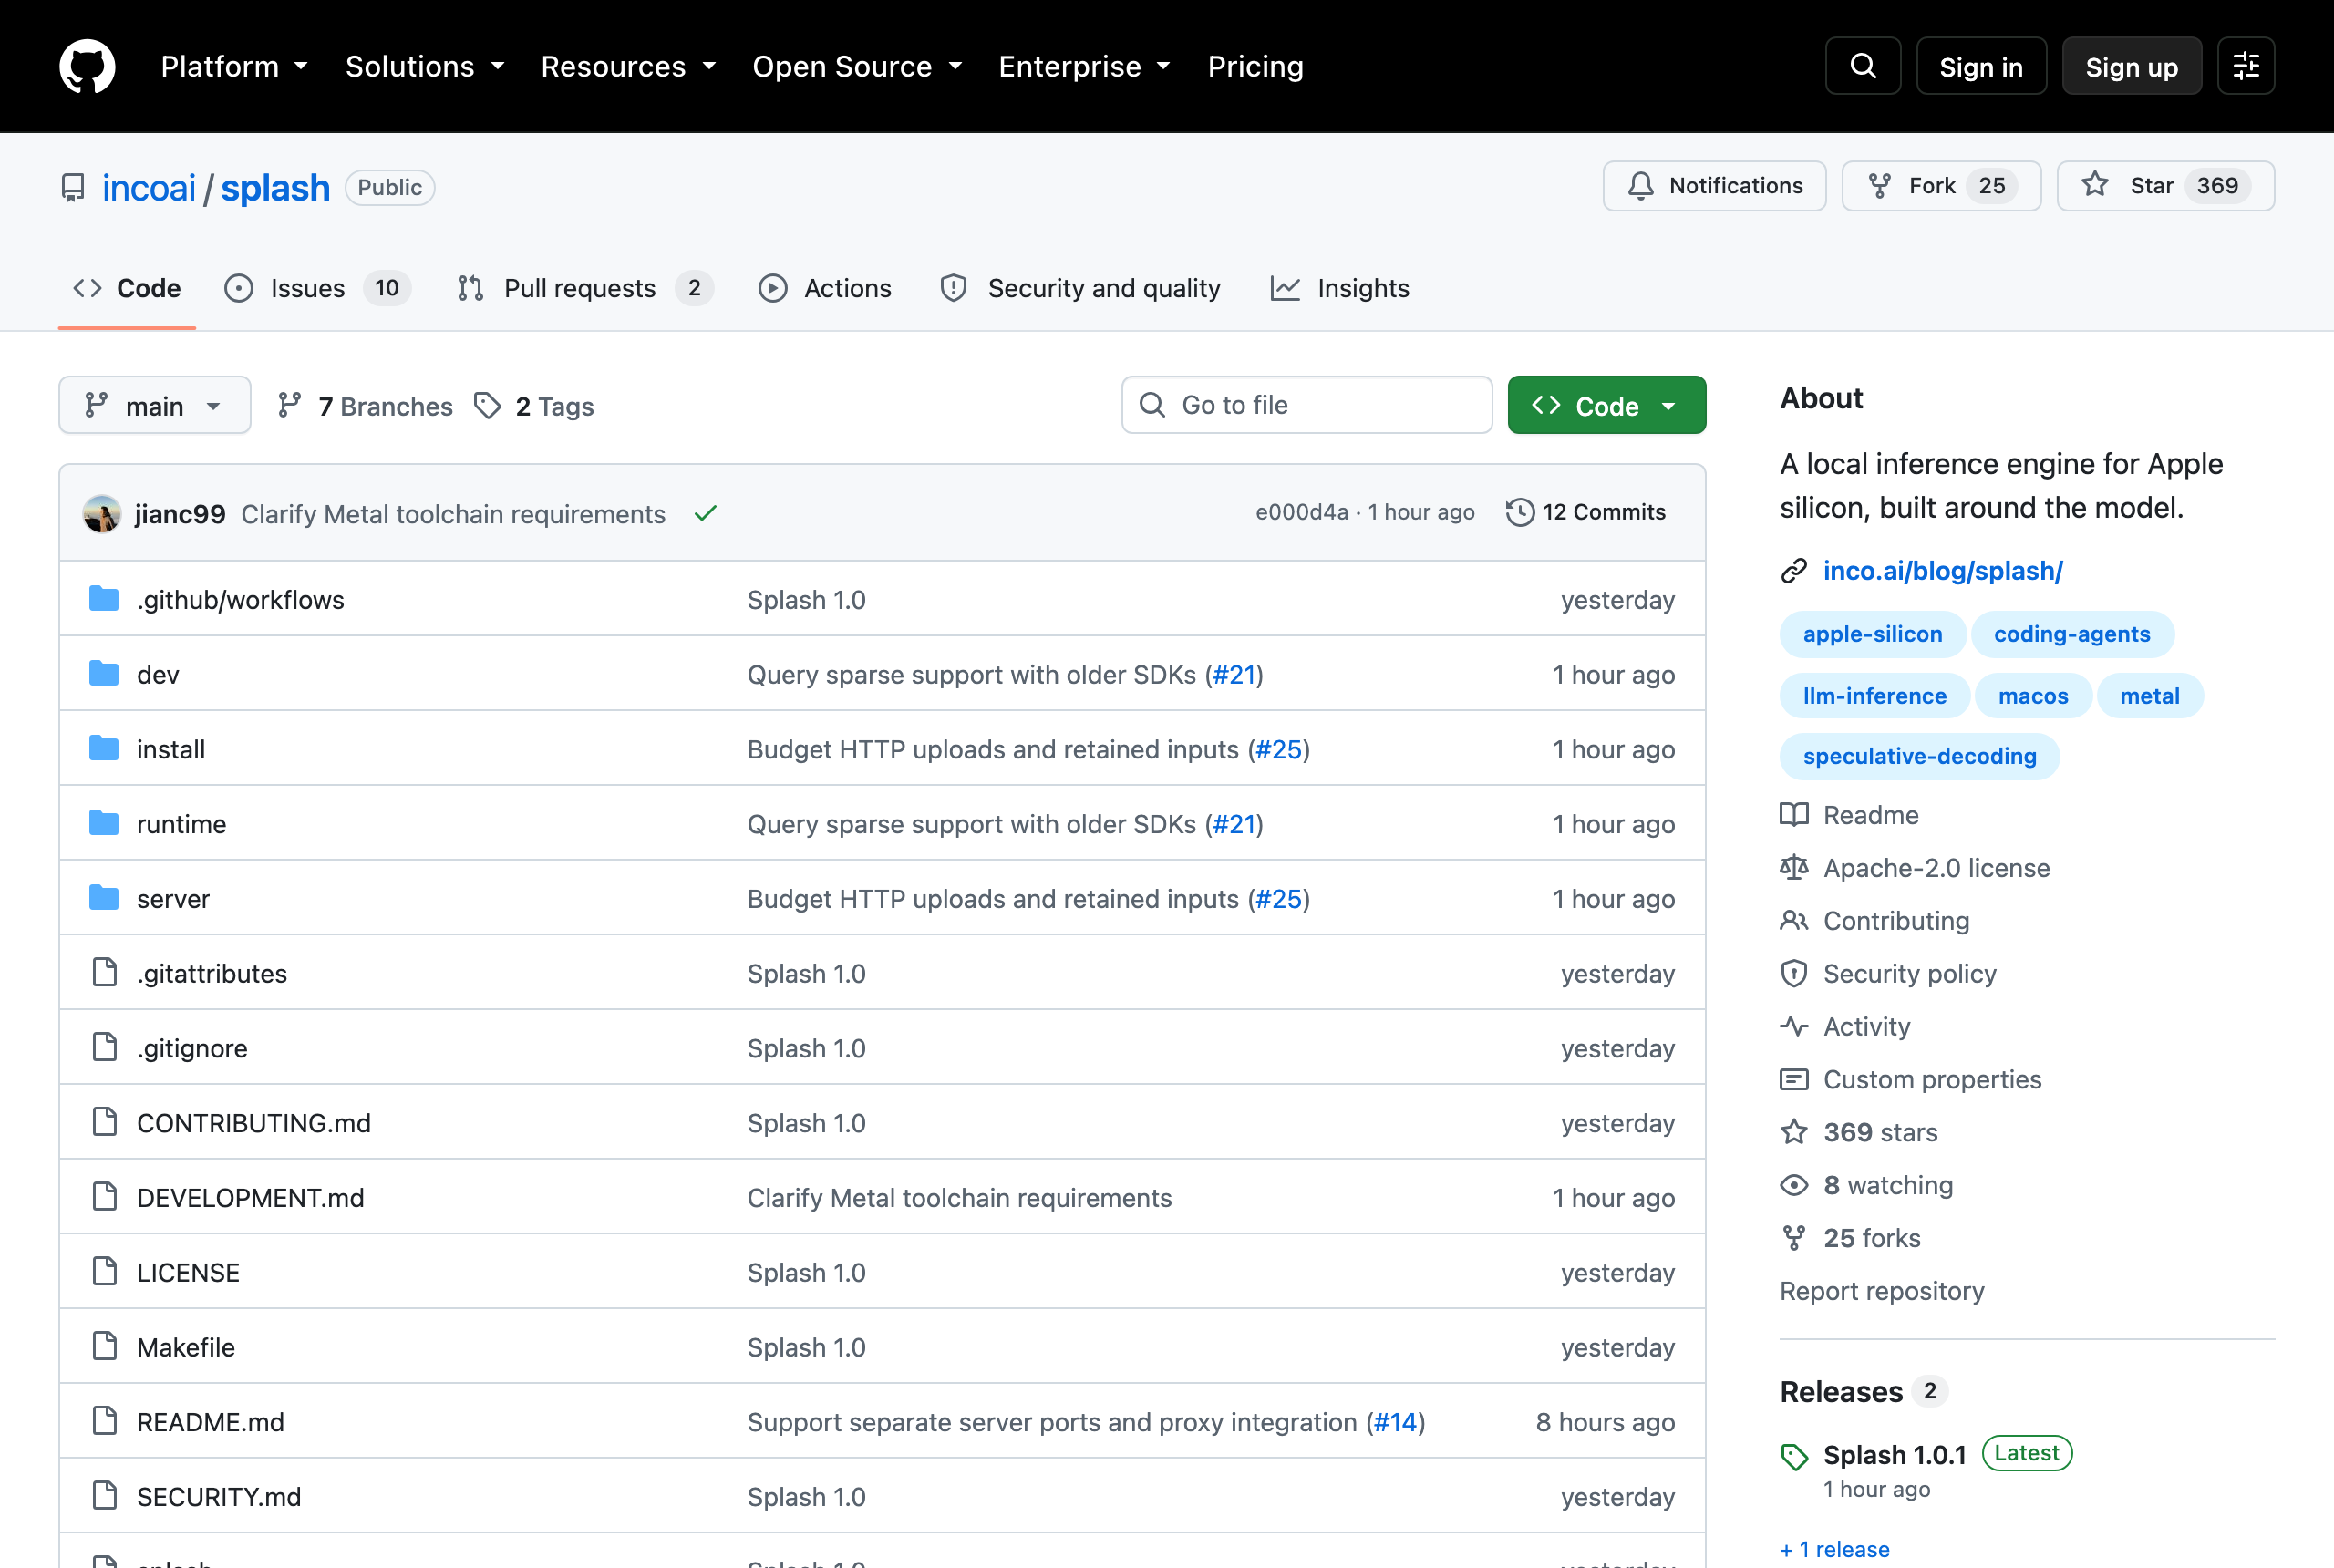
前天 Inco AI 开源了一个只给 Apple 芯片用的推理引擎,叫 Splash。README 第一段就把数字甩在脸上:48GB 的 M5 Pro 上,Qwen3.8-27B 的解码速度是次快引擎的 2 倍,32K 上下文缓存命中时首个 token 只要 282 毫秒。我装上测了一整天,结论先给:引擎是真的,那个 2 倍也不假,但我用它写中文稿子的时候,加速只剩 44%。同一台机器,同一个模型,同一个引擎,代码 79.3 tok/s,中文 25.6 tok/s,差 3.1 倍。
先说清楚:它的快是从哪来的
Splash 的快不是玄学,核心就一件事——投机解码。它给每个模型配了一个小得多的“草稿模型”,叫 DFlash 2,只有 5 层、1.18 GiB。生成的时候草稿先一口气猜 7 个 token,然后 27B 的大模型做一次前向计算,把这 7 个一起验证,猜对几个就白赚几个,猜错的从错的那位开始丢掉重来。
最接近的类比是输入法的候选联想。你打“投机解”,它给你补出“投机解码”,你一路回车就过去了;它补出“投机解释”,你就得退回来重打。猜得准的时候打字飞快,猜不准的时候比自己一个字一个字敲还累。这套赌法不新鲜,早在三十年前就躺在 CPU 里了——分支预测,预测对了流水线一路顺,预测错了整条流水线清空重灌。区别是 CPU 猜错只亏掉几个时钟周期,草稿模型猜错要把整块 7 个提议一起作废,代价大得多。
所以投机解码有个很硬的前提:你写的东西得可预测。这句话是后面所有数字的总开关。
实测:同一台机器差 3.1 倍
我的机器是 M5 Pro、20 核 GPU、64GB 统一内存、macOS 26.7,比 Inco 自己那台测试机(16 核 GPU、48GB)还好一档。brew install incoai/tap/splash 装完 213MB 的本体,再下 17.4GB 的模型包(另一个 35B 的包是 20.9GB)。启动日志里有一行值得注意:Kernel policy for GPU family 10 with 20 cores——它认出了我的 GPU 核数,选了对应的预编译 kernel 预设,9 秒加载完毕。内存账也摊得很明白:权重 14.12 GiB、草稿 1.18 GiB、视觉编码器 0.87 GiB,固定占用合计 17.86 GiB,剩下的 KV 缓存动态预算上限 32.94 GiB。
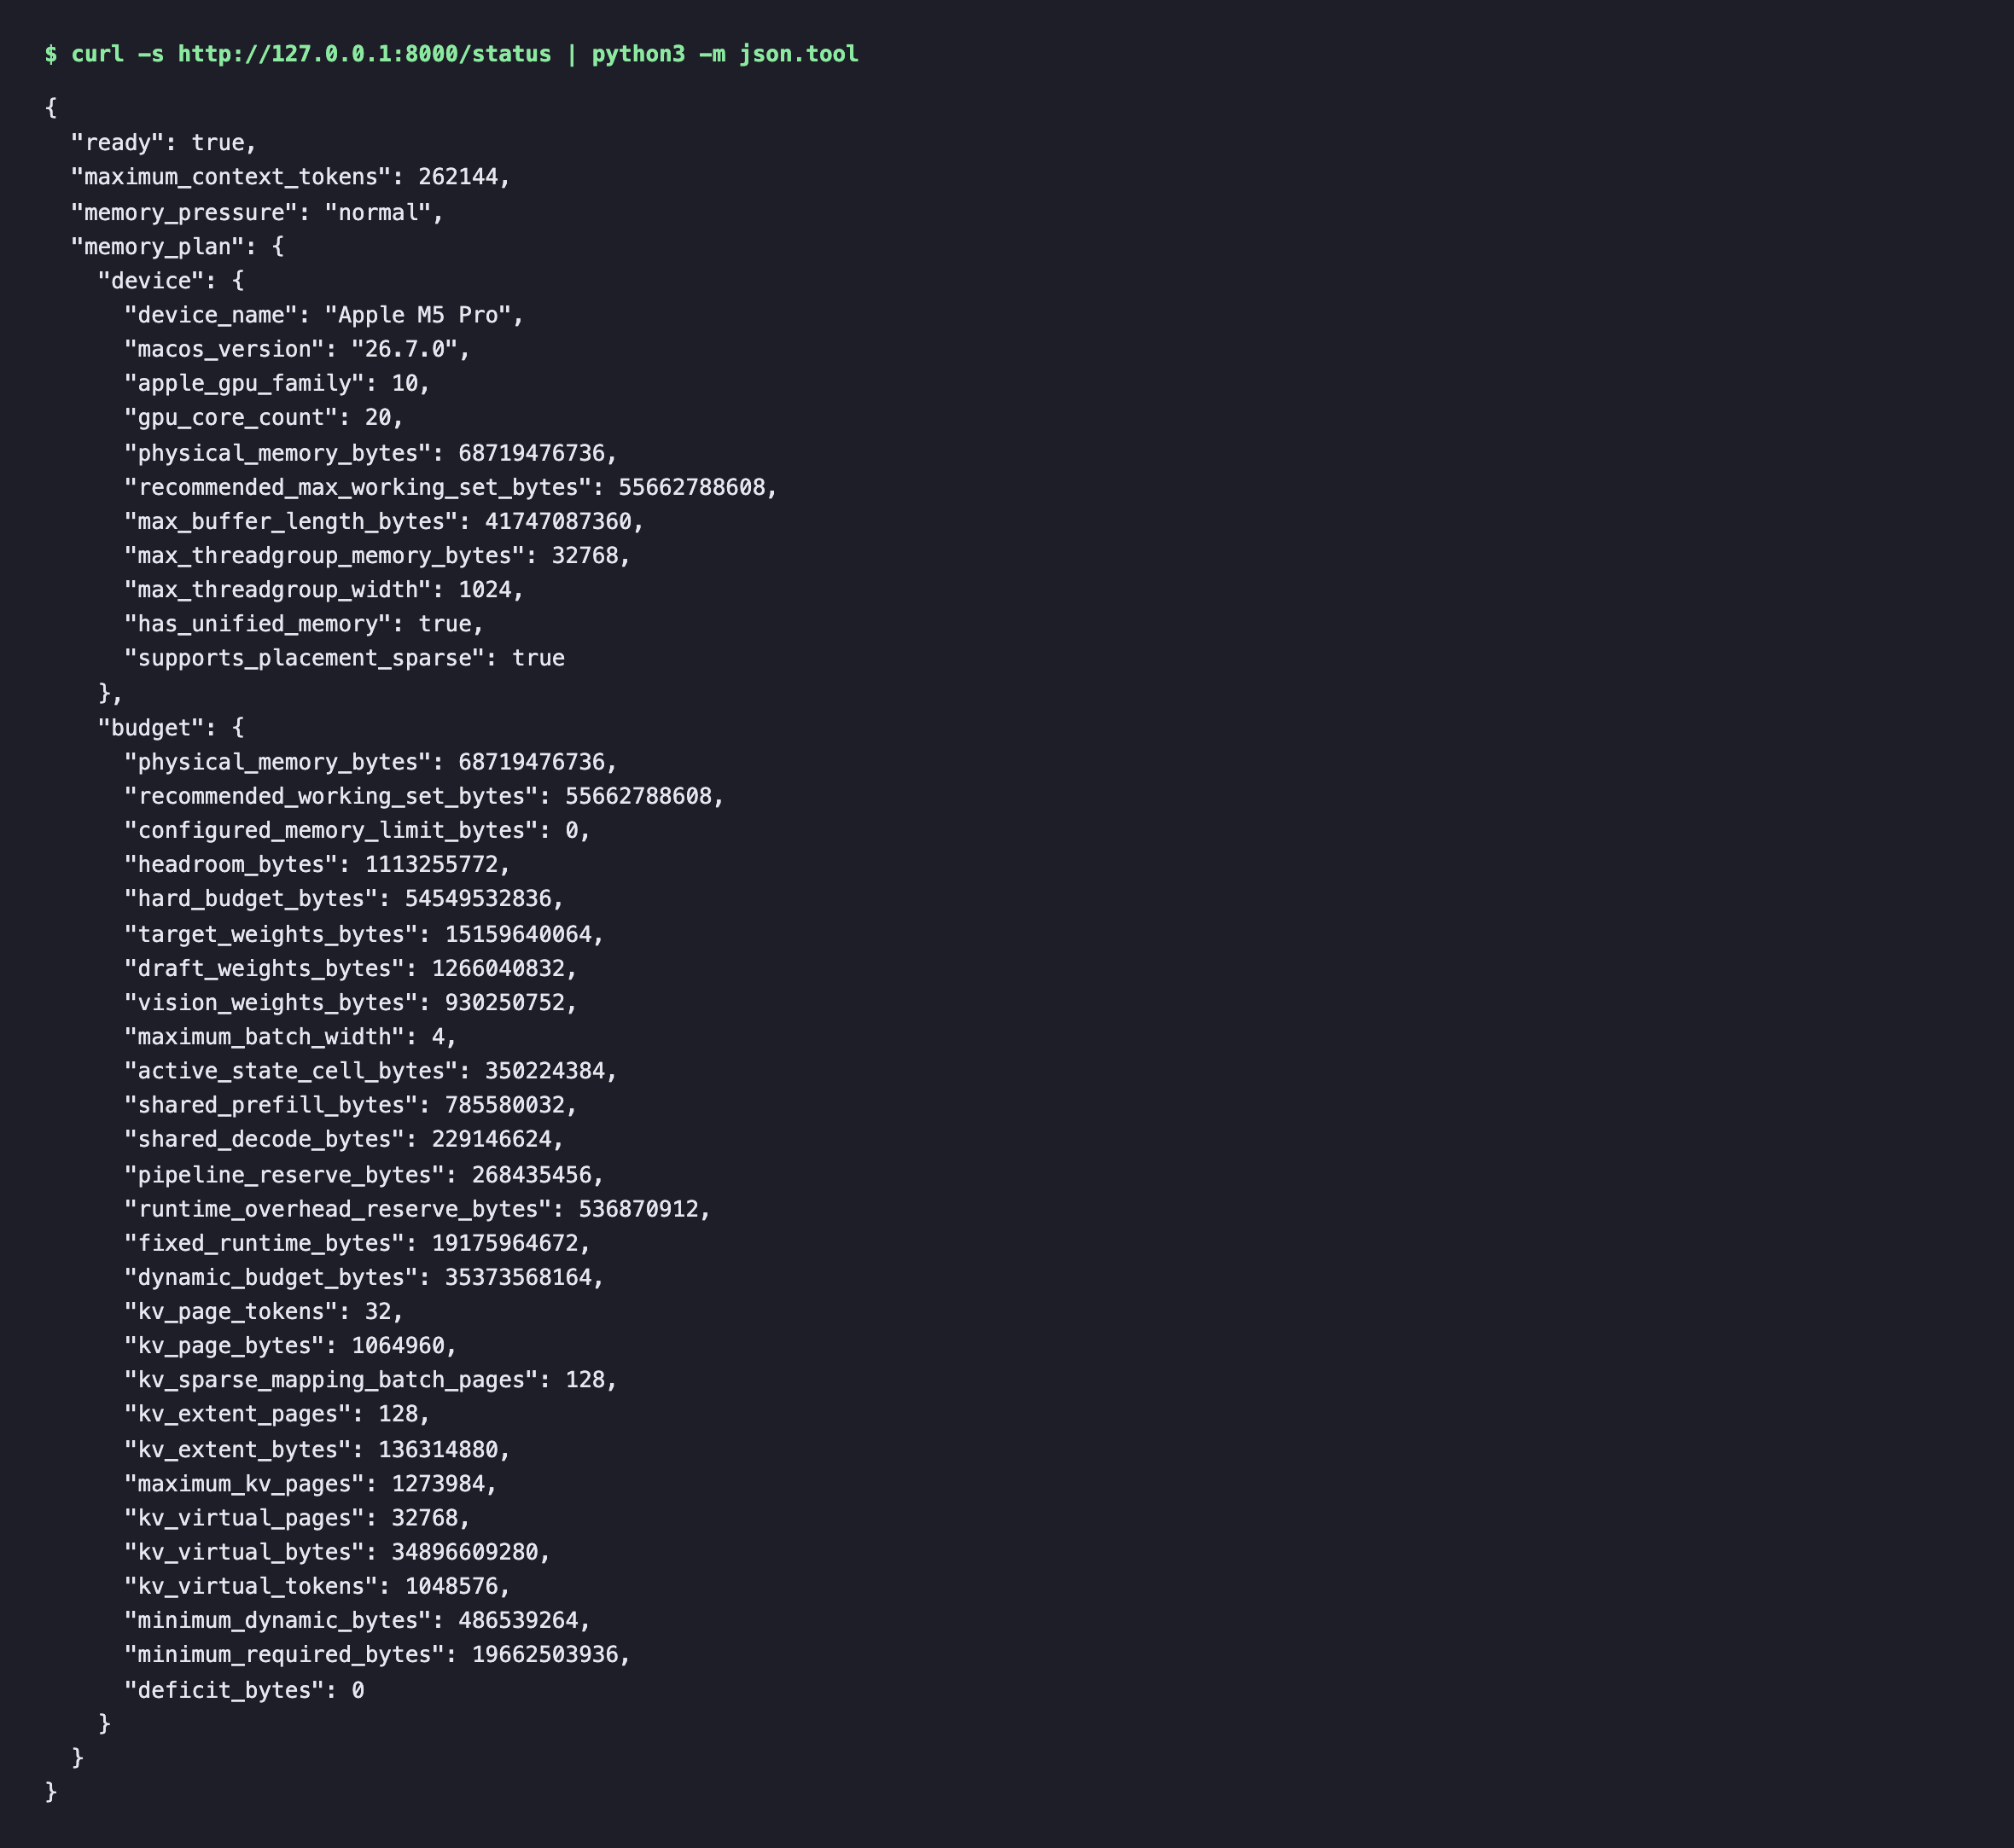
这些数不用猜,它的 /status 接口全都摊开写着,上面那张就是本机的原样返回(只做了缩进格式化)。
我准备了三组题,每组 4 道,各跑 3 次,关掉思考,输出上限 512 token。代码题是写解析器、改异步、写 TypeScript 泛型这类活;中文题是写口播开场、扩写说明、写文章结尾这类我天天在干的活。为了把“语言”和“体裁”两个因素拆开,我又加了一组英文散文当对照——这一步很关键,不然测出来只知道中文慢,不知道慢在哪。
| 我写什么 | 解码速度 | 草稿接受率 | 每次验证吐出 token |
|---|---|---|---|
| 代码 | 79.3 tok/s | 63.2% | 5.45 |
| 英文散文 | 33.5 tok/s | 20.8% | 2.44 |
| 中文口播/文章 | 25.6 tok/s | 11.9% | 1.84 |
归因非常干净。从代码到散文,接受率从 63.2% 掉到 20.8%,这是体裁的锅,散文的下一个词本来就难猜;从英文散文到中文散文,再从 20.8% 掉到 11.9%,这是语言的锅,草稿模型显然是拿英文和代码喂出来的。
这个差距不用看我的表,Splash 自带的网页界面自己就会把速度打出来。同一台机器、同一次会话,我先问了一个中文问题,再让它写一段 Python:
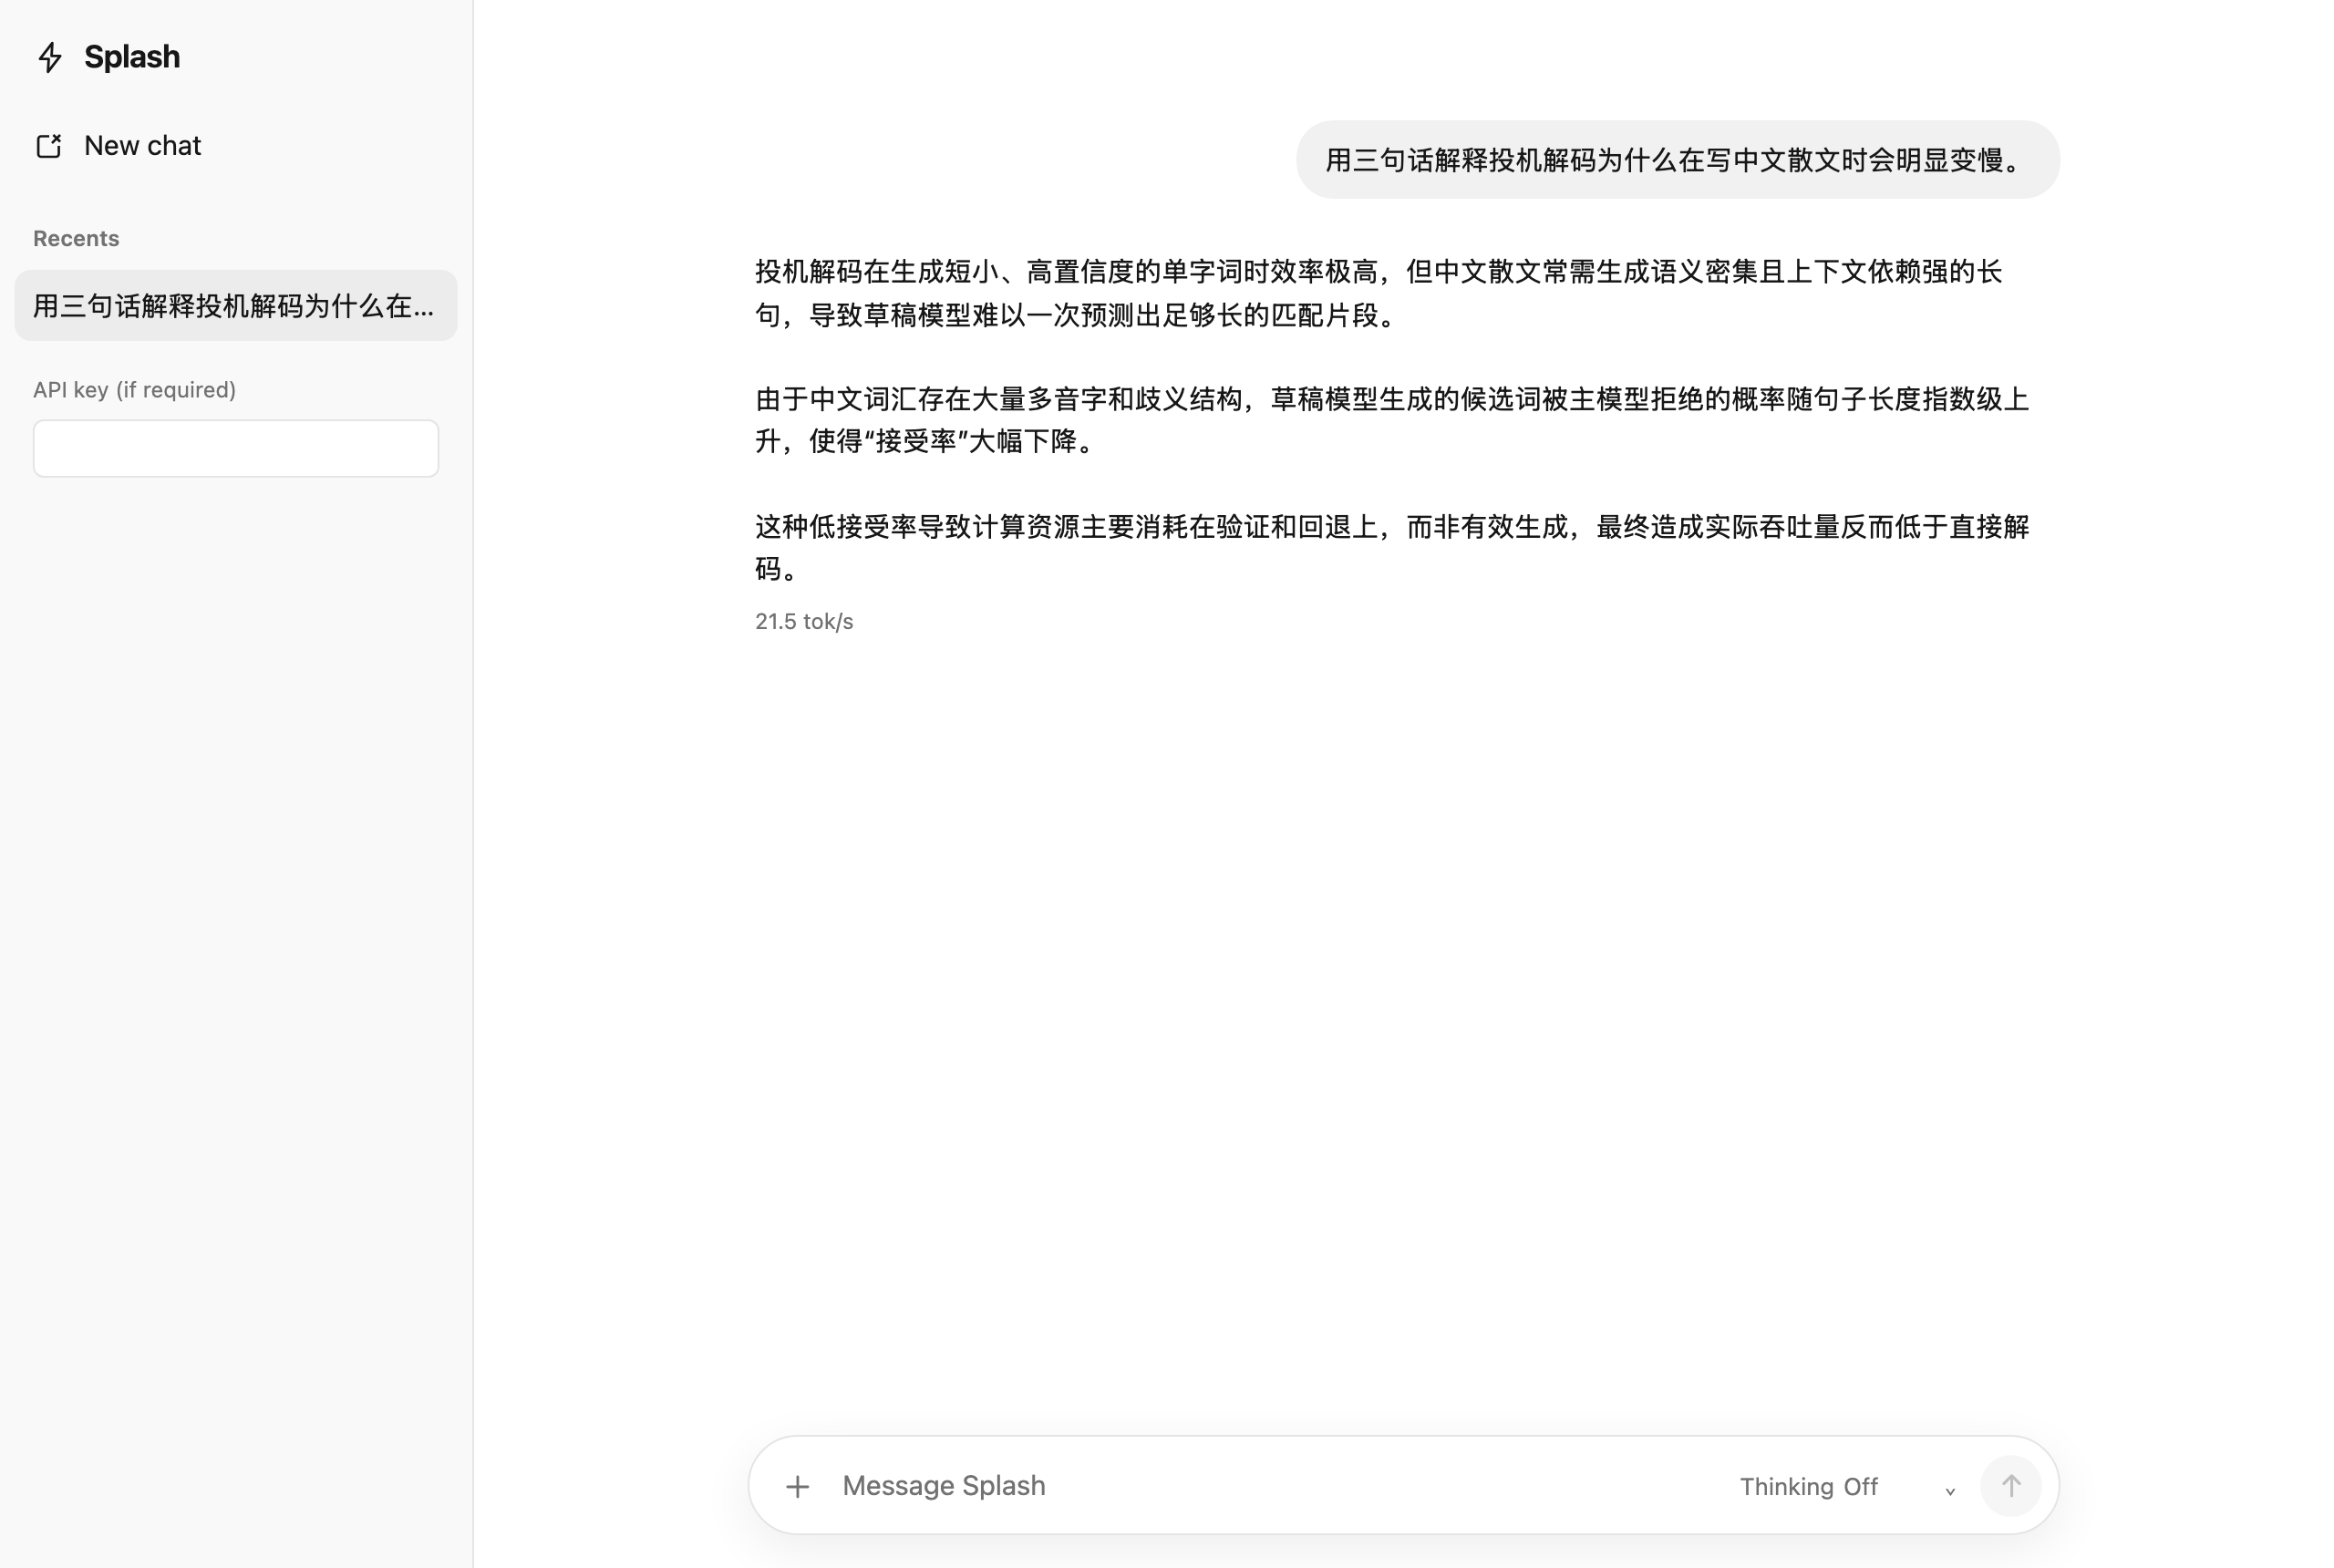
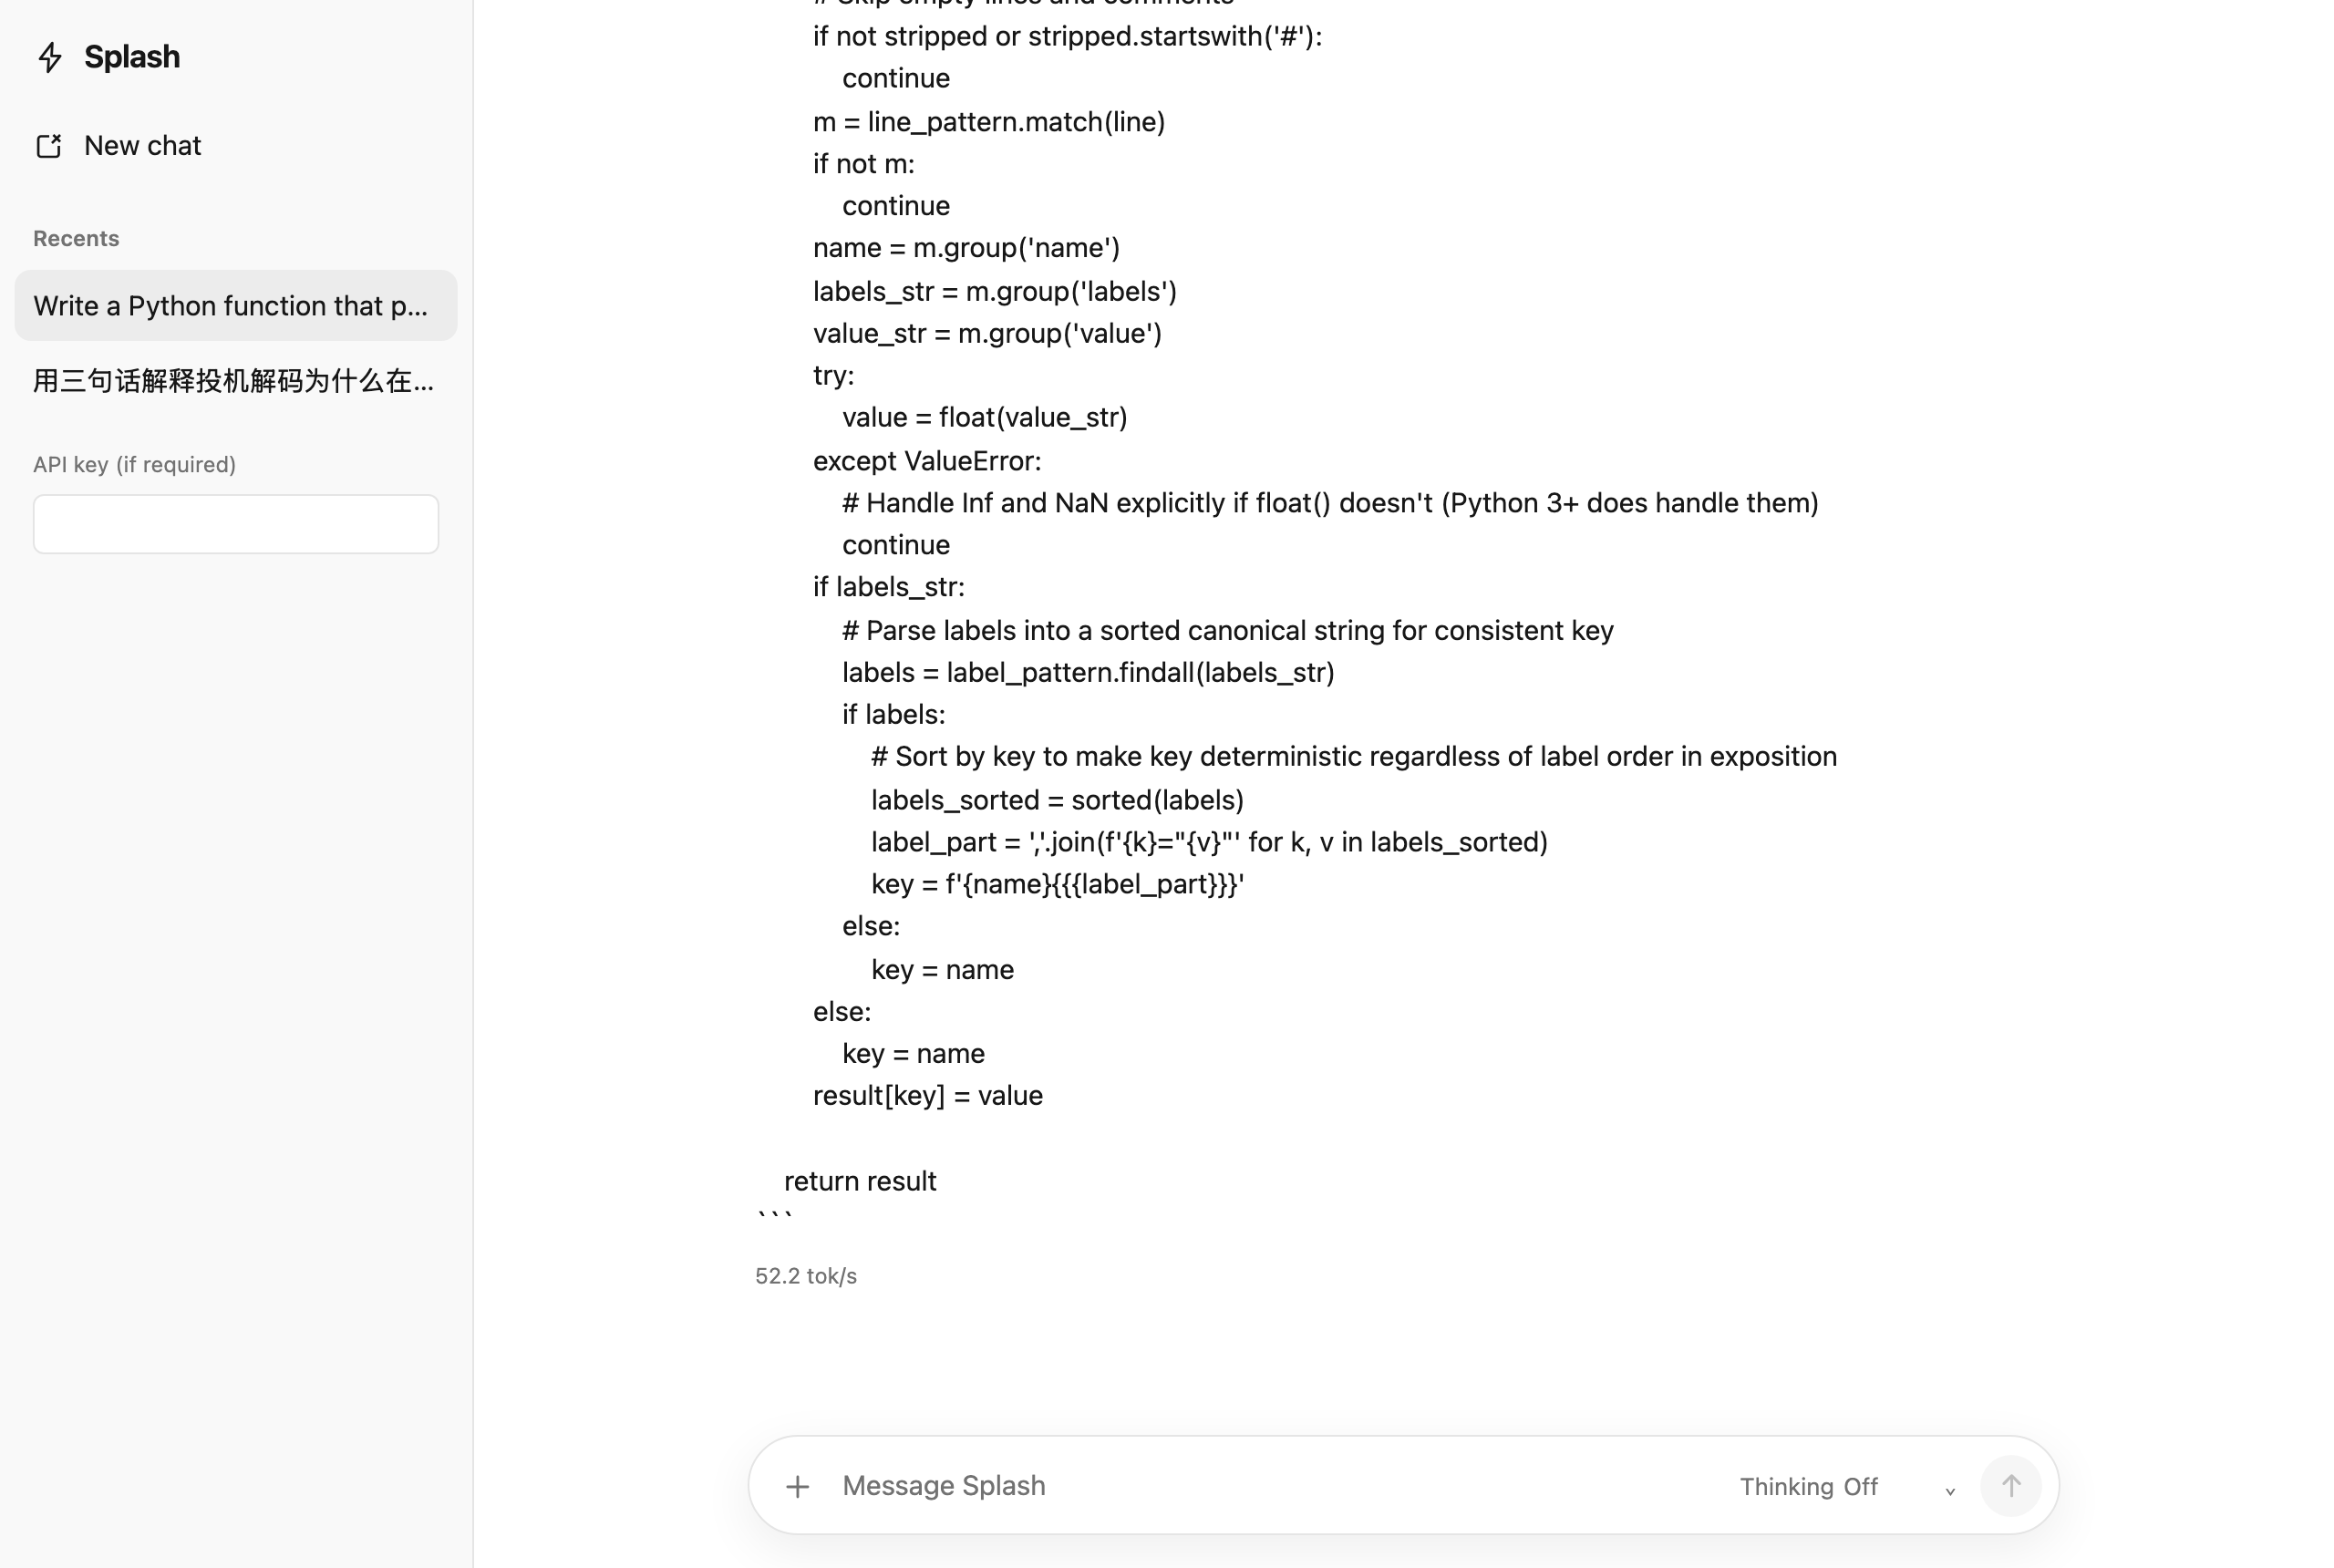
21.5 对 52.2,界面里直接差 2.4 倍。这两个数比我基准表里的 25.6 和 79.3 都低,因为界面读数是单次生成、把等首个 token 的时间也摊了进去,跑的也不是同一批题——口径不一样,不能和上面的表混着引用。但代码快过中文这件事,在产品自己的读数里同样成立。顺带一提,那段中文答案是模型自己写的,它把原因说得比我准确:算力主要消耗在验证和回退上,而不是有效生成。
接受率这个数字我一开始不太敢信,于是找了个办法验证它。DFlash 2 每步固定提 7 个,大模型一次验证整块并且至少吐 1 个,那就应该有一条恒等式:输出 token 数 = 验证次数 + 接受数,其中验证次数 = 草稿数 ÷ 7。我拿 24 次实测数据去套,误差是 ±1.0 个 token,等式成立,说明我理解的机制没跑偏。反解出来的结果更有意思:大模型的裸前向速率是每秒 13.8 到 14.4 次,三种负载基本不变。这正是内存带宽受限该有的样子,搬 14 GiB 权重的成本跟你写什么没关系,所以速度差全部来自“每次验证能吐几个 token”,代码 5.45 个,中文 1.84 个。
这套剧本在视频编码里早就演过一遍。静止画面压到几十 KB,镜头一晃码率就撑爆,因为可预测的内容便宜。投机解码只是把同一条规律搬到了 token 上——所以看到“平均速度”就该先问一句,测的是哪种画面。
往前推一步。过去问“我这台 Mac 跑 27B 有多快”,答案是一个数字:带宽除以模型大小,属于机器。现在它没有单一答案了——同一台机器、同一个引擎,79.3 和 25.6。Splash 并没有让我的 M5 Pro 变快,每秒 14 次前向是带宽钉死的地板,它改的是每搬一次 14 GiB 权重能换回几个 token。速度不再是机器的属性,是机器和你写的东西一起定的。
厂商能复现的数字我也都核了一遍,结果如下:
| 指标 | Inco 公布(16 核 / 48GB) | 我实测(20 核 / 64GB) |
|---|---|---|
| 32K 缓存重放首 token | 282 ms | 300 ms |
| 32K prefill 速率 | 363 tok/s | 450 tok/s |
| 32K 冷读首 token | 96 秒 | 71 秒 |
缓存那条是硬复现,282 对 300,而且它确实复用了 31,881 个 token 里的 31,872 个;我又追加了一次真实续轮(同样的上下文后面再追几个字),首 token 434 毫秒,比精确重放稍慢,符合它自己说的“真实一轮还要为新增 token 付费”。冷读和 prefill 我都比它快,核多四个的差距说得通。不过顺便说一句,冷读 71 秒这个绝对值是真的疼——第一次让它读完一份 32K 的代码,你得干等一分多钟,这部分它没什么魔法。
最后我下了同一份上游权重做对照。Splash 的清单里写明它的 27B 来自 mlx-community/Qwen3.8-27B-4bit 的某个具体提交,我就按那个提交号下了一份 14.98 GiB 的权重,逐文件校验 SHA-256 之后,用不做投机解码的朴素 mlx-lm 跑同样的题:代码 16.6 tok/s,中文 17.8 tok/s。所以 Splash 相对“完全不投机”的净加速是代码 5.11 倍,中文 1.44 倍。
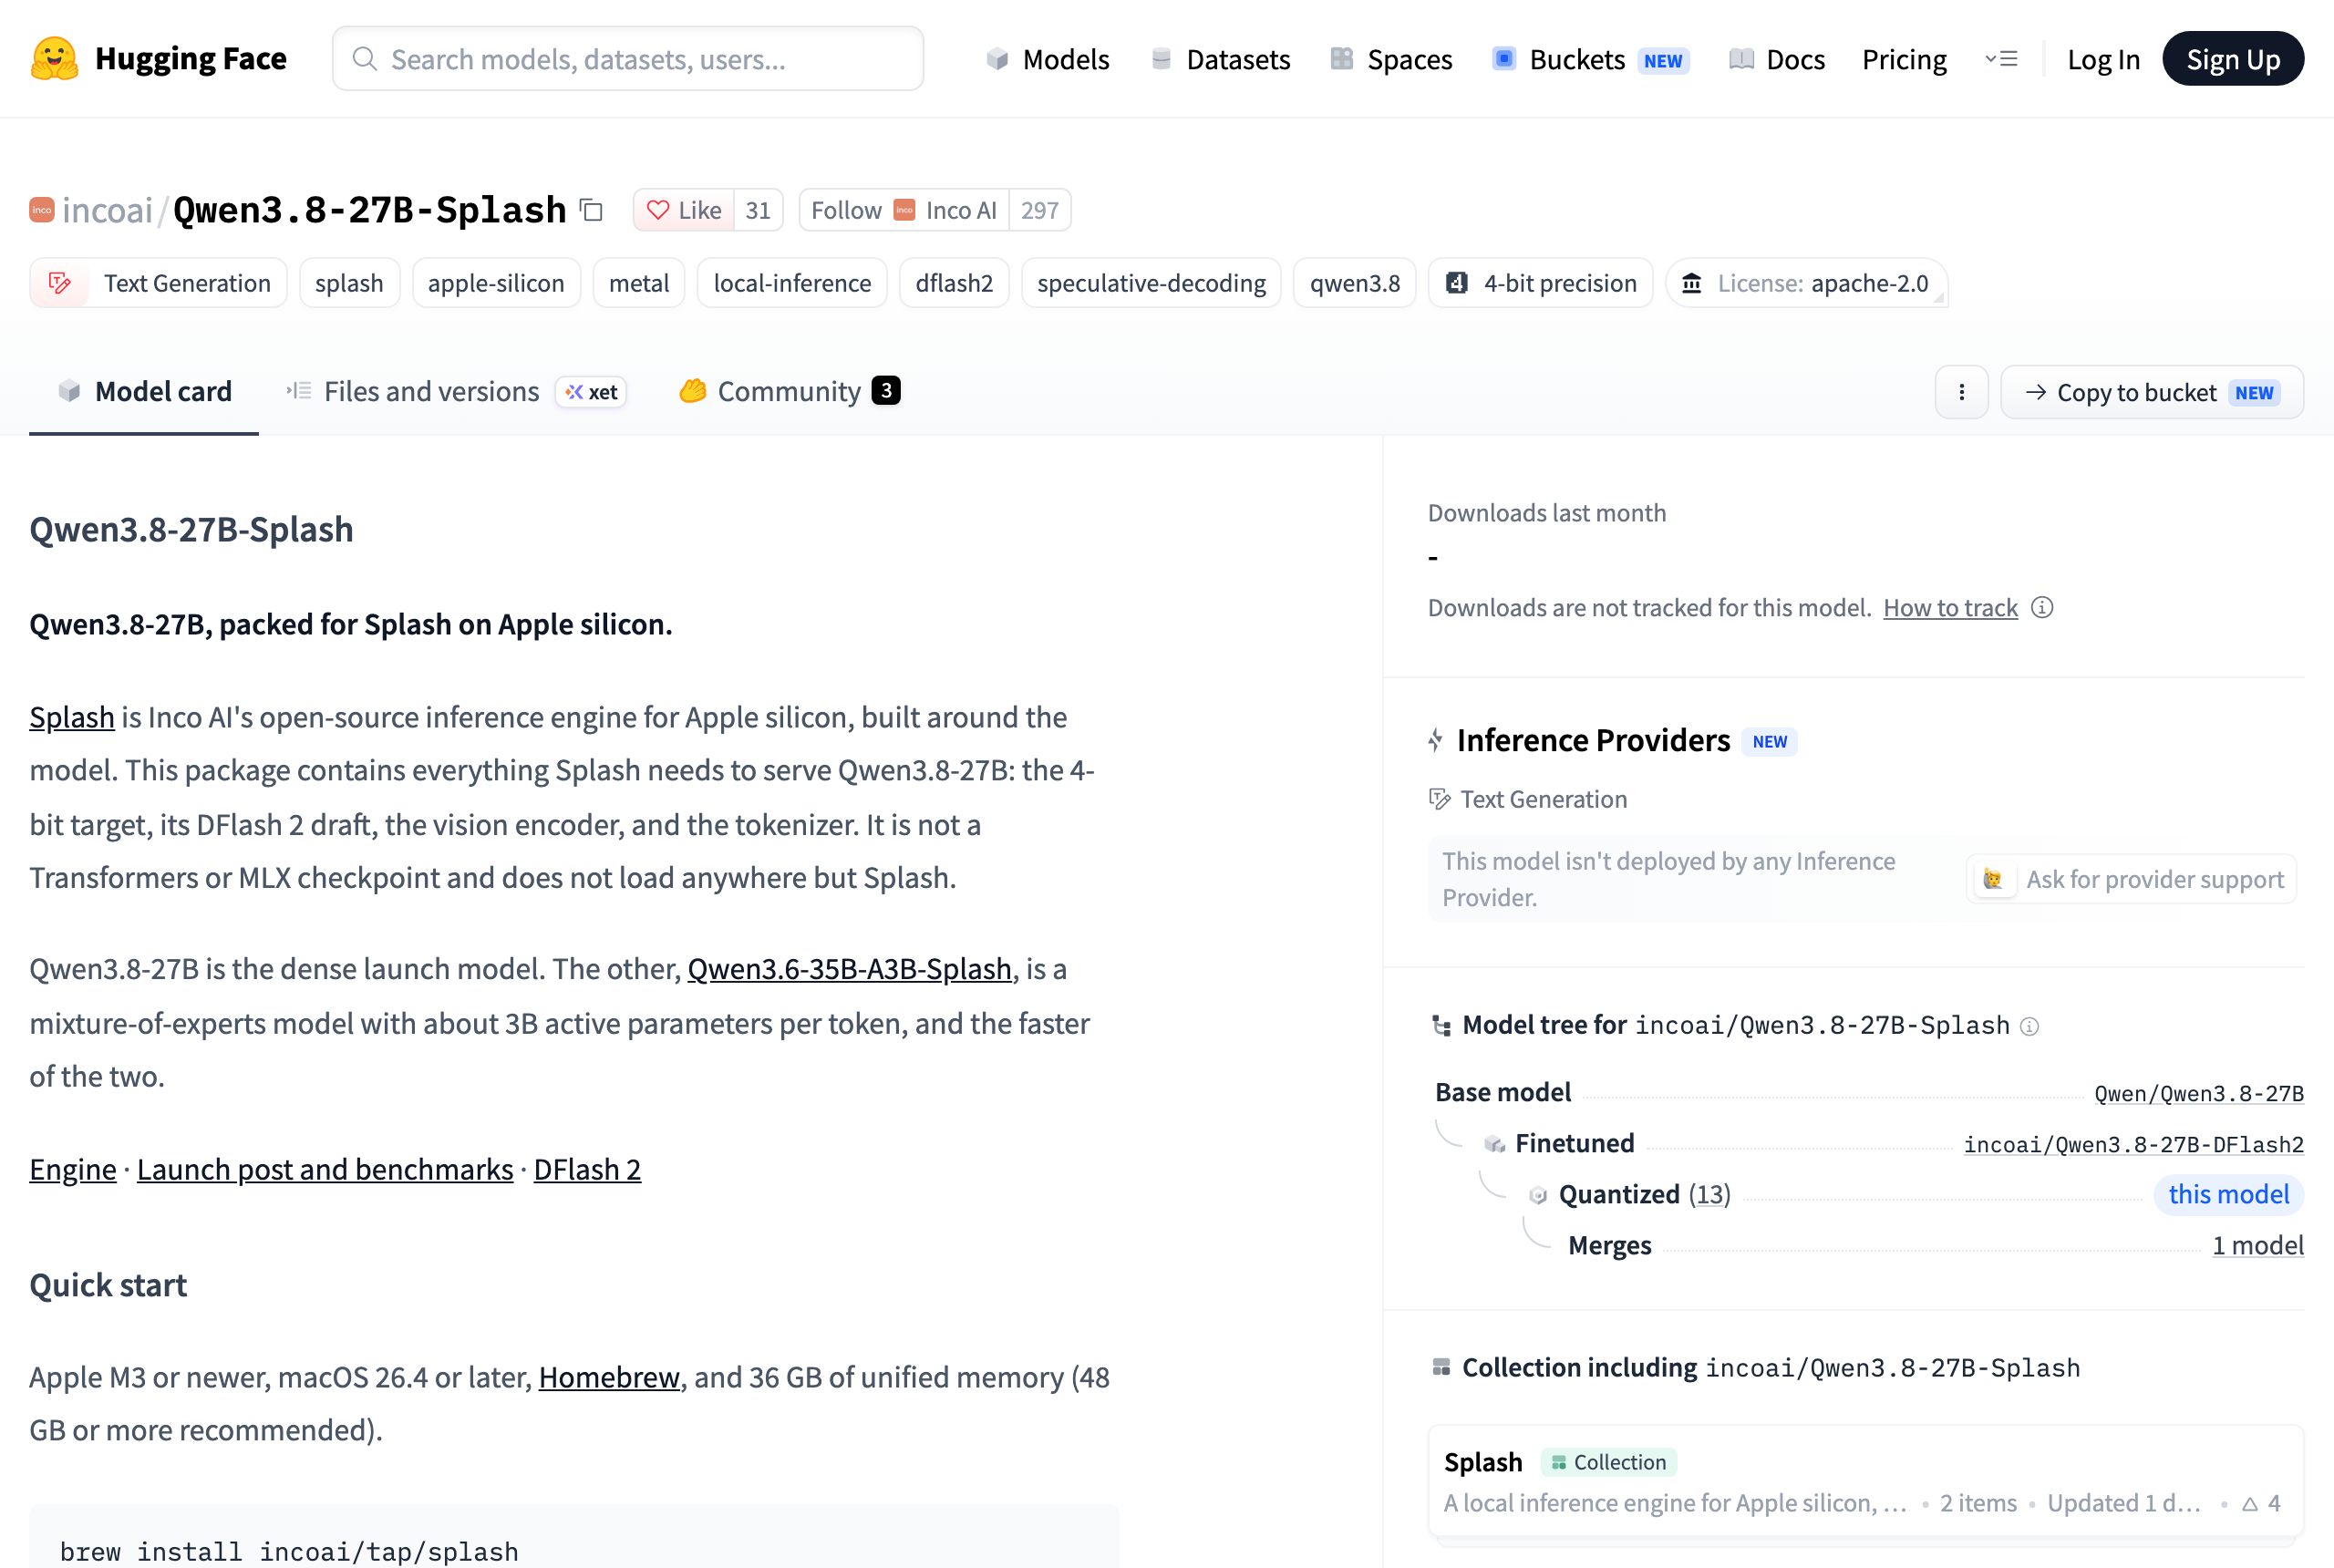
模型卡把上游仓库和具体提交号都写了出来,所以我拿到的是完全相同的权重,不是另一个 4bit 转换。
这些数字能证明什么,不能证明什么
先说我这轮测试的硬伤,有四处,都不小。
第一,我的题不是它的题。 Inco 用的是 NVIDIA SPEED-Bench 里挑的编码题,我用的是我自己写的 4 道。我按它的原始口径(开思考、中等档、1024 上限)重跑代码题,测出 58.9 tok/s,接受率掉到 48.3%——它公布的 74 落在我两组配置之间。这只能说明我和它在同一个量级,不能说成我复现了 74。
第二,那个 7.3 倍我没验。 Inco 说自己的缓存命中比次快引擎快 7.3 倍,那是跨引擎对比,我没装对照的那个引擎。我测出的“冷读 71 秒对重放 300 毫秒”是同一个引擎的冷热差,两件事不能互相印证,谁也别拿我的数去证它的。
第三,也是最要命的:我的基线选错了。 我拿“完全不投机的朴素 MLX”当对照,可我自己电脑上真正在跑的那套并不是它。我翻了自己写的 LocalBrain 的代码,v1.2.70 启动 llama.cpp 的时候已经在传 --spec-draft-model 和 --spec-type draft-dflash,而且 DFlash 2 是作为 Qwen3.8-27B 的配套组件自动下载的——也就是说,我的现役链路早就在投机解码了。那 5.11 倍是对一个比我现役更弱的对手比出来的,对我实际在用的东西,Splash 的净增益一定更小,而且我还没测。
显卡厂商当年就是这么报峰值算力的:标称值在特定算子上成立,落到实际负载另说,分母藏在脚注里,谁挑的对手谁占便宜。我前面还在夸 Inco 挑对手挑得挺诚实——它比的是已经用上多 token 预测的 oMLX,不是最弱的那个——结果同一个坑我自己一脚踩进去了。
第四,我测的版本已经不是你现在装到的版本了。 我全程测的是 1.0,而 1.0.1 在我写这篇的当天上午发布,Homebrew 配方已经指过去。它改的是内存处理、并发下的共享前缀复用与预填调度,还补上了 1.0 里 README 写了但命令行实际没有的 --port。单请求解码大概率不受影响,但并发那块我没重测,别把我的数直接套上去。
还有一块我完全没碰:质量代价。它的权重是平铺 4-bit,KV 缓存是 8-bit(/status 接口里写着 symmetric_int8)。写 MTPLX 引擎的那位开发者在发布当天就提醒过,Qwen3.8-27B 的某些层对量化特别敏感。速度不会白来,但代价有多大,我这轮说不出来。
谁在赚,谁在沉默
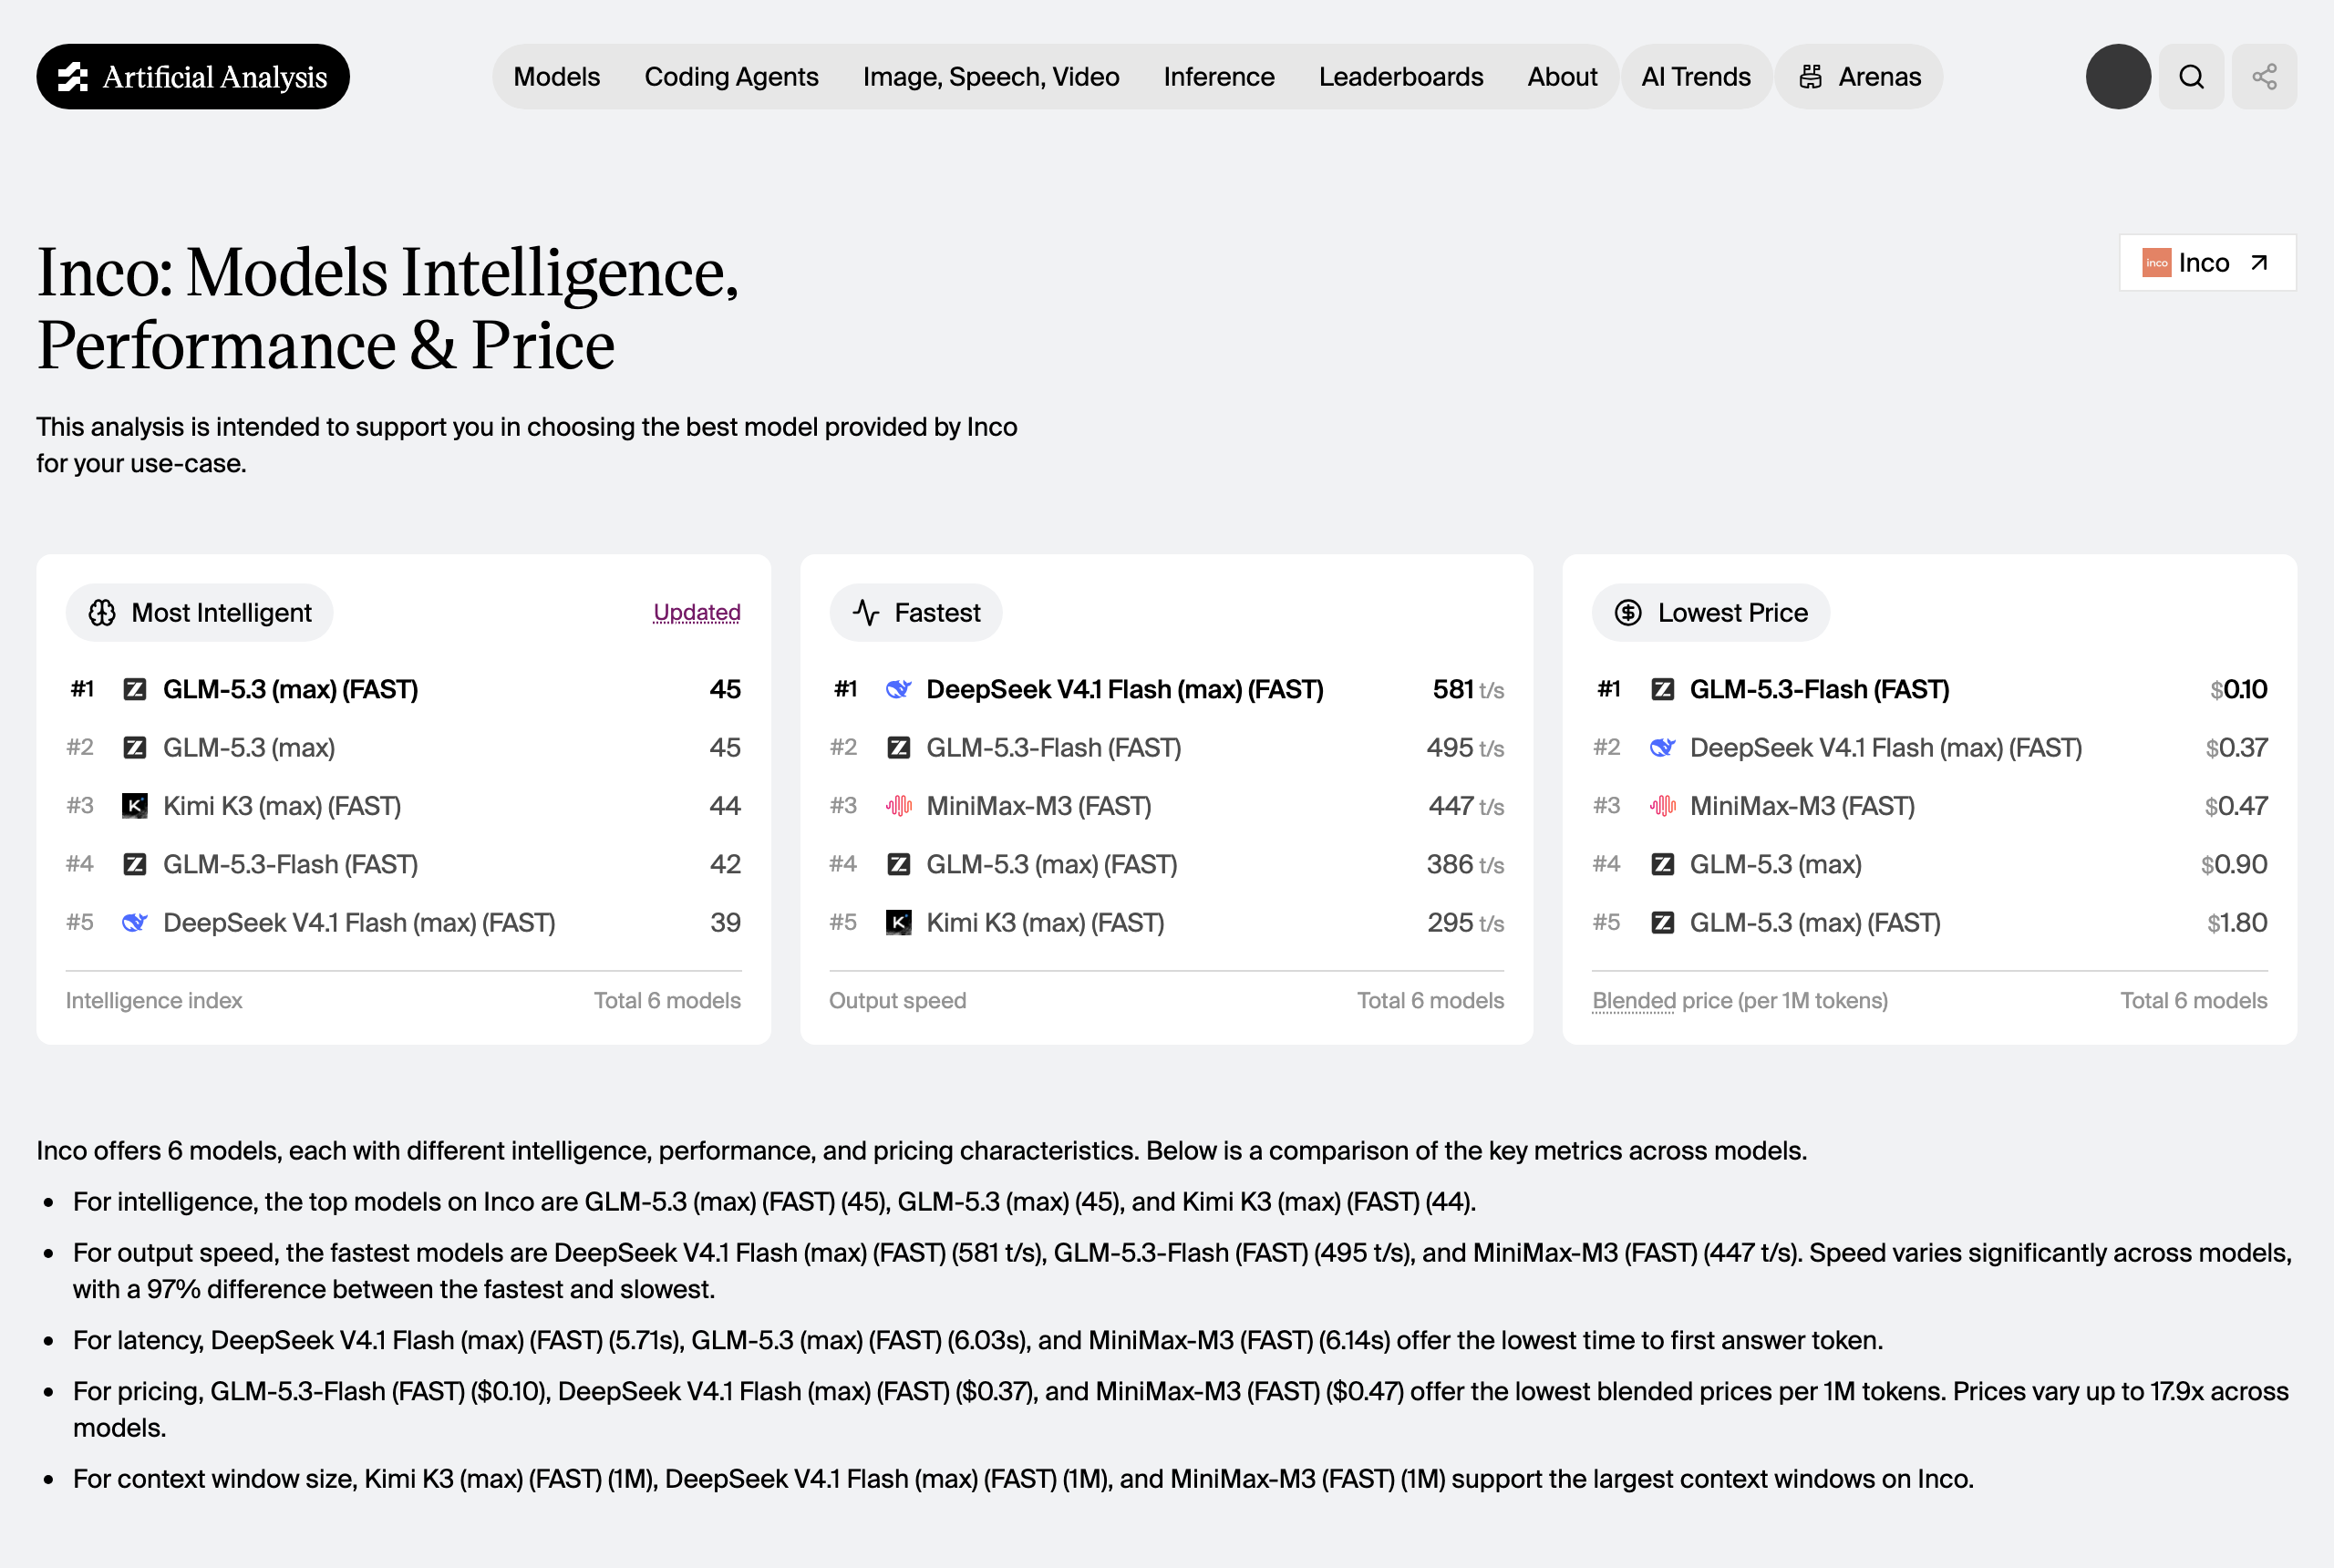
Inco 不是做 Mac 软件的公司,它的主业是数据中心推理。在 Artificial Analysis 的 provider 榜上,Kimi K3、MiniMax-M3、GLM-5.3、GLM-5.3-Flash 四项的输出速度第一都是它。开源一个 Mac 引擎,是把同一套技术做成招牌——它那篇发布博文的结尾自己写着在招人。
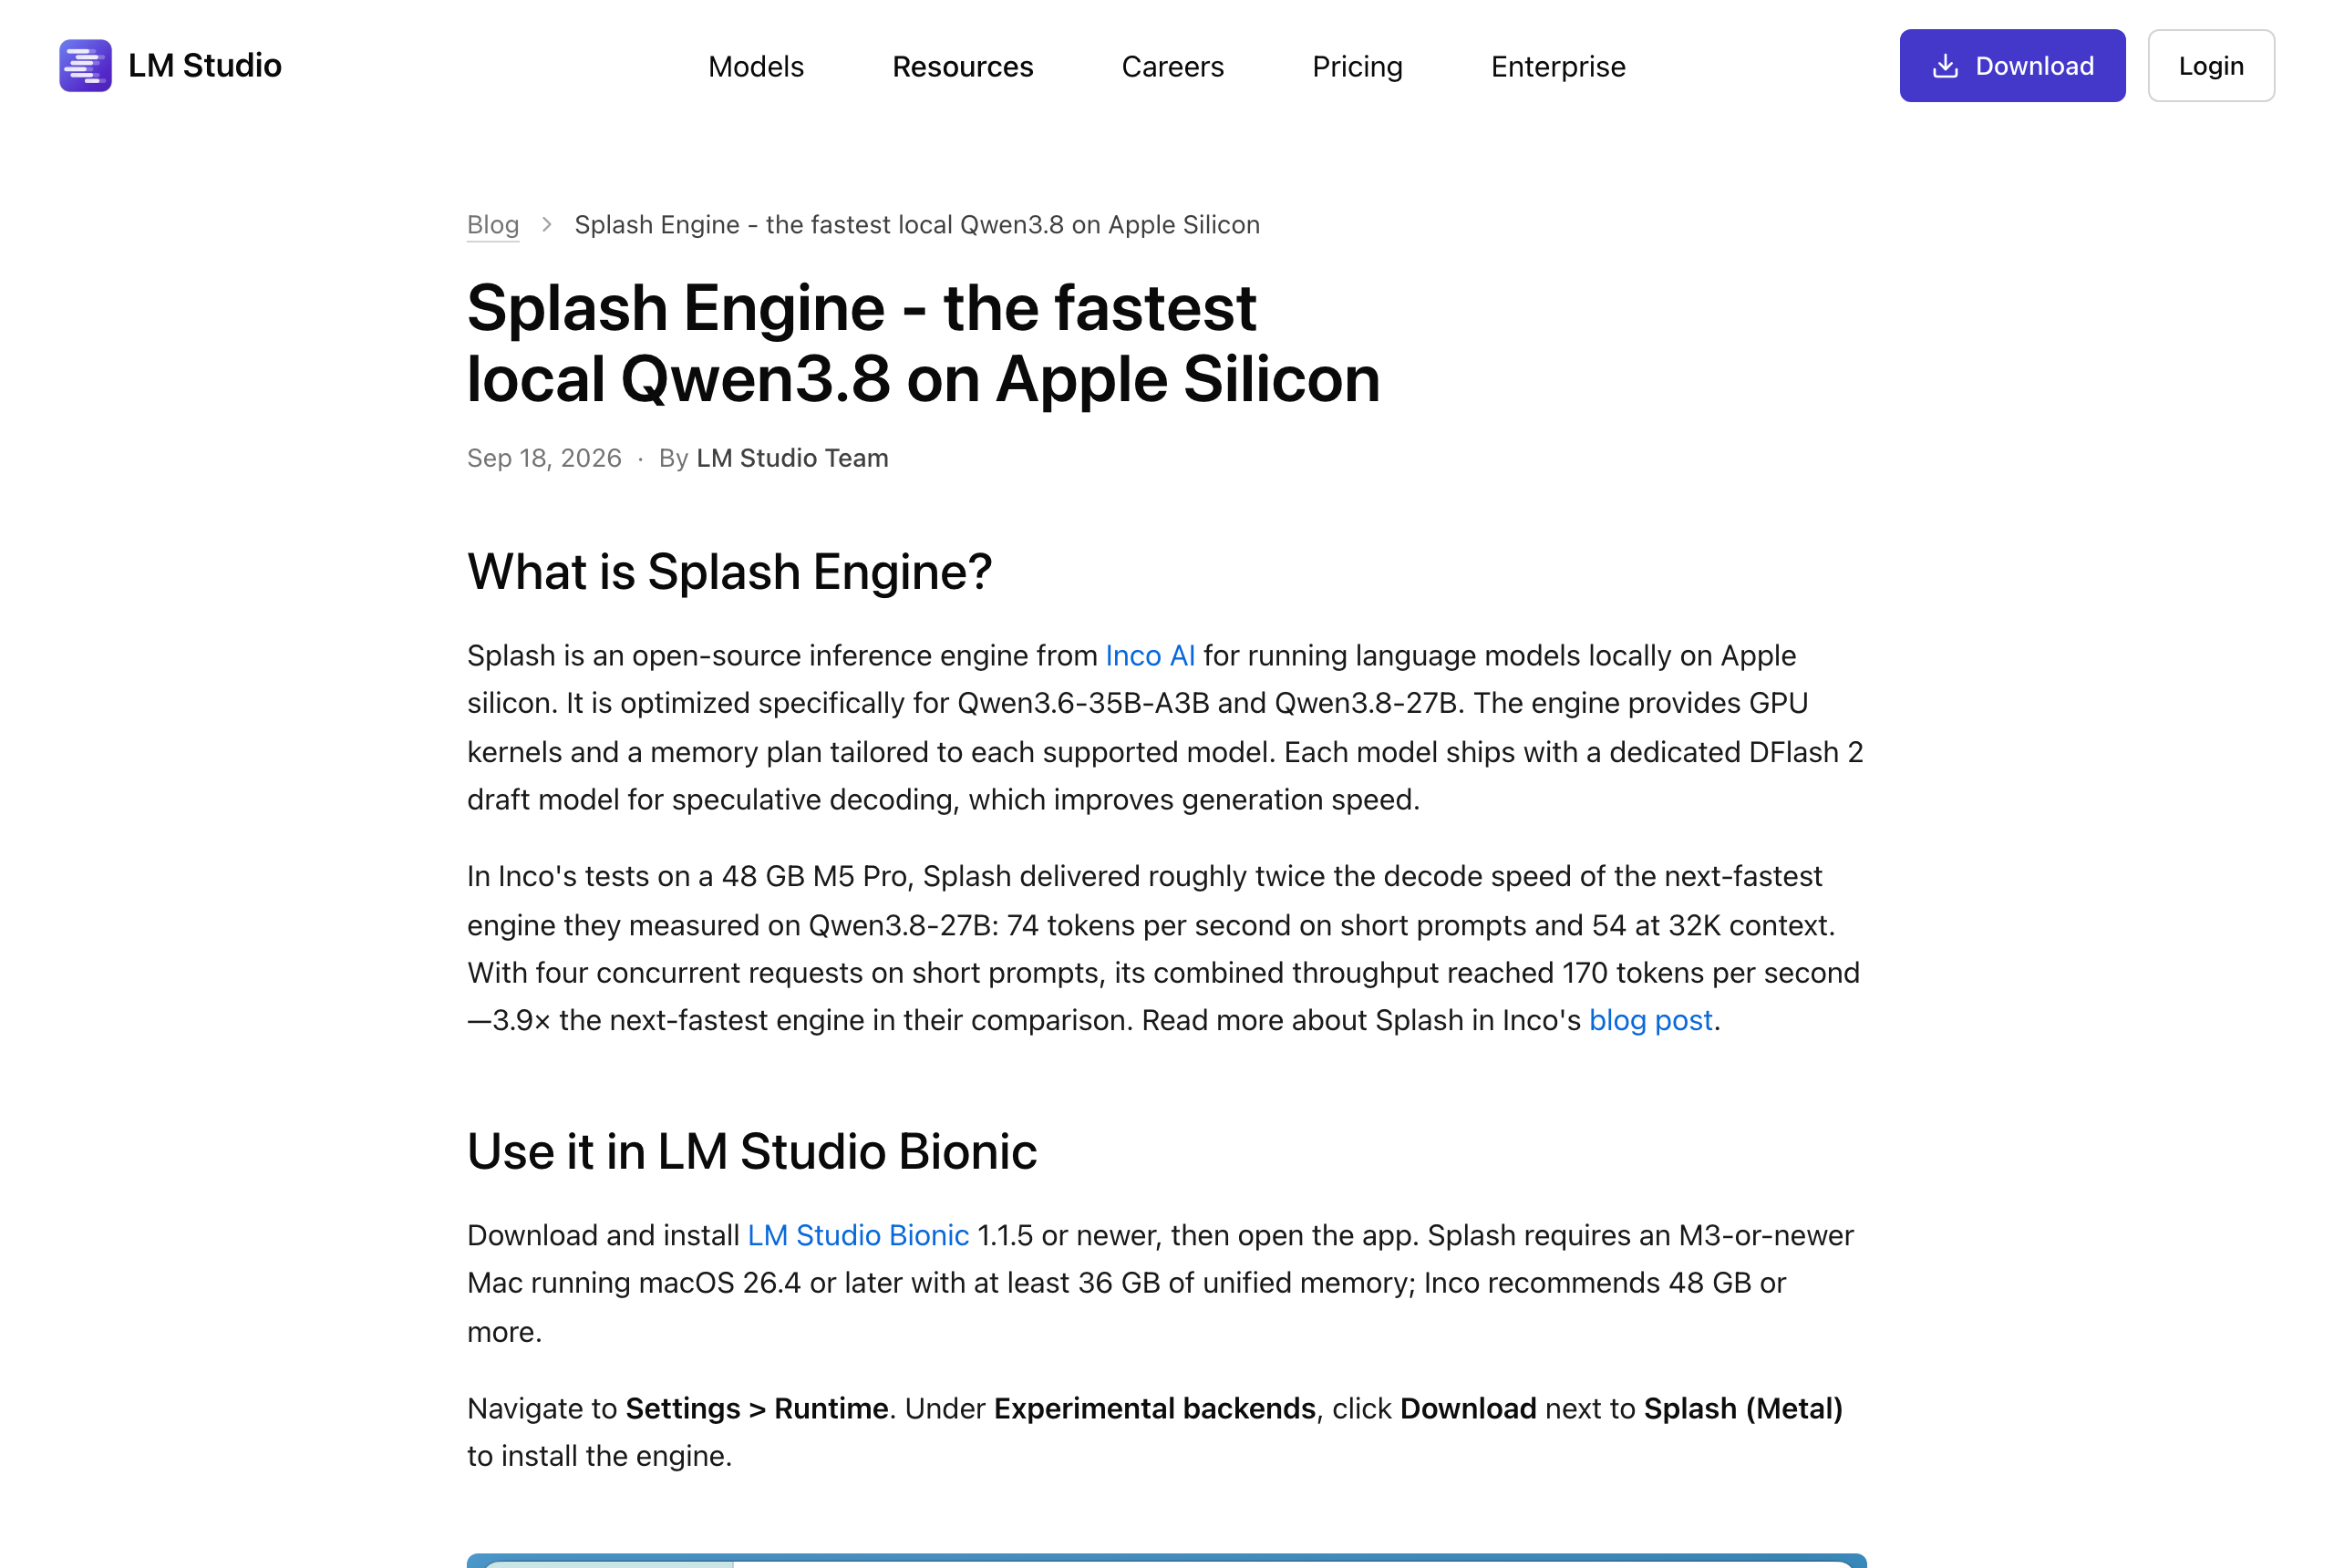
LM Studio 是渠道赢家,Bionic 1.1.5 把 Splash 直接列进了实验性后端,这也是我判断它不是空壳的最硬依据:LM Studio 不会给一个假引擎开一等公民的位置。
苹果也算受益方,推荐配置写的是 48GB 起步,要求 M3 或更新,M1、M2 用户加内存也进不来,芯片这道门先把人筛掉了。
吃亏的是谁?36GB 的机器刚过线,模型加草稿固定就占 17.86 GiB,剩下的 KV 余量很紧;以中文为主的创作者拿到的是三组里最小的那个增益,1.44 倍。
最值得说的是沉默的那一方:到现在为止,没有任何人公布过非编码负载的接受率。 Inco 的基准表里只有编码题,草稿模型是拿什么语料训的也没写。按编码基准报数的一方,没有动机告诉你中文会掉到 12%,这个沉默本身就是结论。而只要这个数字没人公布,本地推理的跑分表就不再可比——谁都可以挑编码题报数,而编码恰好是投机解码最顺的那一局。它同时也指出了一个真实的空位——中文草稿模型。DFlash 2 这个思路早就不新鲜了,Hugging Face 上 incoai/Qwen3.8-27B-DFlash2 近 30 天有 401,108 次下载,技术是现成的,缺的是有人把中文语料喂进去。谁做出来,本地中文生成的性价比就要被重算一遍。
我打算把它接进 LocalBrain(这是计划,不是已完成)
写到这我得先声明清楚:下面这段是计划,还没有一行代码落地,也没有时间表。
我想接它,理由是这条路我已经走了一半。LocalBrain 现在管着四个运行环境——mlx-env、torch-env、自管的 llama.cpp,以及专门给 Bonsai 2 三值量化用的独立 Prism 构建。投机解码这一层也已经在跑:窗口小于 64K、有草稿文件、走统一内存路径的时候,它就会把 DFlash 2 挂上去。有两个细节现在回头看还挺得意:窗口到 64K 以上就自动关掉草稿,因为草稿会放大大上下文时的峰值内存;加了草稿后若可用窗口算成 0,就退掉草稿保住主模型——可选的加速不能把本来能启动的模型变成启动不了。所以把 Splash 接成第五个后端,不是从零开始。
但有两个障碍得先解决,我不想含糊过去。一是它只吃自己打包的模型。 普通的 MLX 或者 Transformers 检查点它一律不加载,必须是 Splash 格式的包,今天只有两个:Qwen3.8-27B 和 Qwen3.6-35B-A3B。LocalBrain 的设计前提是“任意导入”,架构识别刻意做成了与架构无关——读 GGUF 元数据,架构名只当键前缀用,取不到就明说“KV 成本未知”,不装懂。这两种哲学是冲突的,接进来只能是“多一个高性能特例”,不是“多一个通用后端”,我不打算把这件事说成后者。二是内存账要重算。 Splash 的内存预算封顶能到 50.8 GiB,LocalBrain 自己那套硬件感知的窗口规划得重新和它对齐,不然两边各算一套,用户就会撞上莫名其妙的分配失败。
在这之前我要先补一个测试:Splash 对我现役的 LocalBrain 加 llama.cpp 加 DFlash 2,同一个 Qwen3.8-27B,同一批中英文题。两边都在投机解码,差异只剩 Splash 的专用 Metal kernel、批处理调度和内存规划。那个数字才是决定值不值得接的依据,也是我下一步要做的事;测完我会把结果和这篇的口径一起放出来。
适合谁,谁先别急
先摆个判断,它和厂商的排序是反的。Inco 把“2× 解码”放在 README 第一句,我测完一天认为该倒过来排:缓存复用第一,内存规划第二,解码加速只排第三。 缓存那条完全不挑语言,32K 上下文重开 300 毫秒,对多轮 agent 就是能用和不能用的分界。内存规划是启动时把账算死,装不下就打印预算明细停住,不让你跑到一半崩——这是工程品味,不是性能指标。解码加速偏科最重,代码 5.11 倍、中文 1.44 倍,落到谁头上全看他写什么。
值得装的: 拿本地模型当编码 agent 后端的人。5 倍是真的,加上 32K 上下文重开只要 300 毫秒(而冷读是 71 秒),多轮 agent 循环的体感会不一样。机器门槛是 M3 以上、macOS 26.4 以上、36GB 内存,48GB 才舒服。
先别急的: 主要用它写中文的人。1.44 倍,而且 25.6 tok/s 写长稿子依然慢,在线接口更快也更省事。为了 44% 花 17.4GB 硬盘和一天折腾,这笔账你自己算。
别指望的: 拿它替代通用的本地推理方案。两个模型,格式锁死,你现有的 GGUF 库一个都用不上,它解决的是“把两个模型跑到极致”,不是“什么都能跑”。
这恰恰是它押的注。llama.cpp 和 MLX 是模型动物园,什么都能跑、都跑得还行;Splash 反过来只收两个,但 kernel 按这两个模型的确切张量形状预编译,草稿按目标模型专门训练,内存计划按已知尺寸提前算死。押对了,本地推理会像游戏主机一样收敛到少数几个打磨到底的组合;押错了,它就是个只能跑两个模型的玩具。LM Studio 第零天把它接成一等公民后端,至少说明有一家重要渠道方压的是前一种。
我自己的结论:装着,当编码后端用,中文稿子还是走别的路。至于接进 LocalBrain,先把那个漏掉的对照测出来再说——毕竟我刚在这篇里抓到自己挑了个软柿子对手,不能接着犯第二遍。
题目、代码与查证来源
一篇说跑分不可比的文章,自己的跑分得可比。所以题目全部贴在下面。
代码题(投机解码的顺风局,厂商基准用的也是这个体裁):
1. 写一个 Python 函数,把 Prometheus 文本格式解析成 {指标名: float},跳过注释、处理 label
2. 把 fetch_all() 改写成用 asyncio.gather 的异步版,保持每项独立的错误处理
3. 用 TypeScript 写 chunkByTokenBudget<T>(items, cost, budget):贪心装箱不超预算,
   单项超预算就抛错
4. 写个 bash 脚本,找出目录下所有 .safetensors 并按 MiB 倒序打印
中文题(我天天写的那种):
1. 为一期讲「本地推理引擎为什么能比通用引擎快一倍」的视频写约 300 字口播开场,
   第一句就抛出反直觉的事实,不要「大家好」这类套话
2. 把「投机解码让小模型先猜、大模型一次性批量验证」扩写成 300 字,面向没有技术背景
   的读者,不要比喻堆砌,要有具体数字感
3. 写约 300 字,主题是「为什么厂商自己发的性能基准不能直接采信,但也不该一概否定」,
   给出两条具体判断方法
4. 为一篇讲 Mac 本地部署的文章写约 300 字结尾,落到读者能立刻执行的一件事上
英文散文题是中文这四道的对应英文版。
测量只有两处关键,都容易做错:
# 坑一:不能按 SSE chunk 数算 token。投机解码下,一次被接受的多个 token 会在同一个
# chunk 里一起吐出来;按 chunk 计数会系统性低估 Splash,把结论往「厂商吹牛」那边推。
ctok  = usage["completion_tokens"]          # 只认 usage,chunk 数仅作交叉校验
tok_s = ctok / (t_last - t_first)           # 分母是首个 token 之后的解码区间

# 坑二:接受率要取 /metrics 的增量。服务端计数器是累计的,必须在每个请求前后各抓
# 一次求差,否则前面跑过的题会把后面的稀释掉。
m0 = get_metrics()
r  = stream_once(prompt, max_tokens=512, reasoning="none")
m1 = get_metrics()
drafted   = m1["splash_drafted_tokens_total"]        - m0["splash_drafted_tokens_total"]
accepted  = m1["splash_accepted_draft_tokens_total"] - m0["splash_accepted_draft_tokens_total"]
acc_ratio = accepted / drafted
写完这篇之后我把整套又跑了一遍,结果值得单说:草稿数和接受数逐字节相同——代码 4851/2904、英文 15645/3249、中文 11277/1446,一个数都没动;速度则浮动了 2% 到 6%,代码 79.3 变 77.3,中文 25.6 变 24.1。所以这些数字该信到第几位,你自己有数了:接受率是模型和内容的性质,稳;tok/s 带着机器当时的状态,个位数的差别别当回事。
其余查证来源:
- Splash 源码与 README:github.com/incoai/splash(Apache-2.0;1.0 发布于 2026-09-18,1.0.1 发布于 2026-09-20,本文实测的是 1.0)
- Inco AI 发布博文与完整基准表:inco.ai/blog/splash
- LM Studio 集成说明:lmstudio.ai/blog/splash-engine(Bionic 1.1.5 起)
- 模型包与来源提交:Hugging Face 上的 incoai/Qwen3.8-27B-Splash
- 数据中心侧第三方排名:Artificial Analysis 的 provider 榜
- 本机实测:M5 Pro / 20 核 GPU / 64GB / macOS 26.7;题目、脚本与原始结果见下一节
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
把 Mac 变成私有 AI 盒子:本地转写、配音、生图、视频和 MCP 工具一站管理。
本轮公开 Apple Silicon Mac 安装包。聊天模型现在可通过同一代理按需调用已集成的语音、转写、图像、图片编辑、音乐和视频工具,并把实际产物交给下一项工具继续处理。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
修复编辑时切换抠图、模糊、自定义背景后摄像头消失的问题。 实际macOS桌面已验证全片原画/抠图/模糊/自定义图片切换、播放和片段独立模糊;独立原生导出涵盖原画、抠图、模糊、自定义纯色/渐变/图片,共144帧完整解码。真实新组件对照复现并修复三个模式的迟到结果空白问题。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取

留言
正在加载留言…