摘要 官方倍数的水分,写在它自己的脚注里 Vercel 上免费白嫖到 9 月 25 日 黑粉科技 · 2026-09-20
先说这篇是怎么来的:我没有拿到 Jev 的 API(官方还在排队发放),所以这不是我的实测。演示和用法来自 01Coder(小木头)9 月 18 日那期实测视频,我做的事情是把里面每一个数字和说法回到一手页面重新核一遍,并补上一些视频里没展开的东西——主要是官方自己写在脚注里的那些话。
Jev 是 TypeSafe AI 9 月 15 日发布的模型,当天在 Hacker News 上开了帖,今天已经 1917 分、502 条评论(视频录制时是 1679 分,这几天还在涨)。它的特别之处一句话能说清:它不生成文本。
你给它一段「状态」(一条工单、一段对话、一个 JSON 对象),再给一组带类型的问题,它并行把所有问题一次答完,每个答案都是预先定义好的类型,并且附一个概率。官方演示里最直观的是让它玩 DOOM——每秒约 10 次决策,往前、往左、开火还是躲,它不看画面只读游戏状态,一个字都不说。
它只回答三类问题:Choice(从给定选项里选一个,返回选中项 + 每个选项的概率)、Score(按一个有序的评分表打分,比如平静 / 不耐烦 / 愤怒,返回各档概率并插值出分数)、Noul(「这句话为真吗」,返回 0–1 的概率;在 Vercel 的 SDK 里它就叫 boolean)。三类可以混在同一次请求里,对同一段状态并行评估、互不干扰。
💰 为什么现在会有人做一个「不说话」的模型
这事得从钱说起。今天软件里有大量决策根本不需要一段话:这条工单转给谁、这条评论是不是垃圾、这个请求该交给便宜模型还是贵模型。用语言模型干这个,你得让它先写一段解释、再吐一个 JSON,然后你的代码去解析——慢、贵、还可能格式出错。
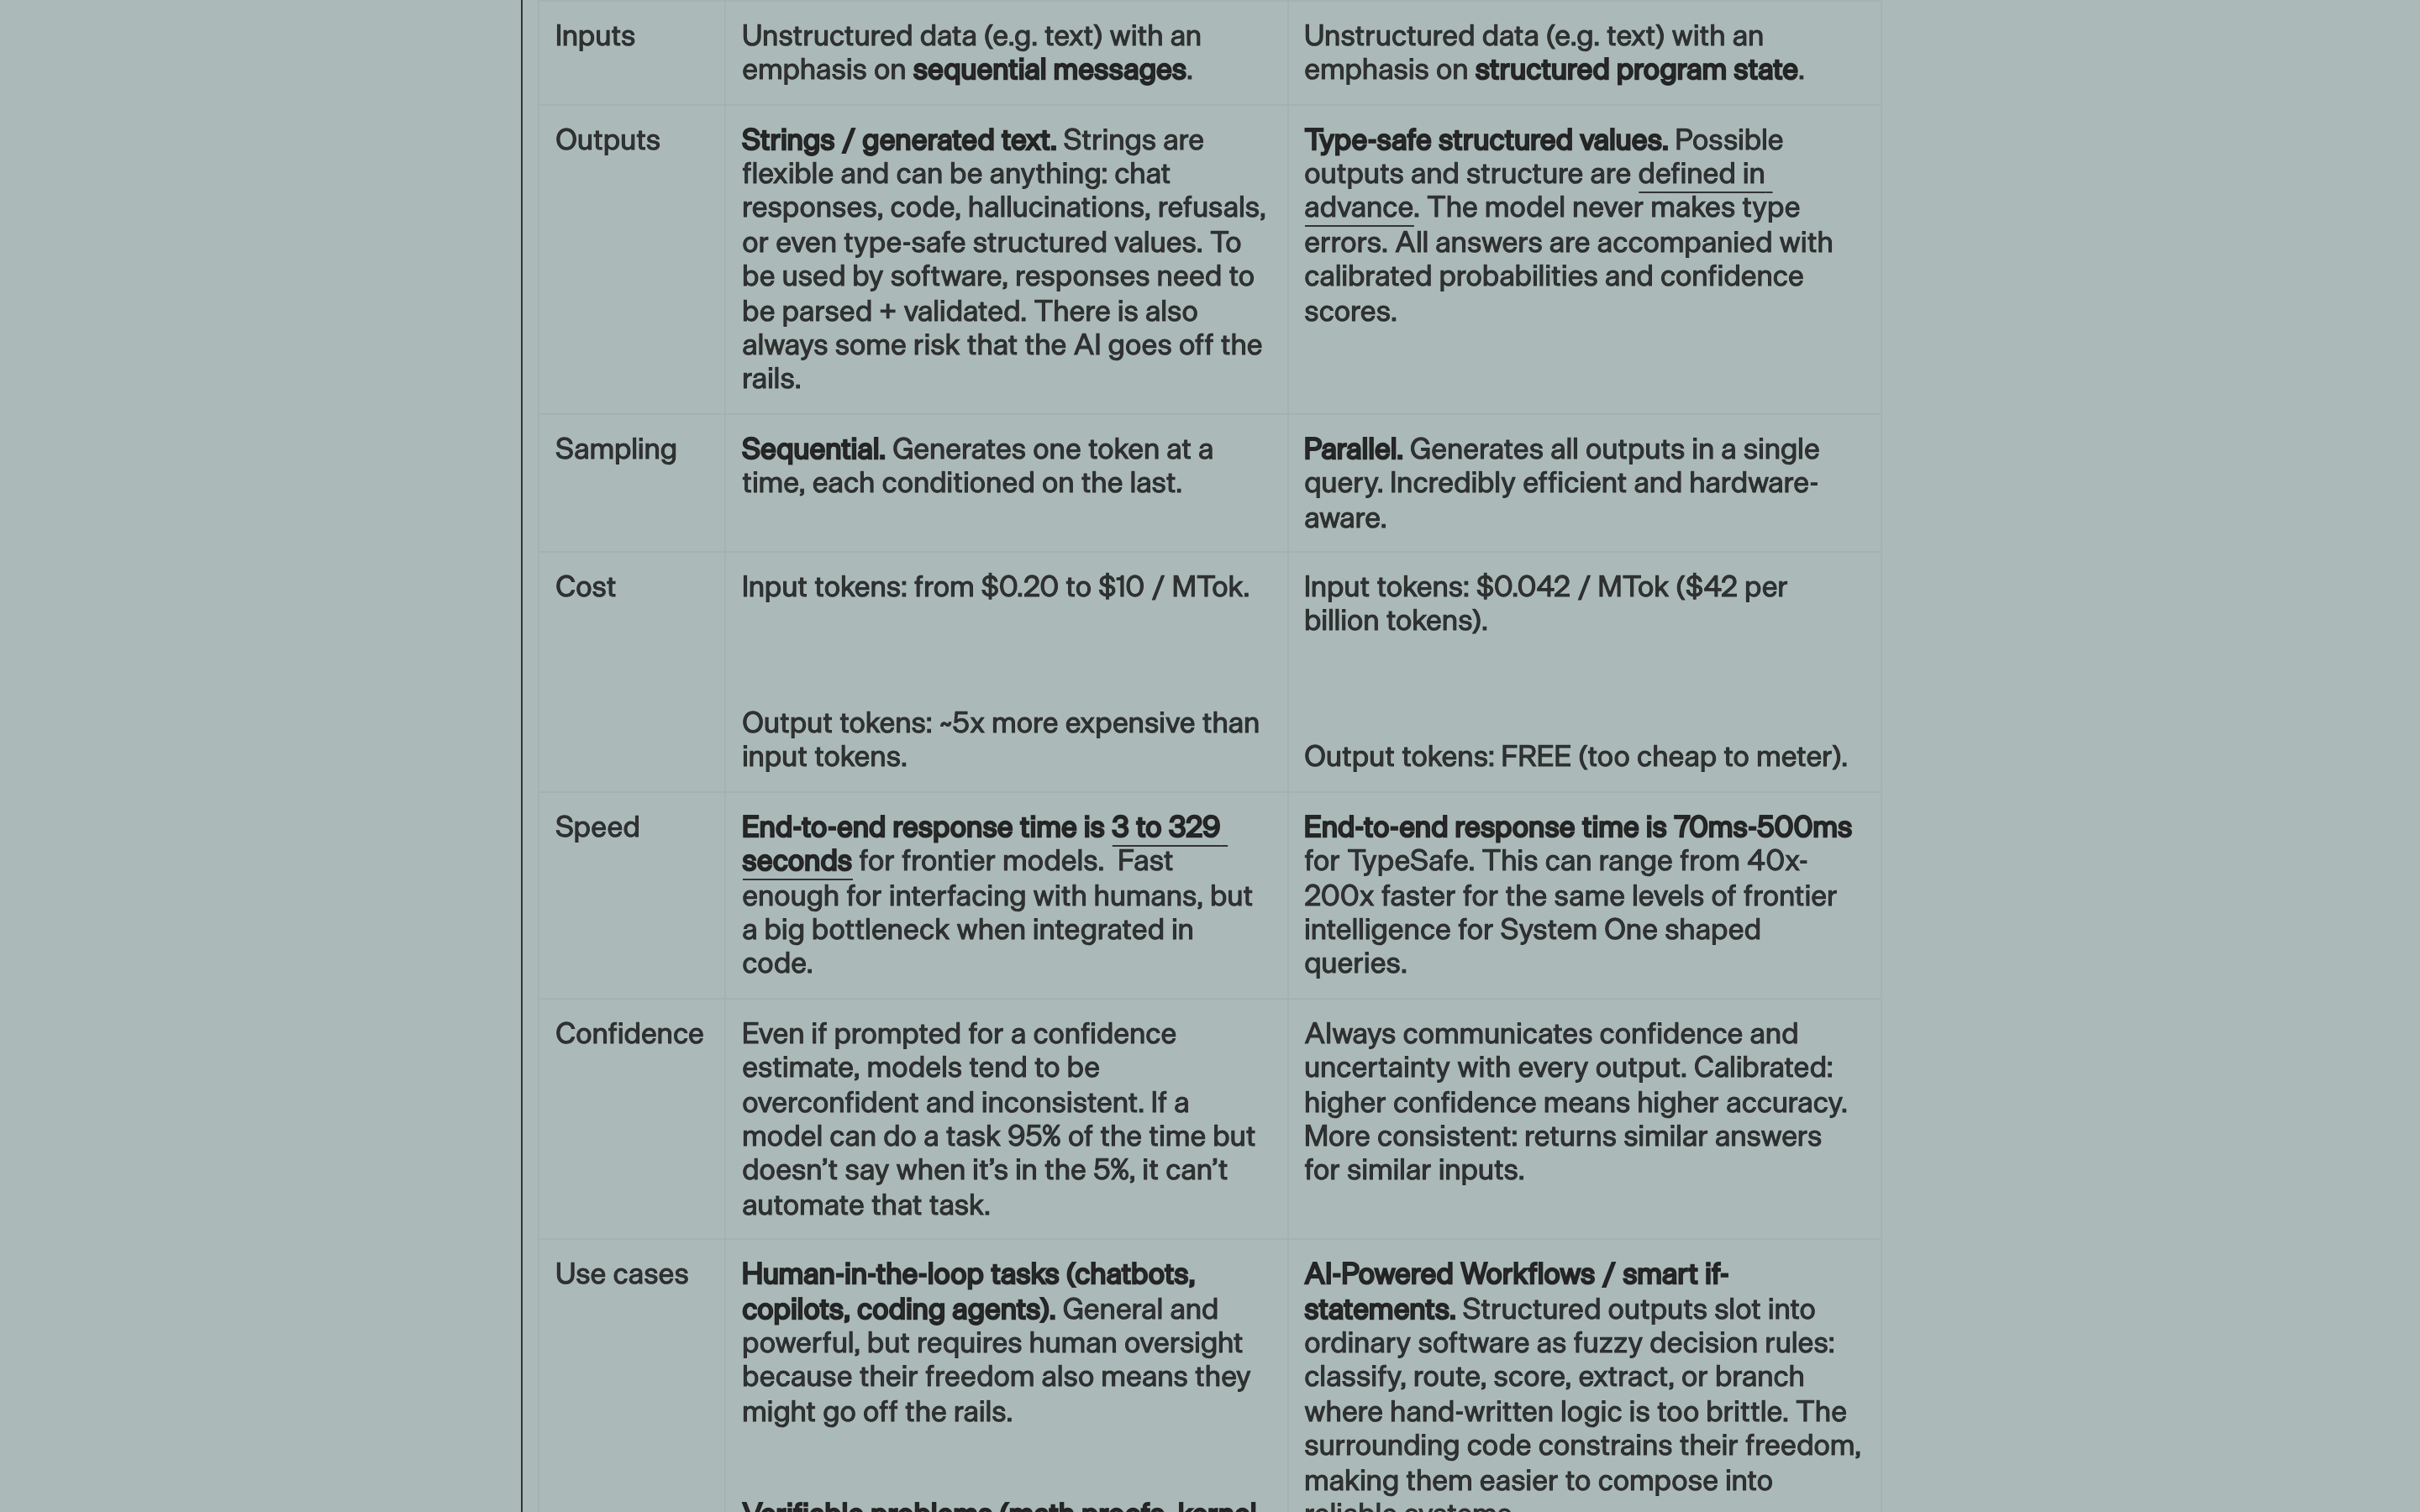
**这段没人读的解释,谁买单?**当然是调用方。按官方给的对照口径:语言模型输入每百万 token 要 0.20 到 10 美元,输出还要贵上约 5 倍;而 Jev 输入 0.042 美元,输出免费——因为它压根没有输出 token。所以这门生意的逻辑很清楚:把「判断」从按字计费的生成里拆出来,单独做成一层。受益的是每天要做成千上万次小判断的应用方,代价落在把这层外包出去的人身上——你的判断逻辑从此住在别人的服务器上。
这套剧本并不新鲜。早在大模型之前,这些活儿是正则和规则引擎干的;后来换成机器学习分类器;再后来大家发现「写个提示词就能分类」,于是又全搬回语言模型。每一轮的卖点都是「更通用」,每一轮的代价都是「更慢更贵」。Jev 是把摆锤往回推的一次尝试——通用性交出去,换确定性和速度回来。
厂商图什么也不难看出来:**抢「决策层」的接口标准。**Vercel 在它发布第二天就把它接进 AI Gateway,自家智能体框架 eve 的 auto()(给几个模型和一句描述,自动挑一个)背后直接用它来选。谁定义了这层调用形态,谁就站在了所有 AI 应用的必经之路上。
🔍 官方倍数的水分,是官方自己标出来的
发布页首屏那两个数字很唬人:**快 193.6 倍、便宜 444.6 倍。**但把博客往下拉,官方在自己的 Nuance(说明)段里写了这么几句——我把它们逐条摘出来,因为这比任何第三方的质疑都更有分量:
- 关于那两个倍数:「我们预计这些数字处于真实收益的偏高一端」——也就是说,首页写的是上限,不是你会拿到的。
- 关于对照组:语言模型那一侧的数据取自 OpenRouter,官方自己承认「几乎肯定存在偏差」。
- 关于测试口径:这次对比用的输入相对较短,官方写「这让我们的模型显得更有利」。
- 关于唯一的分歧题:与 GPT-5.6 Terra 的那次录制对比中,两者只在「流失可能性」一题上不同,而官方自评「那题的答案确实有歧义」。
建议 **一家公司愿意在发布页上给自己的数字打折,这件事本身值得记一笔。**这套「发布页写上限、第三方一测就缩水」的流程并不陌生——上一次是本地推理引擎那批「比谁谁快 N 倍」的宣传,每家都在自己出的题上考了满分。但也别读成「所以数字是假的」——它说的是口径:那些倍数在他们挑的工作流上成立,换到你的场景会缩水。视频里提到的独立审计也是同一个方向:官方说 20–400 倍,独立测下来 5–25 倍;官方说端到端 70–500 毫秒,海外测出来 1.6–3.7 秒(网络差异占很大一块)。
还有一条更要紧的,官方在对照表里写了「永不产生类型错误」和「不会幻觉」。前半句是真的,而且是数学意义上的真——输出被约束在你给的类型里,跑不出去。但「不会幻觉」这句要拆开看:**类型安全保证的是接口,不是真相。**早在 function calling 和 JSON mode 出来那阵,「结构化输出不会出错」也承诺过一轮,那次保证的同样只是格式——参数填错、字段编造,一样都没少。它保证答案一定是你给的选项之一,不保证选对。
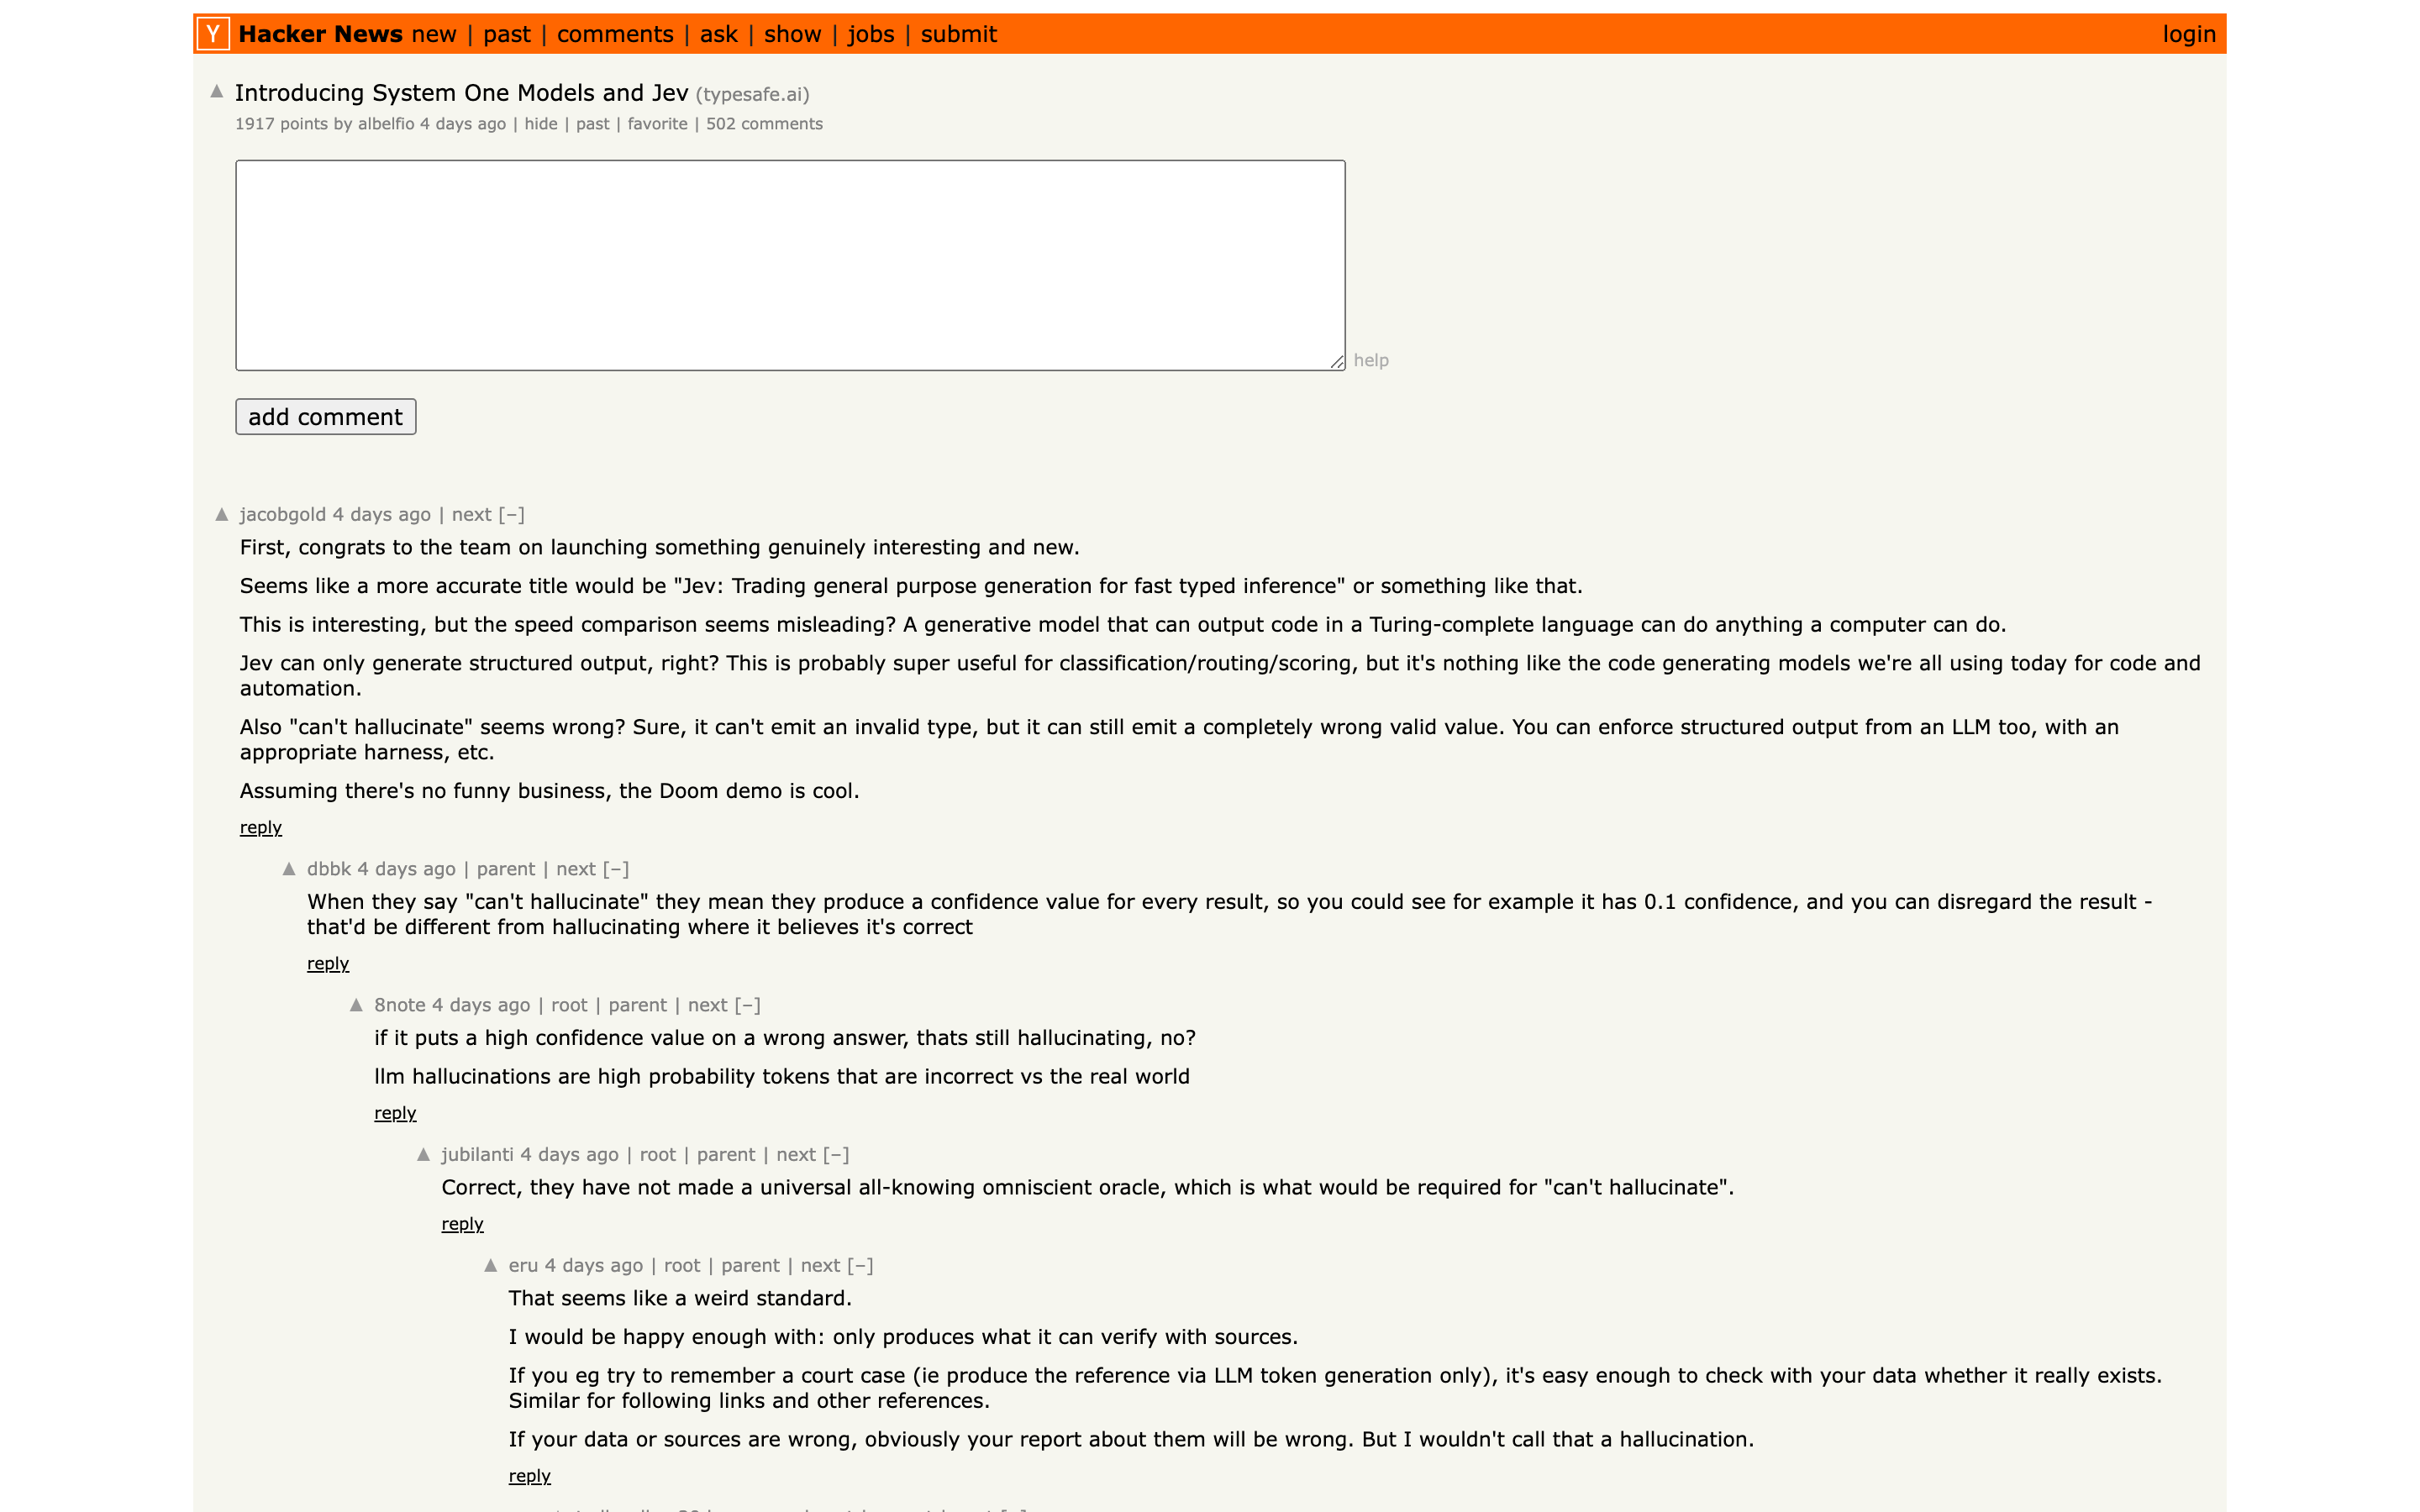
而整个产品最核心的卖点——校准(它说 80% 把握时,是不是真有 80% 的正确率)——恰恰是目前最难验证的一项:没有公开的校准基准可查。所以这块只能落到一句朴素的建议上:拿你自己有标注的数据去测。
🛠 现在就能上手:Vercel 上免费,还剩 5 天
官方 API 还在排队发放,但不用等——**Vercel AI Gateway 已经接了,而且现在是免费的。**我核了它的模型页:价格一栏直接写着 Free,上下文 32K,页面上明写「促销定价在 2026 年 9 月 25 日结束」。今天 9 月 20 号,也就是说白嫖窗口还有 5 天。
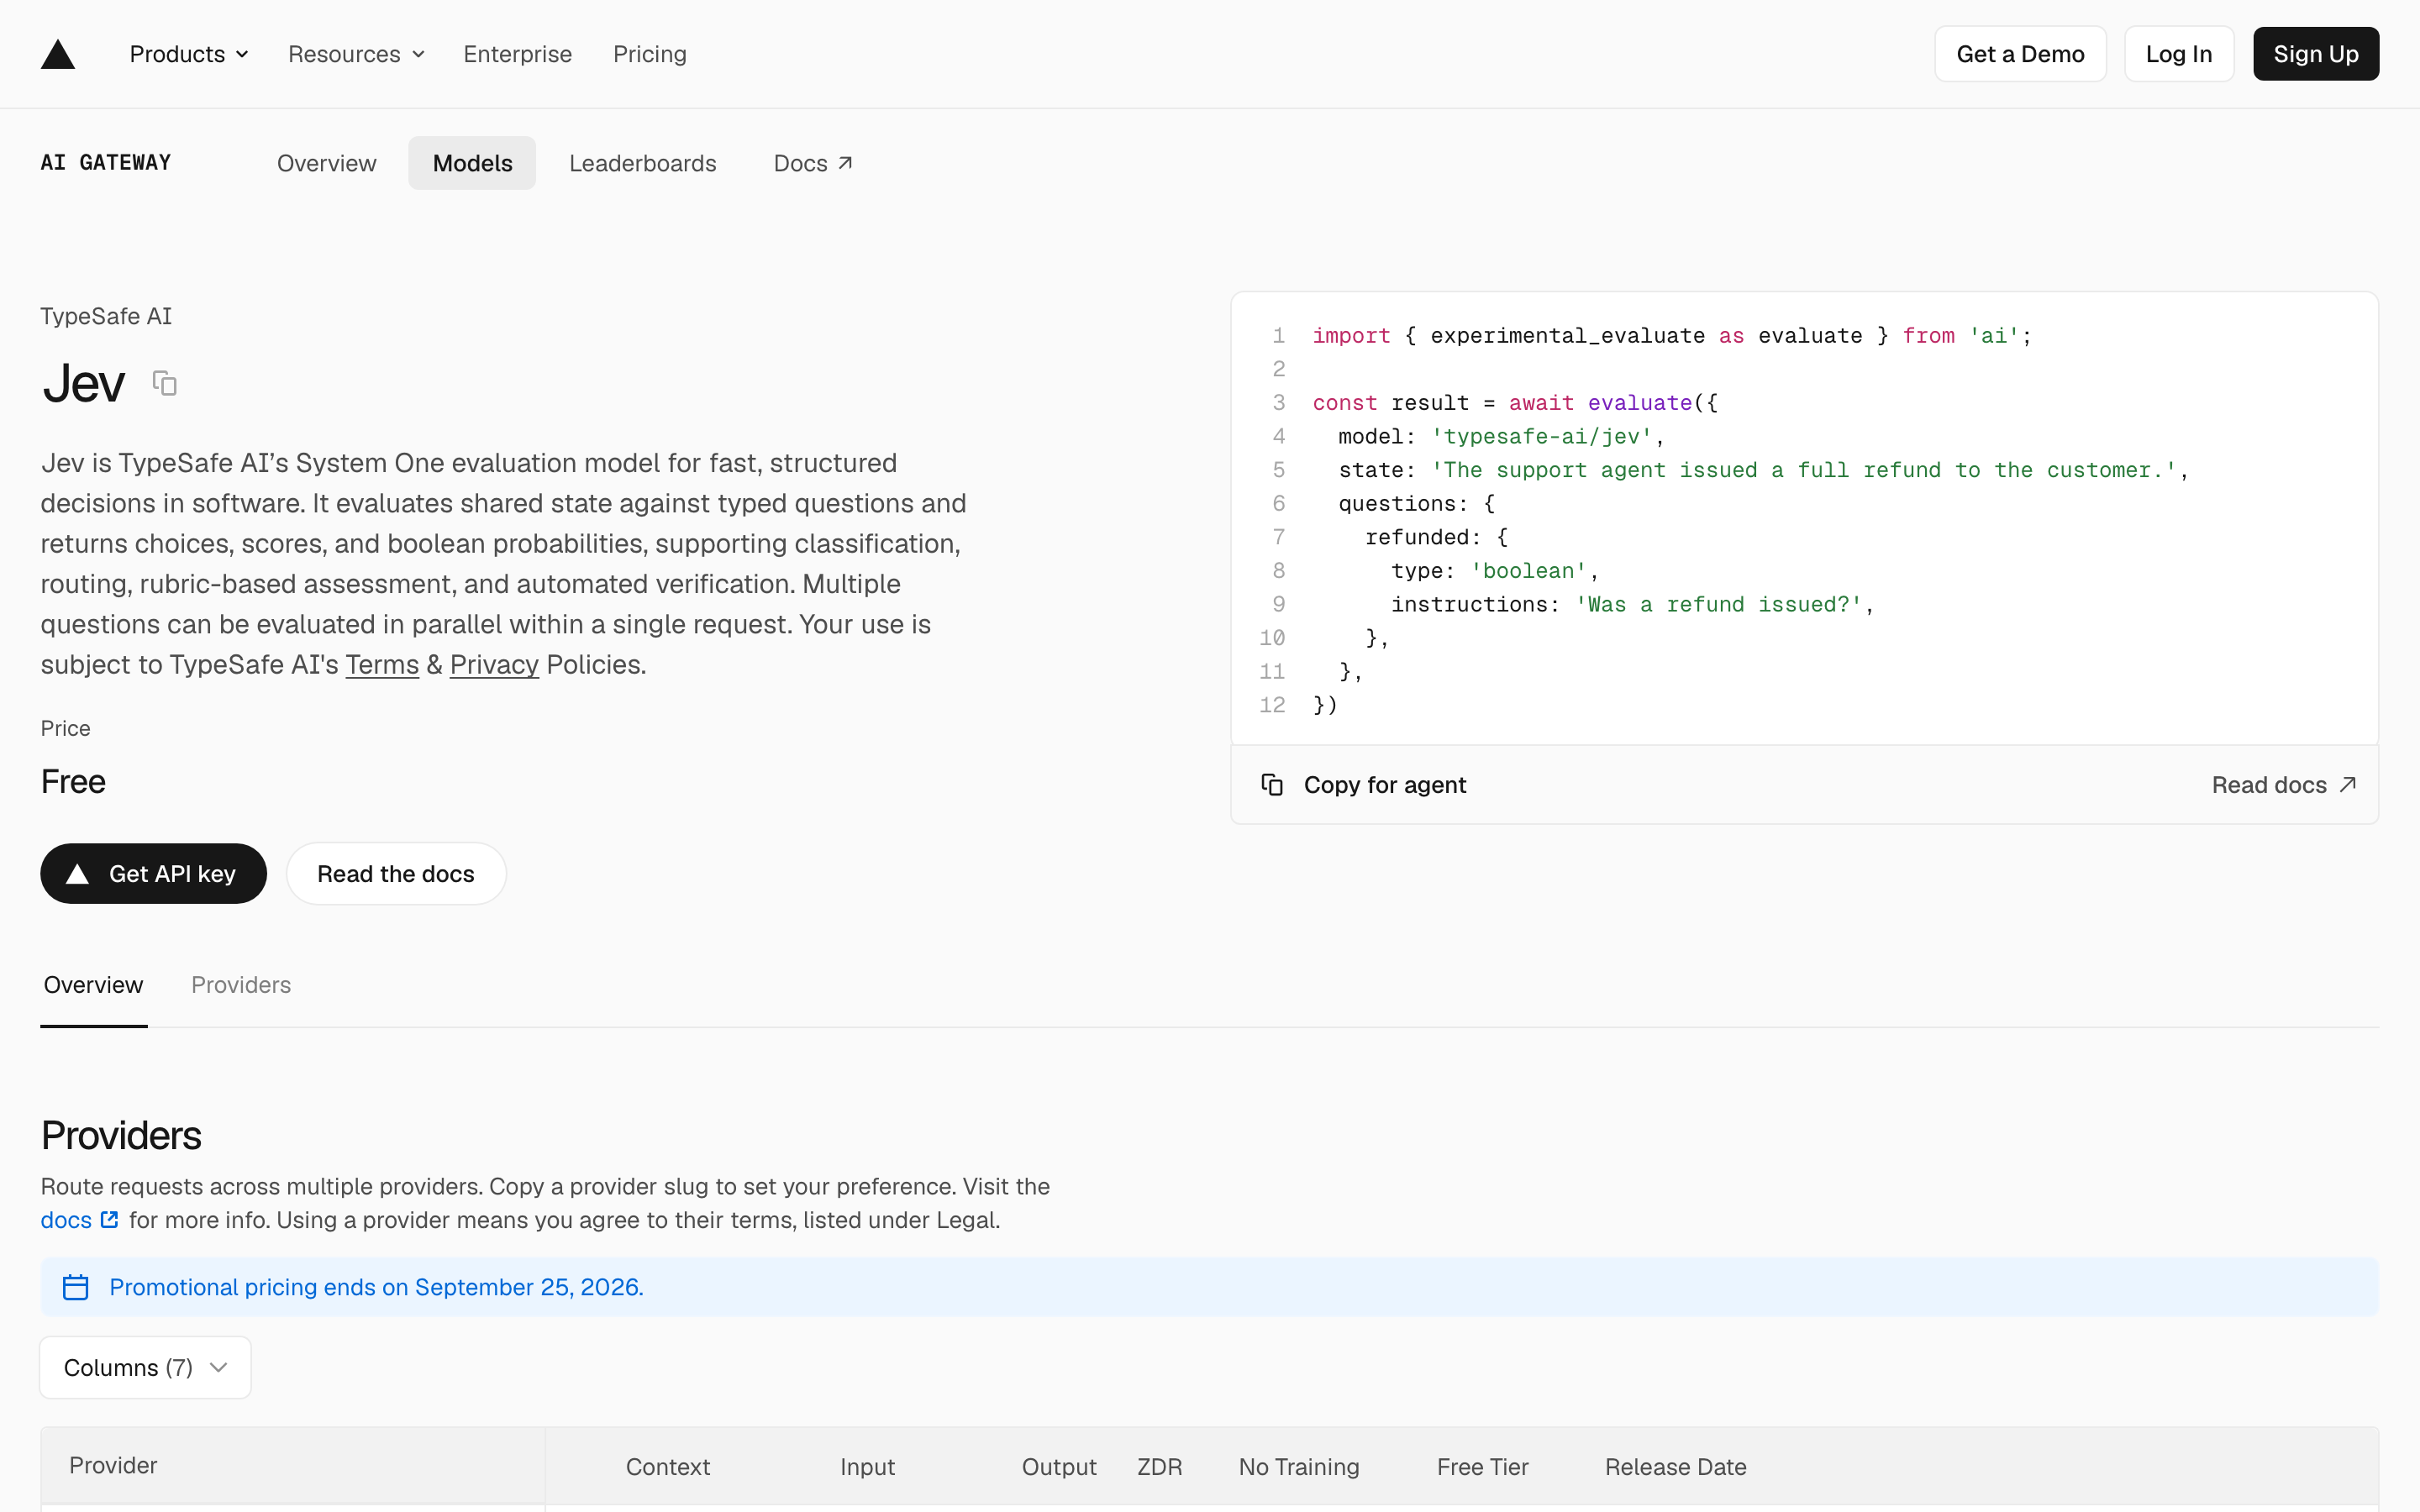
调用上有个坑要先说:它不能走 OpenAI 兼容的 endpoint,必须用 AI SDK 的 experimental_evaluate。模型 ID 是 typesafe-ai/jev。最小的一次调用就是官方示例那样:传 model、传 state、传 questions,拿回 answers 和 usage。
用法上真正要改习惯的是这三条,它们和大模型时代的直觉正好相反:
| 大模型时代的习惯 | 这里应该怎么做 |
|---|---|
| 先问类别,拿到答案再决定下一个问题 | 一次把所有问题都问掉,包括只在某些分支下才有意义的——并行没有额外代价,回来以后代码只取相关的那几个 |
| 让模型在长上下文里连环推理 | 把复杂决策拆成一组原子问题一次全问,剩下的逻辑交给你的代码 |
| 到处设置 confidence 阈值 | 只是要选最优就直接取概率最高的那个;阈值只用在一个地方——低于它就转人工(官方叫 confidence-gated routing) |
警告 一个容易读错的细节:**Noul 的概率接近 0.5,意思是「是」和「否」各占一半,不是「程度中等」。**同理,confidence 高只代表这次概率分布集中,不代表你整条流程是对的。
如果你打算让 Claude Code 这类编程智能体替你接,官方备了一份 skill:仓库 typesafe-ai/skills。我核了一下时间线——这个仓库 8 月 24 日就建好了,比模型发布早了三周,现在 813 颗星;skill 本体就一个 SKILL.md,正好 149 行。
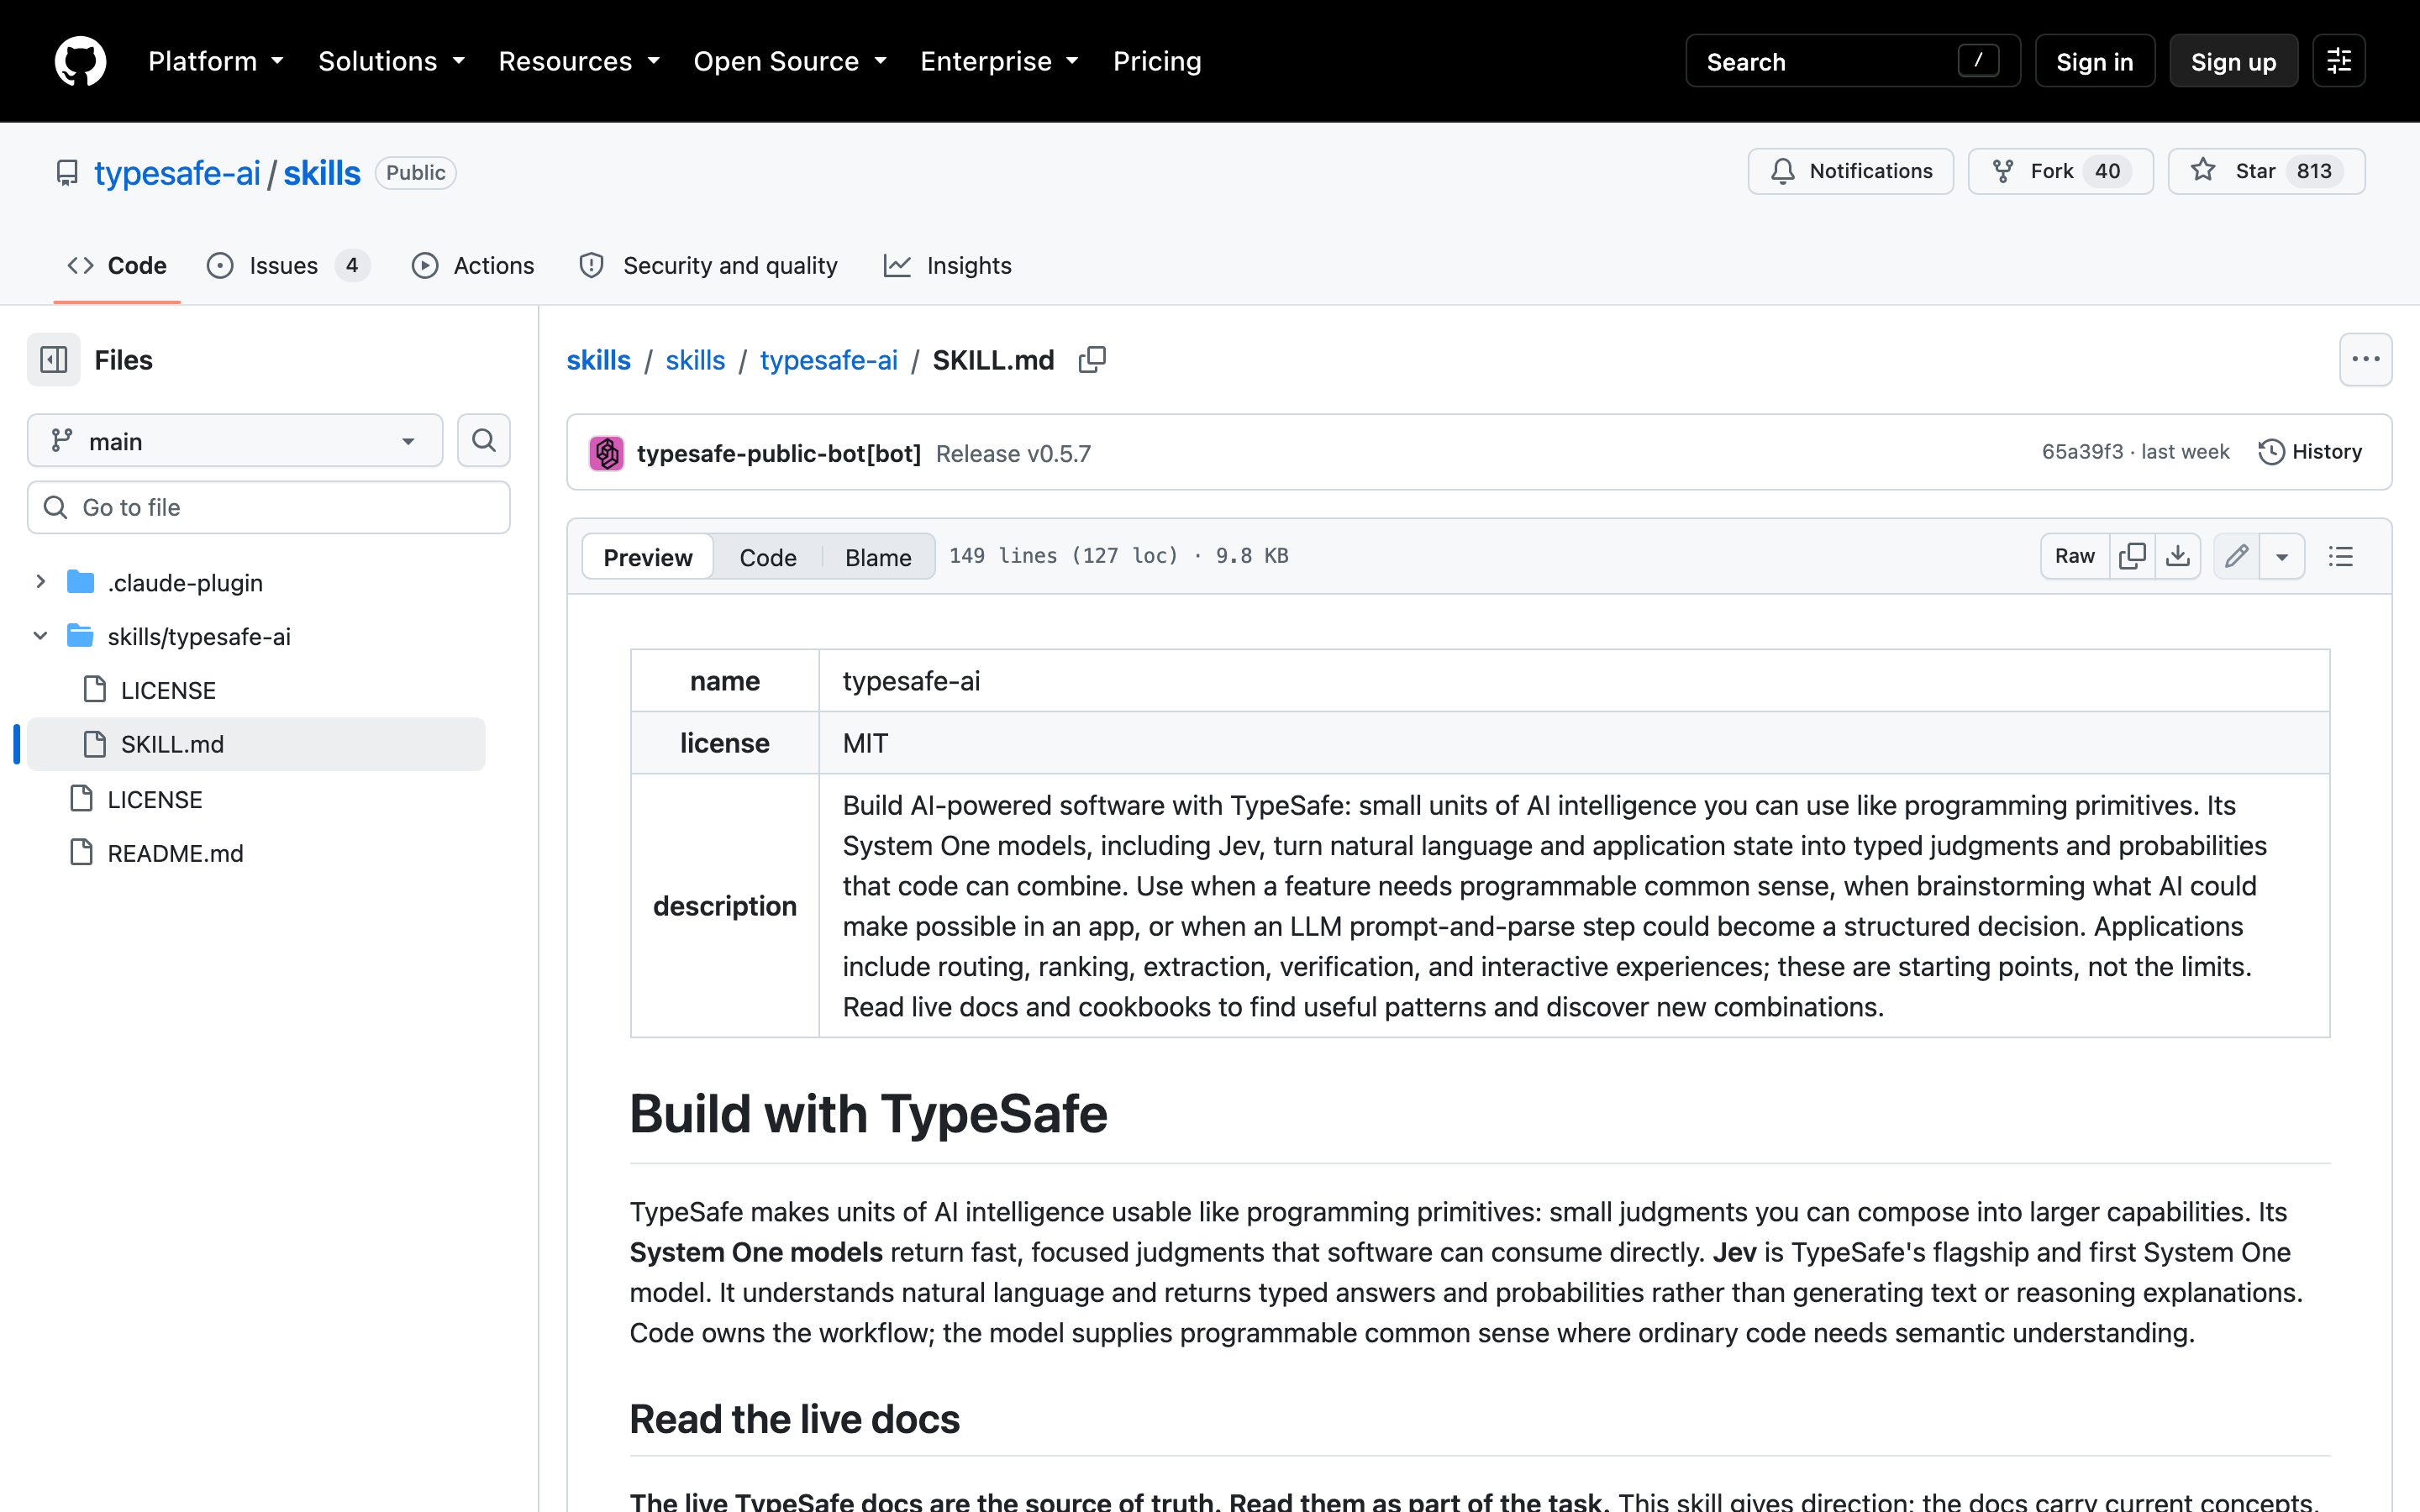
它的写法本身值得抄:不把文档塞进上下文,而是列一张「想做什么读哪一页」的表让 agent 按需去读(文档地址后加 .md 就能拿到 Markdown 版);然后教 agent 怎么拆需求——从「界面要展示什么、要选择什么、要改变什么」倒推需要哪些判断,规则计算、精确查表、执行动作全留在代码里,只在需要语义理解的地方放一个问题。
⚠️ 什么时候别用它
- 需要解释的场景:它给不了理由,只给概率。
- 需要生成的场景:它不写字。它不是用来替代语言模型的——语言模型负责生成,它在后面负责判断这段能不能发。
- 选项设计不好的场景:这条最隐蔽。正确答案不在你给的选项里时,概率仍然会落在剩下的选项上,它必须选一个。官方自己也承认,难的部分是从「写提示词」变成「设计决策模式」。
- 隐私敏感的场景:闭源、托管 API、没有权重。社区已经有人在用 Qwen 微调带校准概率的小模型做开放权重复刻,想本地跑的可以盯着这条线。
🧭 我的判断
这类模型解决的是一个真问题:**我们确实在用一台会写小说的机器,去回答一个是非题。**把这层拆出来是对的方向。Vercel 发布第二天就接了;社区清单也在猛涨——视频录制时说 40 多个项目,我今天数了一份社区清单,里面指向 GitHub 的条目已经有 161 条(这类清单还不止一份,而且清单自己在开头就写着「收录不等于背书」)。痛点是真的。
但我不会仅凭发布页的数字就把它接进关键路径,理由就是上面那条:**最值钱的卖点(校准)是目前唯一没法公开验证的。**便宜和快是真的,类型安全是真的,「答案对不对」得你自己在自己的数据上测。
所以可照做的办法就一条,也是这篇最该带走的东西:趁 9 月 25 日之前免费,拿你手头真实的分类或路由任务,挑几十条已经有标注的数据跑一遍,把它给的概率和你的标注对一下——高概率的那批是不是真的更准。对得上,再谈要不要接进系统;对不上,你省下的就不只是这几天的额度。
摘要:一句话收尾 Jev 把语言模型从「写一段话」退回到「选一个选项」:输入 0.042 美元每百万 token、输出免费、类型上不可能出错,官方却在自己的脚注里承认首页那两个倍数是收益上限、对照数据有偏、短输入对自己有利。它值得试,但最核心的「校准」目前无人能公开验证——所以趁 Vercel 免费窗口(到 9 月 25 日)用你自己的标注数据先测,再决定要不要让它替你做决定。
📚 来源
本文的框架、演示场景与使用要点来自 01Coder(小木头)的实测视频,特此致谢;文中所有数字、日期与引文均已回到一手页面核对,配图也全部取自一手页面而非视频画面。
- TypeSafe AI 官方发布博客《Introducing System One Models & Jev》(2026-09-15):https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Hacker News 原帖(发布当日):https://news.ycombinator.com/item?id=49717558
- Vercel AI Gateway 的 Jev 模型页(定价与调用示例):https://vercel.com/ai-gateway/models/jev
- 官方 agent skill 仓库 typesafe-ai/skills:https://github.com/typesafe-ai/skills
- 01Coder《Jev 实测:这款爆火的极速决策模型的基本玩法》(2026-09-18):https://www.youtube.com/watch?v=tYvu6IpSfiM
🧰 我做的工具
这些工具都由我持续维护。预览版会明确标注,下载、更新和已知边界以发行页为准。
信息:黑粉剪辑 HyphenCut 状态: 初步构建 · 预览版
Rust 写的本地专业视频剪辑:达芬奇键位、AI 助理直接改真实工程,免费
信息:黑粉盒子 HyphenBox 状态: 初步构建 · 预览版
免费大模型 API 雷达:持续复测可用性,本地统一接口,Key 只存本机
信息:方寸智匣 LocalBrain 状态: 正式迭代
本地模型的多模态 MCP 工具箱:TTS / Whisper / 视频生成一站接入
信息:ScreenLex 光影词库 状态: 正式迭代
看美剧顺手把生词背了,Mac/Windows 双平台,免费
信息:黑粉录屏 HyphenScreen 状态: 初步构建 · 预览版
录屏 + 智能剪辑一体:达芬奇式时间线、自动打码、导出前成片体检,免费
引用:黑粉科技 让AI成为你的超能力 本地部署 · 免费白嫖 · 自制软件 https://hyphentech.top