提示 本文首发于黑粉科技公众号
6GB 装下一台 27B Reasoning Mac
Ternary Bonsai 2 27B:5.93 GB 权重、98.2% 能力保留、M5 Pro 27.7 tok/s
提示 黑粉科技 · 官方文档整理 · 2026-09-19
9 月中旬,PrismML 释出 Ternary Bonsai 2 27B。我在写这篇之前没有在本机跑过它——今天的结论全部来自官方白皮书、HF 仓库与Bonsai-demo的 source of truth。本机实测与 LocalBrain 集成计划放在文末,先把部署路径、命令、关键陷阱一次交代清楚。
如果只看一组数字:官方白皮书封面写得很直白——~9.1× smaller / 98.2% intelligence retained / 46.8 tok/s on laptop。
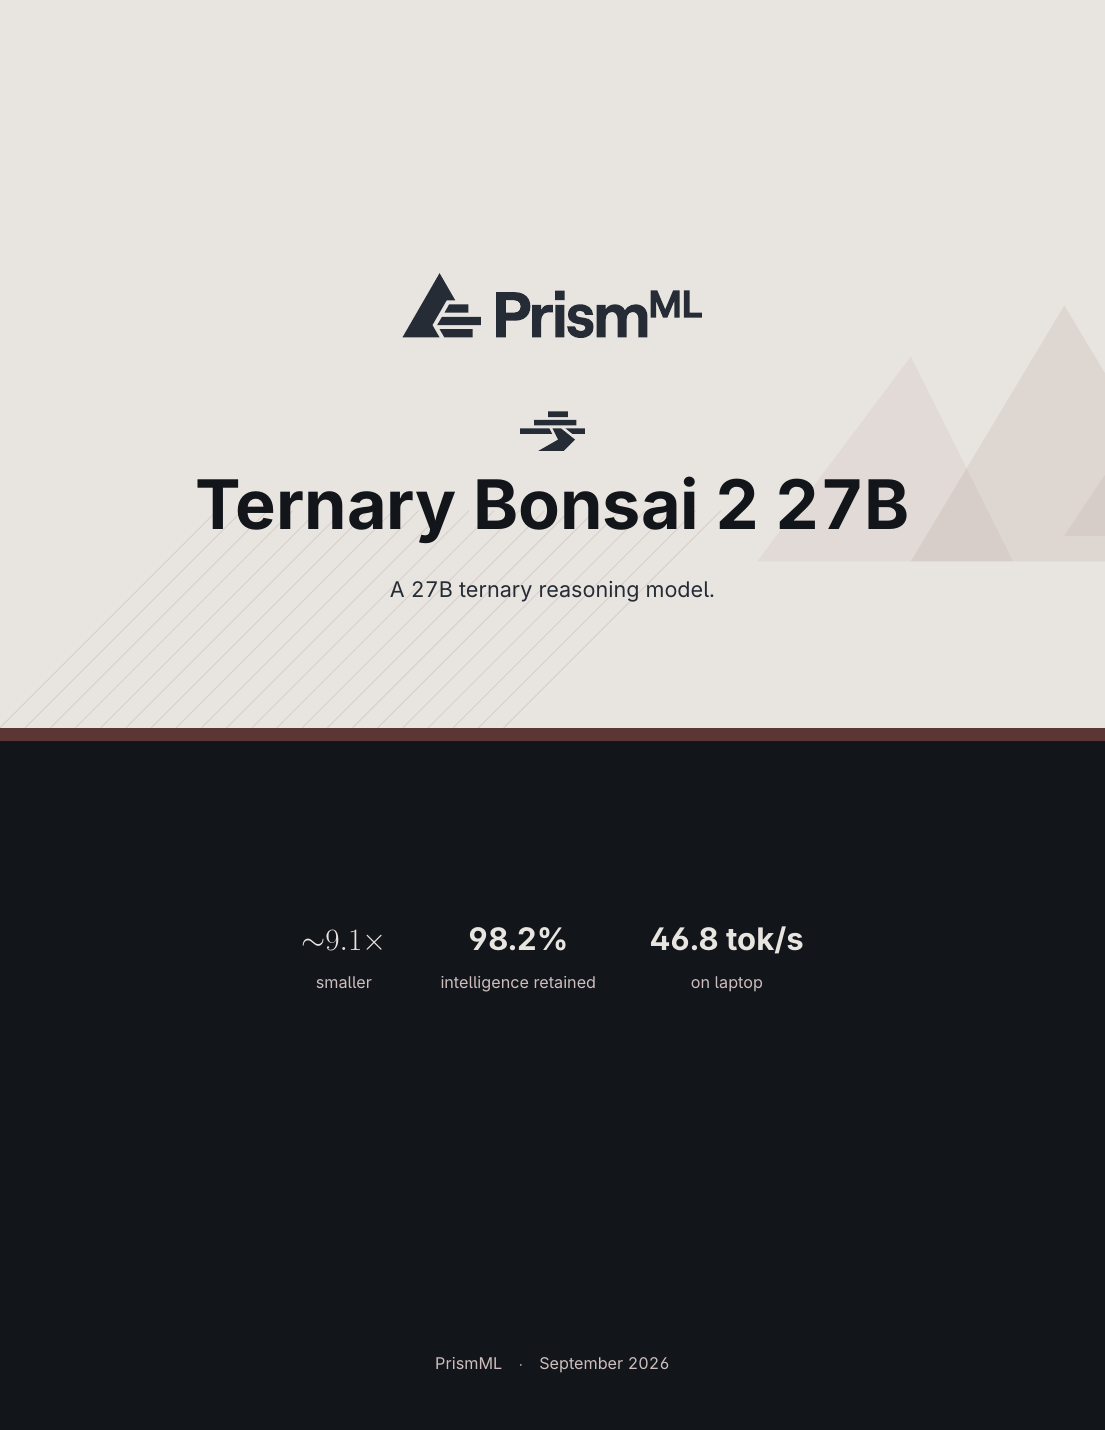
这个 6 GB 装得下、还能保持 reasoning 水平的判断不是我下的,是 Qwen3.8-27B 的 FP16 原始基线 85.4 → Bonsai 2 27B 的 83.9,平均下来只丢 1.5 分。
🎯 ▍它到底是什么
Bonsai 系列是 PrismML 把 27B 级别 hybrid-attention 语言模型三值化(ternary)后的产物。第一代 Bonsai 27B 用 1-bit(PTQ1_0 / Q1_0),第二代 Ternary Bonsai 2 27B 用 PTQ1_0 与 PQ2_0 两种 ternary 打包格式,文件更小、推理内核是 PrismML 自己 fork 的 llama.cpp 才认得。
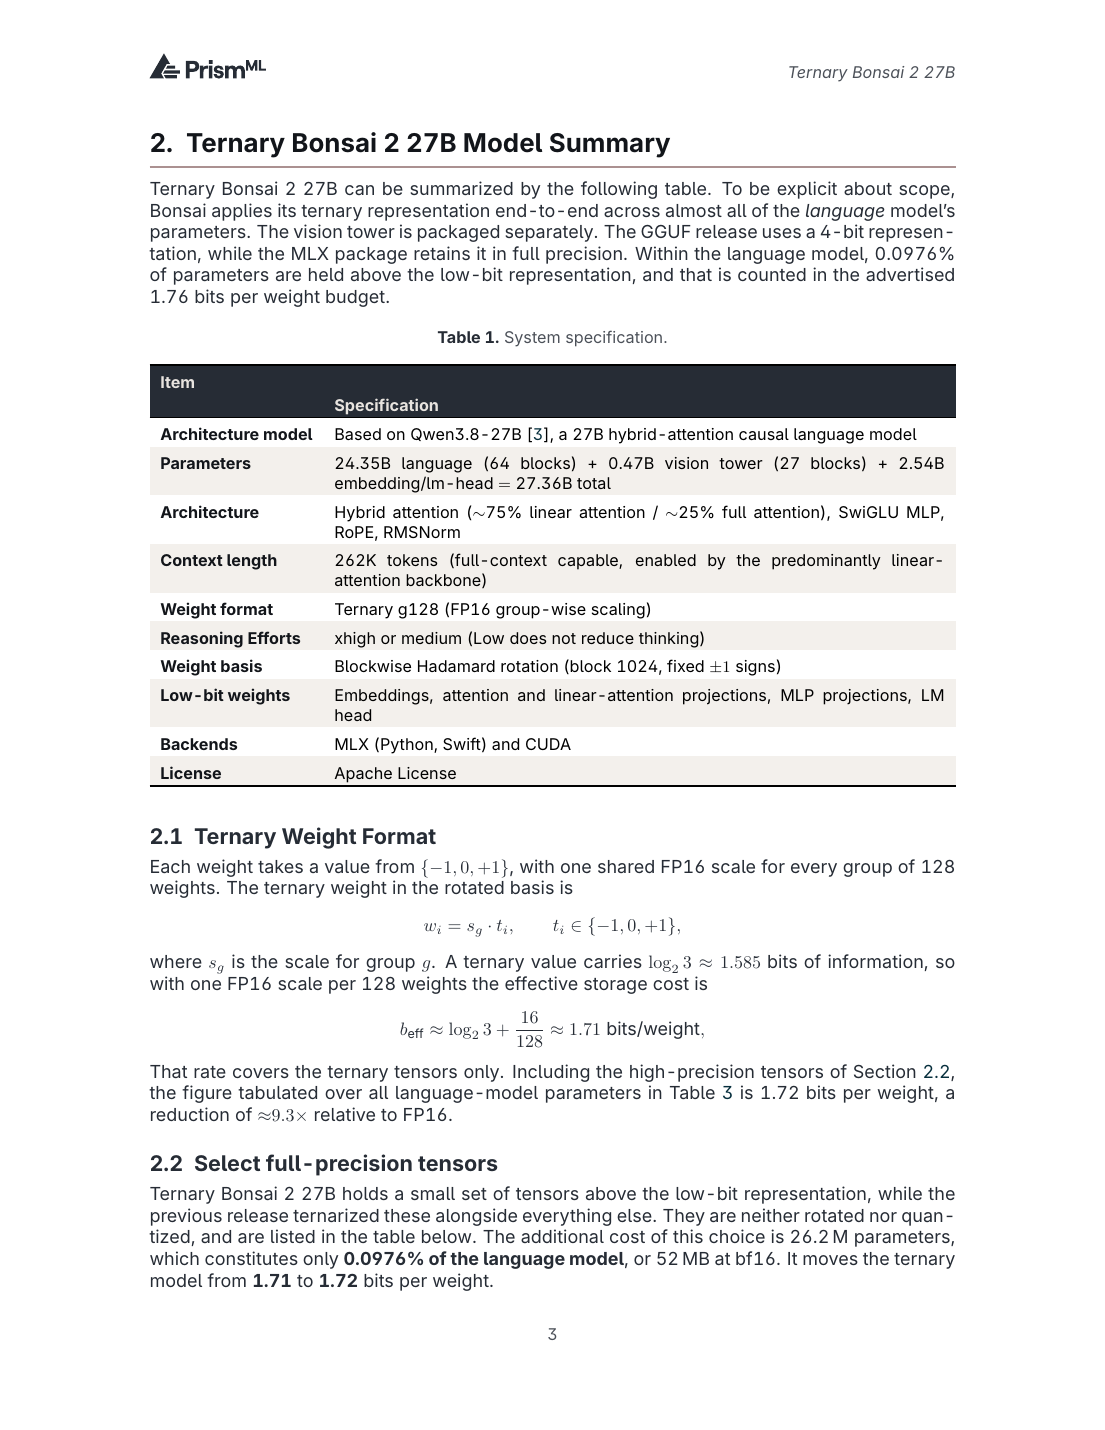
摘要:简单理解 普通量化是把每个权重塞进 2/4/8 bit。Bonsai 把每个权重压成 {-1, 0, +1} 三种值(ternary),再加一个 FP16 的 group scale(每 128 个权重一组),平均下来每权重只占 1.76 bit(PTQ1_0)或 2.16 bit(PQ2_0),相对 FP16 的 16 bit 缩小 9.1× / 7.4×。
但这不是普通的 1-bit / 2-bit 量化。Bonsai 的关键差异有三:
- 权重先做 blockwise Hadamard rotation(block 1024、固定 ±1 符号),再 ternarize。这让「应该被量成 0 的位置」与「应该被保留的位置」在数值上更容易分得开。
- hybrid attention:~75% linear attention + ~25% full attention,总参 24.35B 语言 + 0.47B 视觉塔 + 2.54B 词嵌入 = 27.36B。原生上下文 262 K tokens(linear 部分把 cache 控得小)。
- 保留 0.0976% 高精度张量(recurrent state path 里的 in_proj / conv1d / log / dt_bias / norm 等等),仅占 26.2M 参数、约 52 MB;这一小撮张量不 ternarize、不旋转,是模型不掉点的关键。
最终得到的两个数字:FP16 基线 53.80 GB → Ternary Bonsai 2 27B 的 5.93 GB(PTQ1_0)/ 7.25 GB(PQ2_0)。
许可证是 Apache License,可以商用、可以微调、可以私有部署,对本地化工具党是个干净的选择。
📦 ▍两个打包格式到底怎么选
白皮书 Table 3/4 直接给出官方建议:
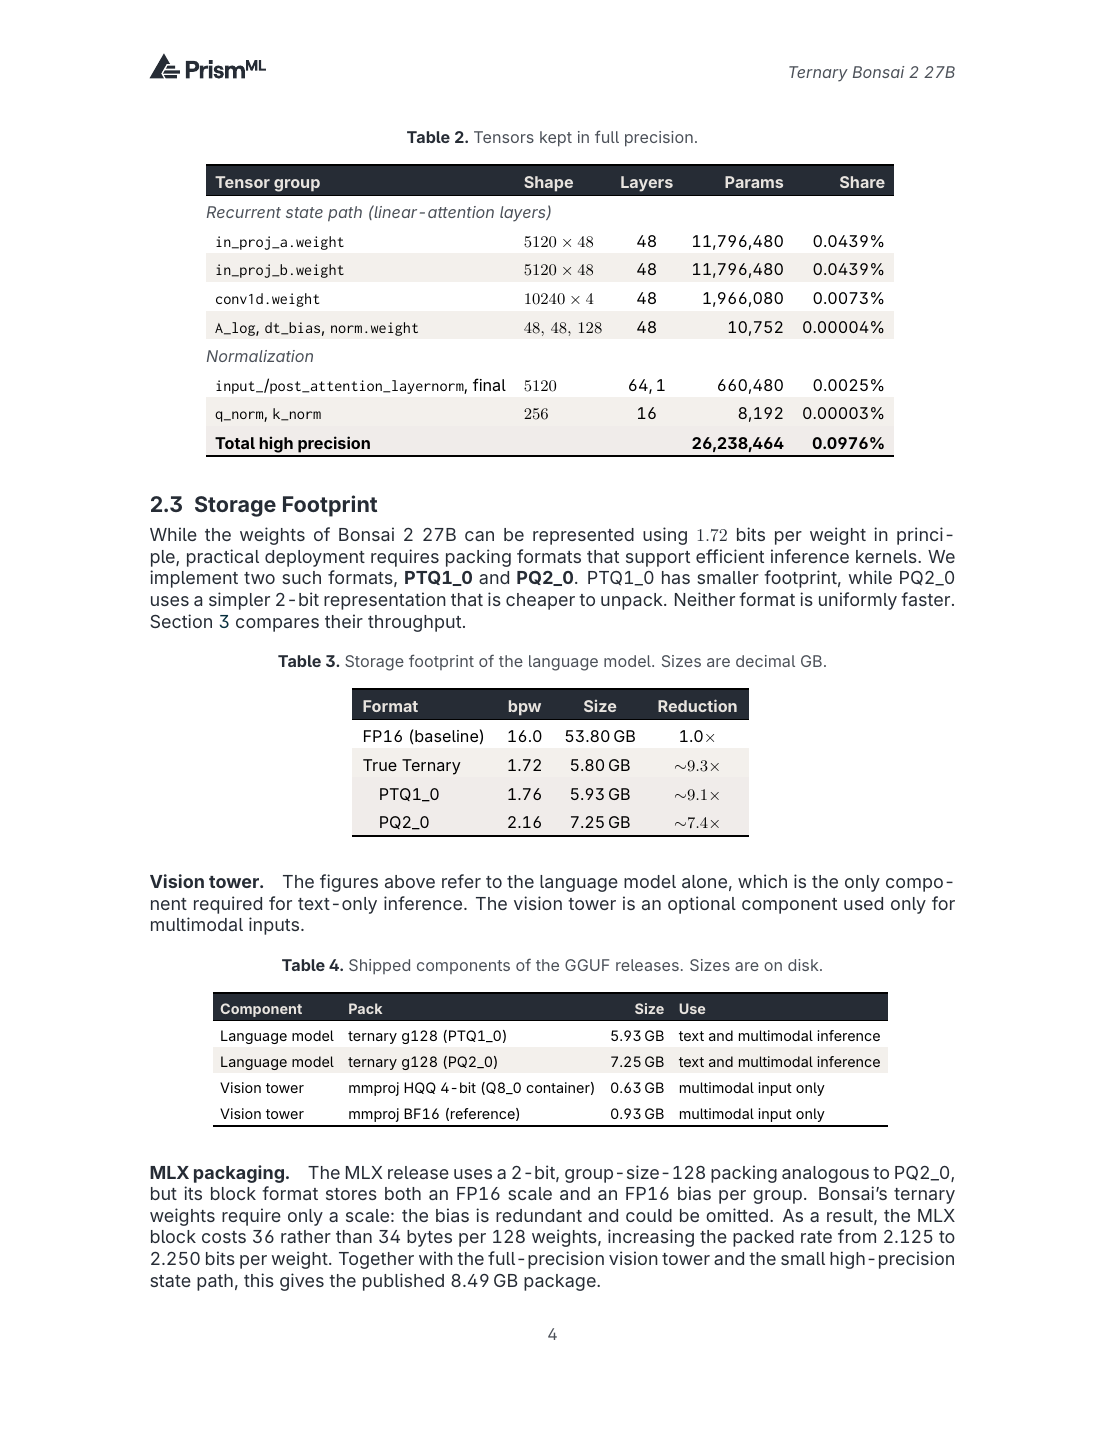
| 格式 | bpw | 体积(语言模型) | 何时用 |
|---|---|---|---|
| PTQ1_0 | 1.76 | 5.93 GB | 更小,Ada 架构更快;Ampere / Hopper / Blackwell / Apple Silicon 略慢于 PQ2_0 |
| PQ2_0 | 2.16 | 7.25 GB | 略大,但绝大多数平台(含 Apple Silicon)上 更快,是 Mac 部署的默认选项 |
| mmproj (HQQ 4-bit) | — | 0.63 GB | 多模态输入时才需要 |
| mmproj (BF16 参考) | — | 0.93 GB | 同上,更高精度 |
| MLX (2-bit, g128 + bias) | 2.250 | 8.49 GB | 走 MLX Python 路径时一整个包 |
实操结论很直接:
- 想要 Web UI / 本地对话,路径 A(llama.cpp fork + Metal)下 PQ2_0 + mmproj BF16,磁盘约 8.18 GB,M5 Pro 上 ~27 tok/s。
- 想写 Python 脚本集成、接 agent,路径 B(MLX Python)下载完整 MLX 包,磁盘约 8.49 GB。
⚡ ▍Apple Silicon 上能跑多快
官方在 llama.cpp 的 Metal backend(PQ2_0 包)上跑出的数字:
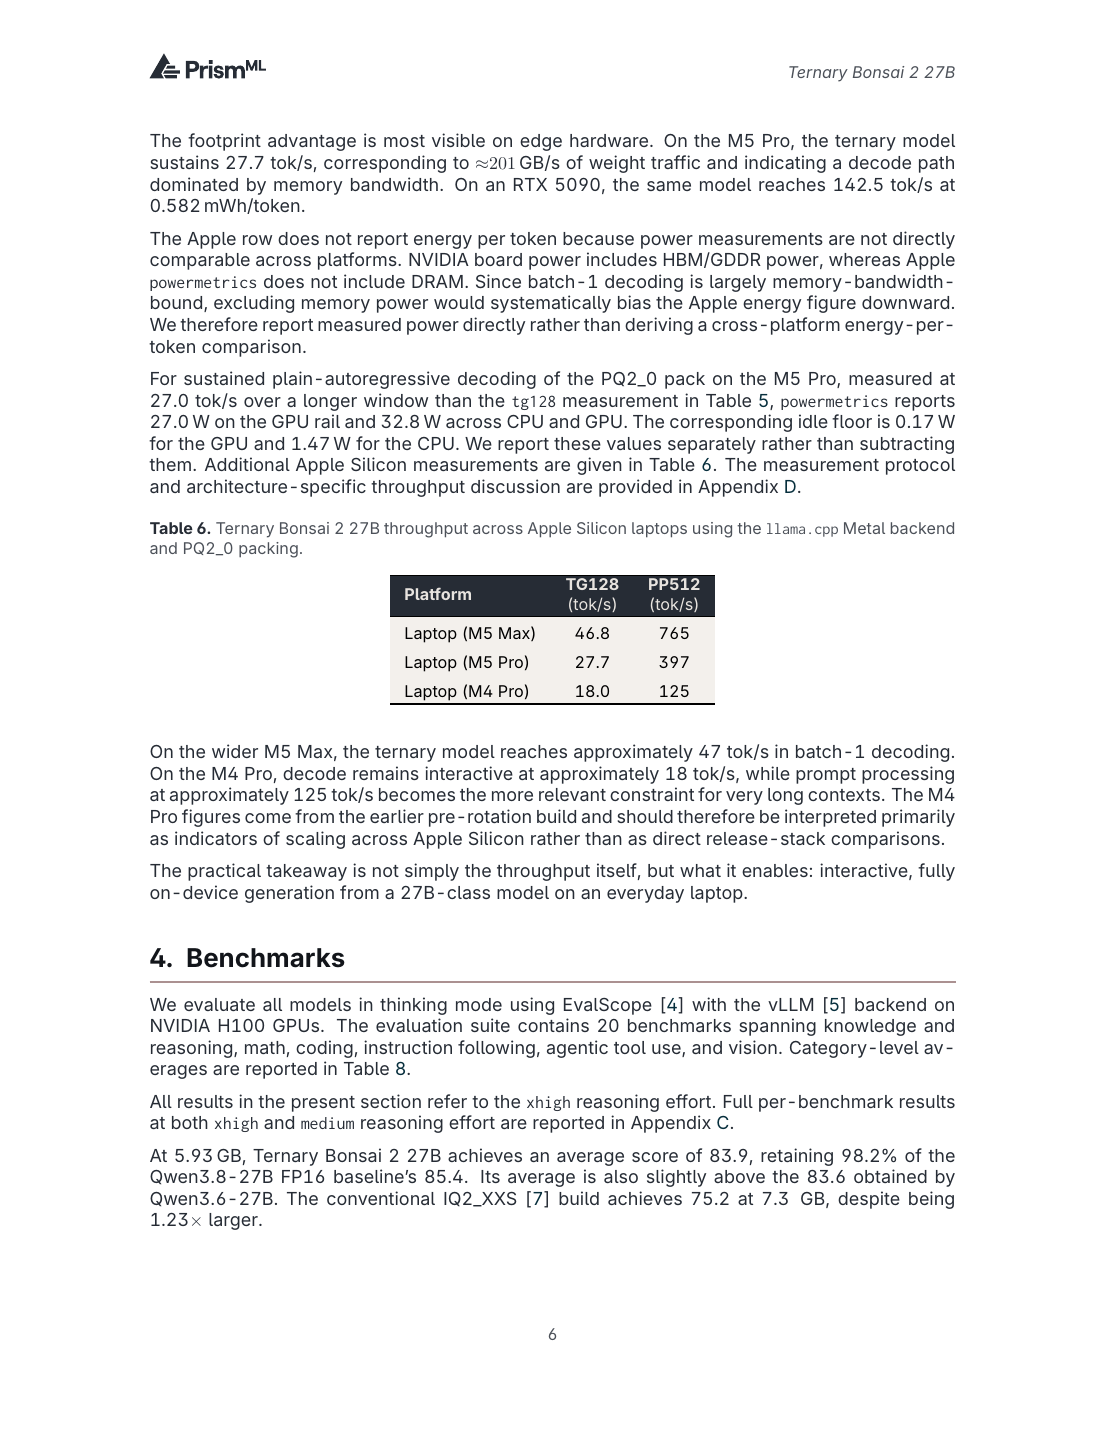
| 机型 | TG128 tok/s | PP512 tok/s | 内存门槛 |
|---|---|---|---|
| M5 Max / 36 GB+ | 46.8 | 765 | 全速 |
| M5 Pro / 24 GB+(本机) | 27.7 | 397 | 官方推荐 ≥24 GB |
| M4 Pro / 24 GB+ | 18.0 | 125 | 顺跑但要等 |
| 16 GB 机型 | 会 swap | — | 官方未列性能数据 |
Apple M5 Pro 的 27.7 tok/s 折算下来等于 ~201 GB/s 的权重吞吐——说明 Bonsai 2 在 Mac 上是 memory-bandwidth-bound,核心瓶颈是 LPDDR 带宽而不是算力。换句话说,想再快只能等更宽的内存总线,或者换 M5 Max。Apple Silicon 上还有一条补充事实:M5 Pro 上 sustained decode 测得 GPU rail 27.0 W、CPU+GPU 32.8 W,空载底噪 GPU 0.17 W / CPU 1.47 W——是那种「让它 24 小时跑、笔记本也不烫」的电耗区间。
🧪 ▍能力保留到底怎样
只看体积会被骗。Qwen3.8-27B 的 IQ2_XXS 也是 7.3 GB,但是 thinking-mode 平均只有 75.2 / 100。Ternary Bonsai 2 27B 是 83.9 / 100,只比 FP16 基线低 1.5 分。Compression 9.1×,能力只丢 1.8%。
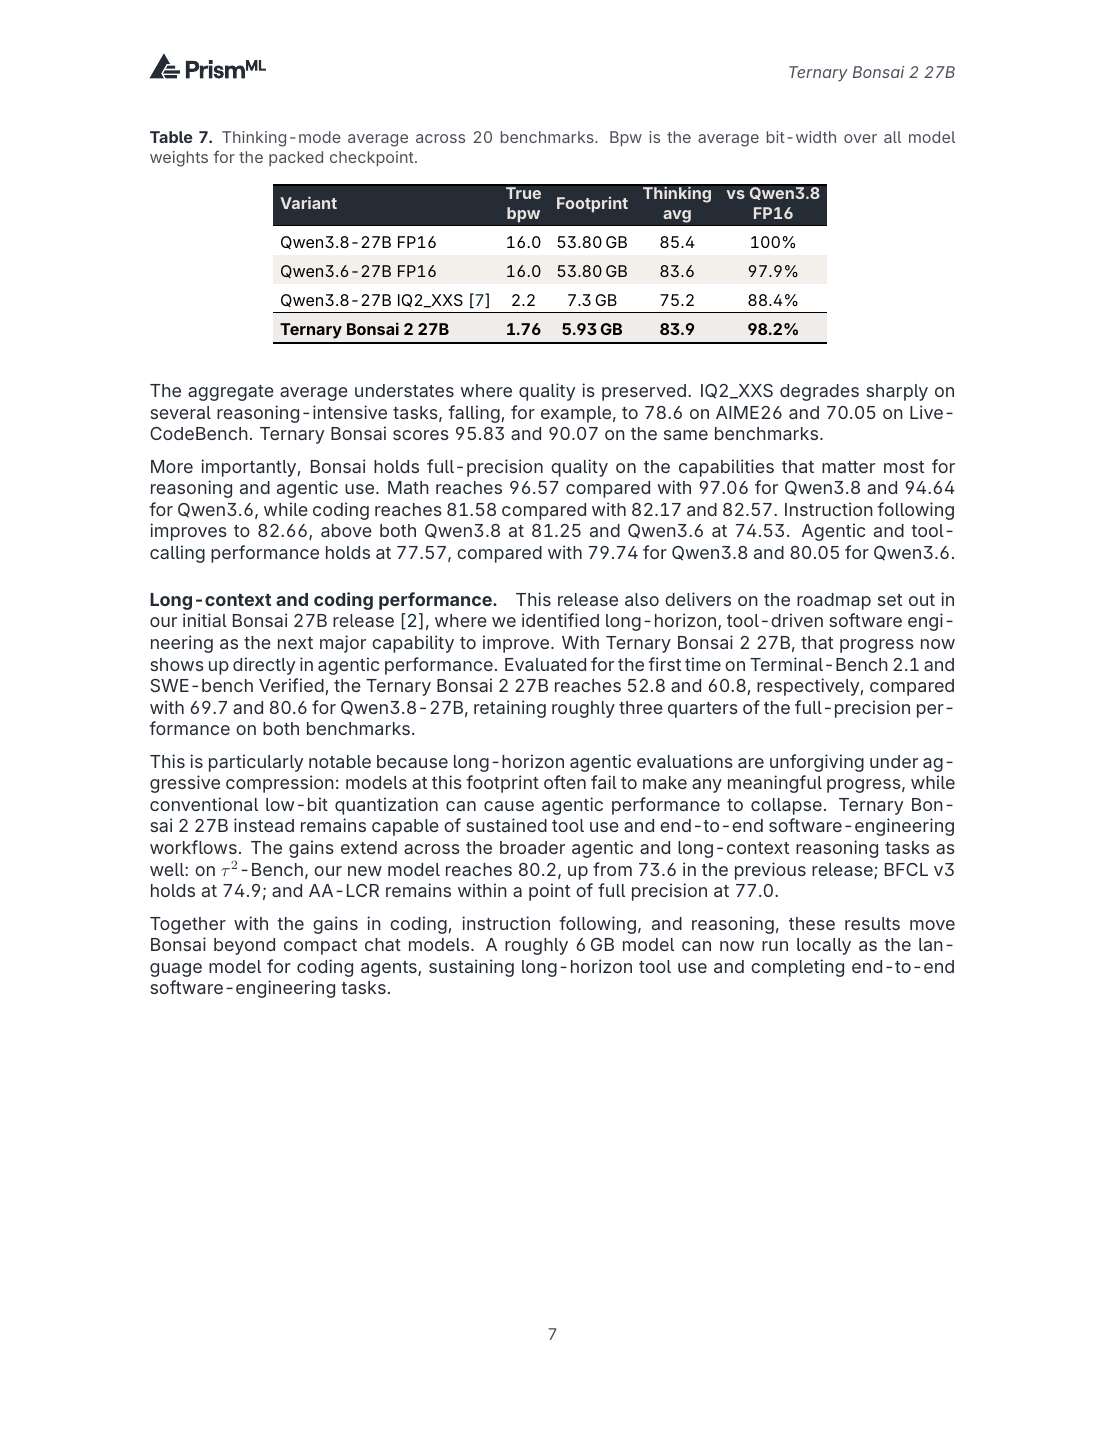
更值得注意的是 长上下文与编码:
- Terminal-Bench 2.1:52.8(vs Qwen3.8-27B 的 69.7,约 75% 保留)
- SWE-bench Verified:60.8(vs 80.6,约 75% 保留)
- τ²-Bench(agentic tool calling):80.2(上一代 73.6 → 这一代涨了 6.6)
- AA-LCR(长上下文推理):77.0,与 FP16 不到 1 分
白皮书原话:
A roughly 6 GB model can now run locally as the language model for coding agents, sustaining long-horizon tool use and completing end-to-end software-engineering tasks.
把这句话翻译给本地玩家:一台 64 GB 的 M5 Pro,已经可以拿来跑能「自己用工具」干活的 27B agent。
进一步看,官方引入了一个叫 intelligence density(1/GB) 的指标——把 benchmark 平均分换算成「单位体积能换到的能力」,结果非常夸张:
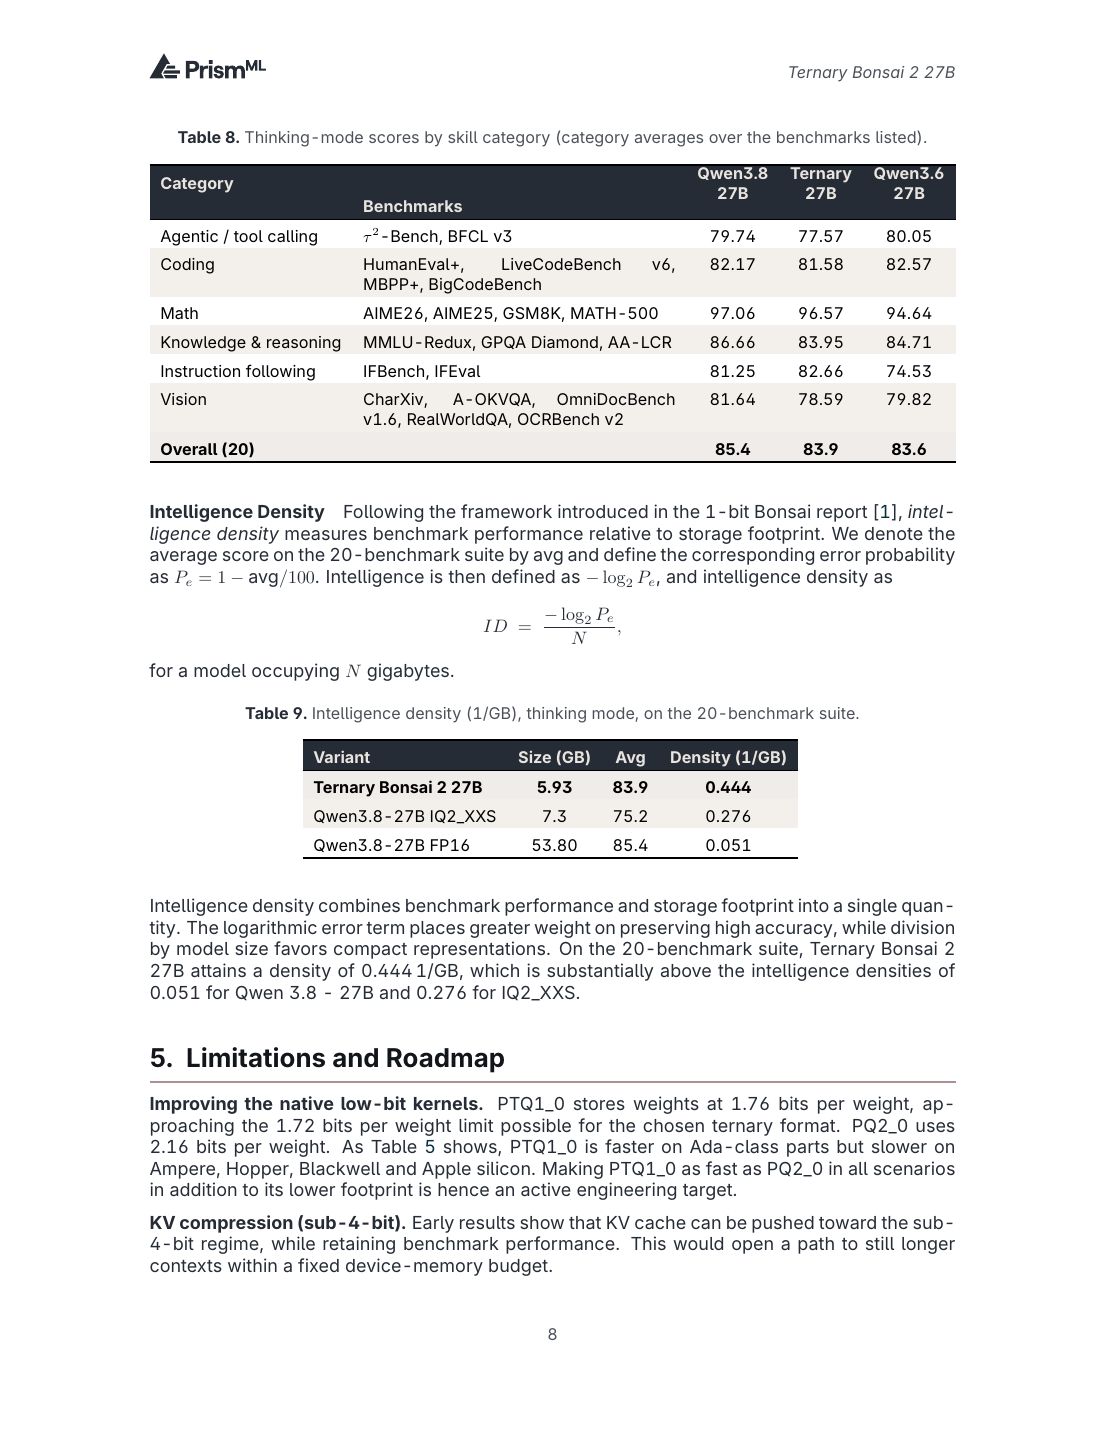
| 模型 | 大小 | 平均分 | 智力密度 (1/GB) |
|---|---|---|---|
| Ternary Bonsai 2 27B | 5.93 GB | 83.9 | 0.444 |
| Qwen3.8-27B IQ2_XXS | 7.3 GB | 75.2 | 0.276 |
| Qwen3.8-27B FP16 | 53.80 GB | 85.4 | 0.051 |
相对 FP16 提了 8.7×,相对 IQ2_XXS 提了 1.6×。
再看上一代 Bonsai 系列与同尺寸 Qwen3 的尺寸—能力曲线:
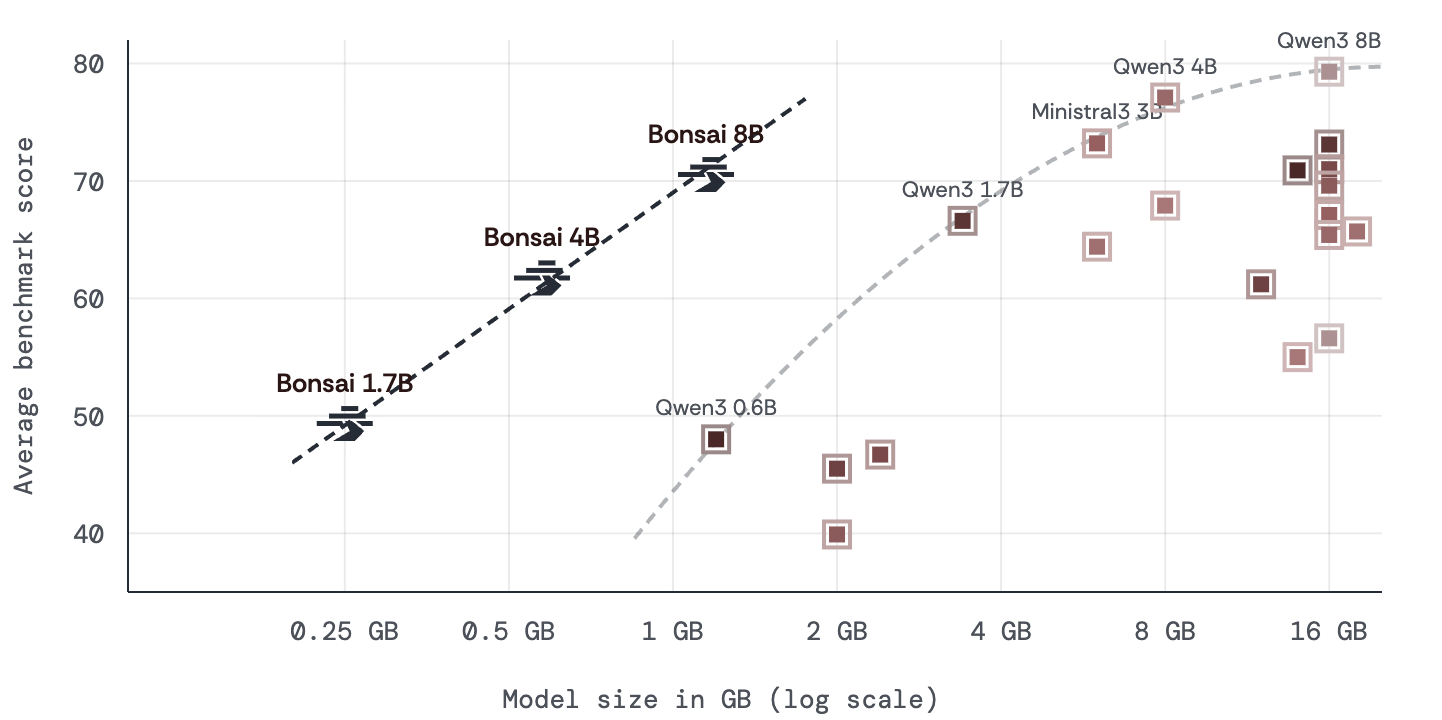
这是去年 Bonsai 1.7B / 4B / 8B 的 frontier 图——同一档体积,Bonsai 始终在 Qwen3 的 Pareto 之上。到了 Bonsai 2 27B,同一条曲线继续延伸:体积压到 ~6 GB,能力追到 27B 满血 FP16 的 98.2%。
🛠️ ▍两条部署路径
官方在 README 一开始就给出了对账表:路径 A 适合「想要 Web UI、本地对话、开箱即用」,路径 B 适合「写 Python 脚本、做产品集成」。
| 维度 | 路径 A:llama.cpp fork + Metal | 路径 B:MLX Python |
|---|---|---|
| 适合谁 | 想要 Web UI、本地对话、开箱即用 | 写 Python 脚本、做产品集成 |
| 磁盘 | 7.21 GB(PQ2_0)+ 0.93 GB(vision)≈ 8.18 GB | 8.49 GB(含 vision tower) |
| M5 Max 速度 | 46.8 tok/s | 略慢(官方未单独测) |
| 难度 | ⭐️ 一行 ./setup.sh |
⭐️⭐️ 需装 mlx-vlm + runtime |
✅ 路径 A:llama.cpp fork + Metal(最省心,官方 demo)
Bonsai-demo 是 source of truth,所有命令都验证过。
1) 系统要求
- macOS 13+(Apple Silicon,M1/M2/M3/M4/M5 都行)
- Xcode Command Line Tools(编译用):
xcode-select --install - Python 3.10+(hf CLI 用)
- 内存:M5 Max / 36 GB+ → 全速 46.8 tok/s;M5 Pro / 24 GB+ → 27.7 tok/s;16 GB 机型会 swap,官方没列性能数据
2) 三条命令搞定
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
./setup.sh
setup.sh 会自动:
- 拉 PrismML 的 llama.cpp fork 预编译包(Metal 后端,含 PTQ1_0 / PQ2_0 内核)
- 下载 PQ2_0 权重(约 7.21 GB)+ mmproj(约 0.93 GB)
- 可选装 Open WebUI(聊天界面)
想跳过 Open WebUI 省时间和空间:
BONSAI_OPENWEBUI=0 BONSAI_CODE_INTERPRETER=0 ./setup.sh
3) 启动服务
./scripts/start_llama_server.sh
浏览器开 http://localhost:8080 → 直接对话,支持图片上传(vision tower 已在权重里)。
4) 只跑一行问题(不启服务)
./scripts/run_llama.sh -p "法国的首都是哪里?"
5) ⚠️ 关键陷阱
千万别 pip install llama-cpp-python 然后跑这个模型!
- stock llama.cpp 不识别 PTQ1_0 / PQ2_0 这两个格式。
- 更阴险的是,它会 假装能加载成 Q2_0,然后吐 garbage,但没有任何报错——你要么看不出问题,要么看出来了要花很久定位。
- 必须用 PrismML 的 fork(
PrismML-Eng/llama.cpp),./setup.sh已经自动把它放在bin/mac/llama-server。
🐍 路径 B:MLX Python(适合开发者)
适合要写代码集成、调用 API、做工具的人。
1) 安装
pip install -U huggingface_hub mlx-vlm
2) 下载 MLX 版(注意:和 GGUF 版是不同文件!)
hf download prism-ml/Ternary-Bonsai-2-27B-mlx-2bit --local-dir bonsai2-27b-mlx
下载内容:
model.safetensors约 8.49 GB(包含 vision tower)runtime/文件夹(带 Hadamard 激活变换的 loader)
3) 安装 runtime 依赖
pip install -r bonsai2-27b-mlx/runtime/requirements.txt
4) Python 调用
import sys
sys.path.insert(0, "bonsai2-27b-mlx/runtime")

from vision_artifact import load_vl_model, chat_config
from mlx_vlm import generate
from mlx_vlm.prompt_utils import apply_chat_template

model, processor, config = load_vl_model("bonsai2-27b-mlx")

# 纯文本
prompt = apply_chat_template(processor, chat_config(config),
                            "用一句话解释量子计算", num_images=0)
print(generate(model, processor, prompt, [], max_tokens=256, temperature=1.0))

# 带图片
prompt = apply_chat_template(processor, chat_config(config),
                            "这张图里有什么?", num_images=1)
print(generate(model, processor, prompt, ["photo.jpg"], max_tokens=256, temperature=1.0))
5) ⚠️ MLX 路径的三个坑
- 不能用普通 mlx-vlm loader,必须用
runtime/vision_artifact.py。普通 loader 会默默跳过 Hadamard 激活变换,输出错误结果但 不报错。 chat_config(config)不能省——mlx-vlm 的 prompt helper 要靠model_type找 chat template。- MLX 版语言模型是 2.25 bpw(容器多存了一个 bias),不是 1.76;内容跟 GGUF 等价,只是存储格式不同。
🧪 ▍验证装好了
任何一条跑通就算成功:
# 路径 A:单次问答
./scripts/run_llama.sh -p "1+1=?"

# 路径 A:服务在跑
curl -s http://localhost:8080/health

# 路径 B:MLX 加载
python -c "from vision_artifact import load_vl_model; m,p,_=load_vl_model('bonsai2-27b-mlx'); print('OK')"
💡 ▍选哪条?
- 就想聊天 / 体验:路径 A,
./setup.sh+./scripts/start_llama_server.sh,开http://localhost:8080。 - 要做应用 / 接 agent:路径 B,MLX + Python。
- 16 GB 内存 MacBook Air:勉强能跑但会 swap,建议等量化更激进的 Bonsai-8B 或 Bonsai-1.7B(也都有 MLX 版)。
🗂️ ▍本地部署位置
按 AI-Models/RULES.md 的决策表,Bonsai 2 27B 的 GGUF 与 MLX 都被放进 Language-Models/ 下;但因为它需要自己 fork 的 llama.cpp 二进制(PTQ1_0 / PQ2_0 内核),整个生态位类似 LongCat-Video-mlx / ComfyUI 那样的 应用 + 权重自包含 单元——所以最终落在:
<BigDisk>:/AI-Models/Language-Models/Bonsai-demo/
├── bin/mac/                              PrismML 的 llama.cpp fork 预编译包
│   └── llama-server, llama-cli, ...
├── models/
│   ├── bonsai2-gguf/27B/                 PQ2_0 GGUF(路径 A 默认)+ mmproj-Q8_0
│   └── Ternary-Bonsai-2-27B-mlx-2bit/    MLX 包(路径 B)
├── scripts/                              start_llama_server.sh / run_llama.sh / start_mlx_server.sh ...
├── .venv/                                Python 依赖(含 mlx-vlm)
└── bonsai-2-27b-whitepaper.pdf           白皮书原件
落到 Bonsai-demo/ 内的两个原因是:(a) demo 的 start_llama_server.sh 用相对路径找模型,把权重外置需要再加一层 BONSAI_GGUF 覆盖;(b) PTQ1_0 / PQ2_0 内核是 PrismML 专有,单独抽到 Language-Models/GGUF/ 会丢掉与 fork 二进制的绑定,反而更难维护。
⚠️ 本机部署状态:本次撰写时未完成实测下权重——
models/bonsai2-gguf/27B/只有一份孤立的 mmproj(部分下载遗留),没有 PQ2_0 主权重。如果你打算跟着这篇文章跑一遍,直接unset all_proxy && ./setup.sh一次性拉完最稳(默认会同时下 GGUF + MLX)。如果只想跑路径 B 且不要 GGUF,加BONSAI_SKIP_GGUF=1即可。
🔭 ▍下一步:在 LocalBrain 里把它跑通
这篇只整理官方文档、回答「能不能装、装哪里、怎么装」的问题。真正的实测我放在 方寸智匣 LocalBrain 的下一轮接入计划里,按以下顺序推进:
- 把 Bonsai 2 27B 的 GGUF + mmproj 通过 LocalBrain 的引用挂载接进来,跑 LocalBrain 内置 llama.cpp b10705 之外的 PrismML fork——这是它能否在 LocalBrain 多模型路由里被选中的硬门槛。
- 在三档机型档位(M5 Max 全速 / M5 Pro 24GB 顺跑 / M4 Pro 24GB 长上下文压力)上跑 6–8 题真实任务——含长上下文写作、Agent tool calling、视觉问答——对比 Bonsai 2 27B、Bonsai 27B Q1_0、Qwen3.8-27B IQ2_XXS、Ternary Bonsai 27B Q2_g64 四档在 LocalBrain 里的速度、内存与首 token 延迟。
- 把实验数据补成一份「LocalBrain 本地模型」系列测评,沿用上次 11 模型 51 GB 那套口径(Blog slug
localbrain-small-models-lowmem)。
如果你最近也想跑、有自己的实测数字,欢迎丢过来,我写进下一篇里一起出。
📎 ▍主要查证来源
- Bonsai-demo 官方仓库
- Ternary Bonsai 2 27B 白皮书 PDF(本地路径)
- prism-ml/Ternary-Bonsai-2-27B-gguf(Hugging Face)
- prism-ml/Ternary-Bonsai-2-27B-mlx-2bit(Hugging Face)
- PrismML-Eng/llama.cpp fork(PTQ1_0 / PQ2_0 内核)
- AI-Models/RULES.md — 目录归属与 HF 下载规范(参考本机 BigDisk 上的 AI-Models 仓库规则,不上公开 CDN)
🧰 我做的工具
这些工具都由我持续维护。预览版会明确标注,下载、更新和已知边界以发行页为准。
信息:黑粉剪辑 HyphenCut 状态: 初步构建 · 预览版
Rust 写的本地专业视频剪辑:达芬奇键位、AI 助理直接改真实工程,免费
信息:黑粉盒子 HyphenBox 状态: 初步构建 · 预览版
免费大模型 API 雷达:持续复测可用性,本地统一接口,Key 只存本机
信息:方寸智匣 LocalBrain 状态: 正式迭代
本地模型的多模态 MCP 工具箱:TTS / Whisper / 视频生成一站接入
信息:ScreenLex 光影词库 状态: 正式迭代
看美剧顺手把生词背了,Mac/Windows 双平台,免费
信息:黑粉录屏 HyphenScreen 状态: 初步构建 · 预览版
录屏 + 智能剪辑一体:达芬奇式时间线、自动打码、导出前成片体检,免费
引用:黑粉科技 让AI成为你的超能力 本地部署 · 免费白嫖 · 自制软件 https://hyphentech.top