摘要 普通人能在自己电脑上运行AI,并不是从天上掉下来的福利。分阶段发布、研究许可、开放引擎与下载链接,把同一场技术竞争分成了两条跑道。 黑粉科技 · 2026-10-05
2019年,GPT-2的完整权重要分阶段等上几个月;2025年,OpenAI又发布了能下载的gpt-oss。同一家公司,开放策略发生了变化。另一边,LLaMA、Mistral和DeepSeek把可下载模型带进了普通用户的工作流。 可下载、能商用、能复现、你这台电脑能跑,是四件事。沿着这场赛跑看完,你下次面对下载按钮,就不会把四件事一起默认勾上。
起跑线上,论文和权重打开了门
2017年6月,八位研究者公开了Transformer论文;2018年,Google又公开BERT的代码和预训练权重。论文让人研究架构,代码让实现更容易检查,权重让人直接使用训练结果。它们降低了不同的门槛,却都不能单独保证把整套训练复现出来。
可以把这几份材料放到做菜的场景里分开:架构像设备的结构设计,代码像操作与控制程序,权重像设备已经调好的设置,训练资料则是当初调试时用过的材料。带回一台调好的设备,可能就能开始使用;要重做它的调试过程,却还得知道材料怎样准备、程序怎样运行。接下来那些“开放”的里程碑,重要的正是每次究竟交出了哪几份东西。
在这些有影响力的研究中,论文、代码与权重的公开让后人能继续往前走:发论文、放代码,大家站在同一套成果上接着往前走。
分岔发生在两年之后。
2019:一个“太危险”的模型
2019 年 2 月 14 日,OpenAI 发布了 GPT-2,一个 15 亿参数的语言模型——放在当时,这个规模大得惊人。可他们只放出了一个小得多的版本,理由写在公告里:担心这项技术被恶意使用。
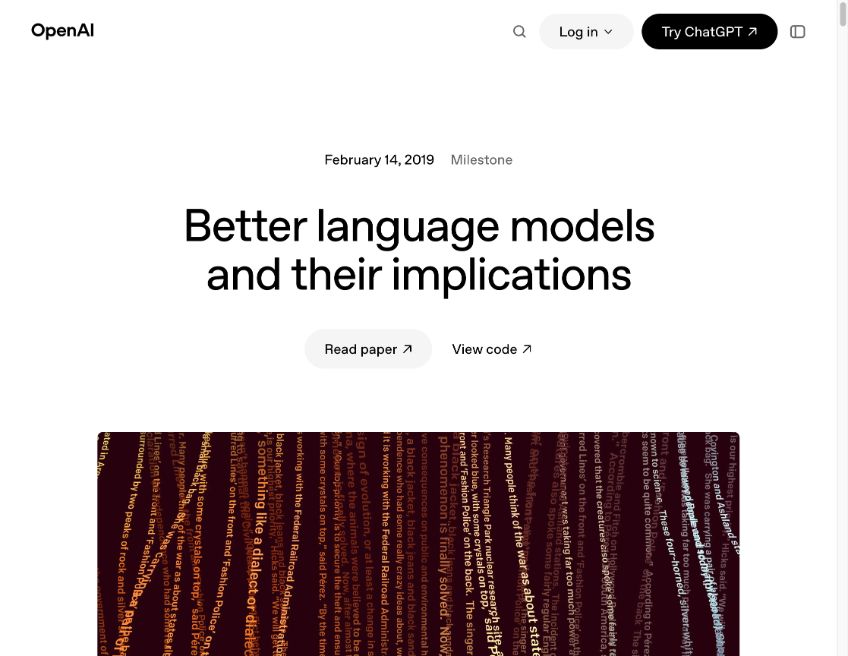
接下来的九个月,OpenAI 像挤牙膏一样一点一点地放:2 月放出 1.24 亿参数的版本,5 月 3.55 亿,8 月 7.74 亿,直到 11 月 5 日,完整的 15 亿参数版才终于公开。顺带一个真实的小插曲:最早公布的两个参数量后来被他们自己更正了——原来写的是 1.17 亿和 3.45 亿,GitHub 上的说明写着,因为“一个错误”算错了。
这次“分阶段发布”在当时吵得很凶。支持的人说谨慎总没错;也有不少研究者批评,把一个 15 亿参数的模型说得这么危险,更像是在渲染恐慌。可它留下的先例,比这场争论本身重要得多:最强的模型,不一定会放出来。
2022 年 11 月,ChatGPT 上线。它背后的模型,一个参数都没有公开。
2023 年 3 月:一份权重从 4chan 漏了出来
2023 年 2 月 24 日,Meta 发布了 LLaMA,最大的一个有 650 亿参数。权重不对外公开下载,研究者得逐个申请,许可证写明只能用于研究。
初代LLaMA采取研究申请和受限许可的发布方式,后来出现了未经授权的权重流传。这段经历让“可以拿到文件”和“有权使用文件”的差别变得具体。这里不提供泄露下载入口。可接下来发生的事,比泄露本身重要得多:短短几周之内,保加利亚程序员格奥尔基·格尔加诺夫(Georgi Gerganov)写出了 llama.cpp,让 LLaMA 能在一台普通的 MacBook 上跑起来。今天大家电脑上跑 GGUF 文件的那套引擎,就是从那个月长出来的。
2023年7月18日,Meta发布了Llama 2,提供包括商业使用在内的许可。一个重要条件是:按许可证规定,在相关发布日期的前一个月,许可方所指产品或服务的月活超过7亿的被许可方,需要另行向Meta申请许可;是否授权由Meta决定。这是明确的使用条件,不是“文件能下载,谁都能随便用”。后续开放发生在泄露之后,但仅凭时间先后,不能认定它就是因泄露而作出的决定。
2023 年 9 月:一条只有一个链接的推文
2023 年 9 月 27 日,一家成立才几个月的法国公司 Mistral AI 在社交平台上发了一条推文。没有介绍,没有配图,只有一个磁力链接。点开,是一个 13.4GB 的种子,里面装着他们的第一个模型 Mistral 7B。许可证是 Apache 2.0——允许使用、修改和商业用途,同时仍须遵守许可证的通知与相关条款。
12月的Mixtral 8x7B进一步展示了混合专家路线:官方介绍总参数约467亿,每个词元实际使用约129亿。这并不意味着只需下载129亿参数;总权重与激活计算是两笔账。第11期看模型版图,第16期再把它接回硬件预算。
混合专家尤其容易把这几件事绕在一起。每个词元只调用部分专家,说明单步计算可以少于把全部参数都用一遍;但下一词元可能换一组专家,通常仍要能访问整个权重集合。就像轮班时只来一部分员工,不等于企业只需要给当班的人准备工位与资料。
“专家”在这里是网络中的不同计算模块。可以想成一本分门别类的工具手册:办眼前的事只翻相关几章,换个任务可能再翻别的章。路由机制决定这一步选哪些模块,所以激活参数描述这一步用了多少;总参数描述整本手册有多大。这个类比只解释选择与容量,模型里的模块没有人的职业身份,也不保证各自都有能说清的专长。
所以,选本地模型时要同时问“总权重多大”和“每步计算多少”。前者影响存储与内存,后者影响算量;量化、卸载与运行引擎又会改变实际代价。把激活参数当成需要装进电脑的总参数,很容易在下载前就算错账。
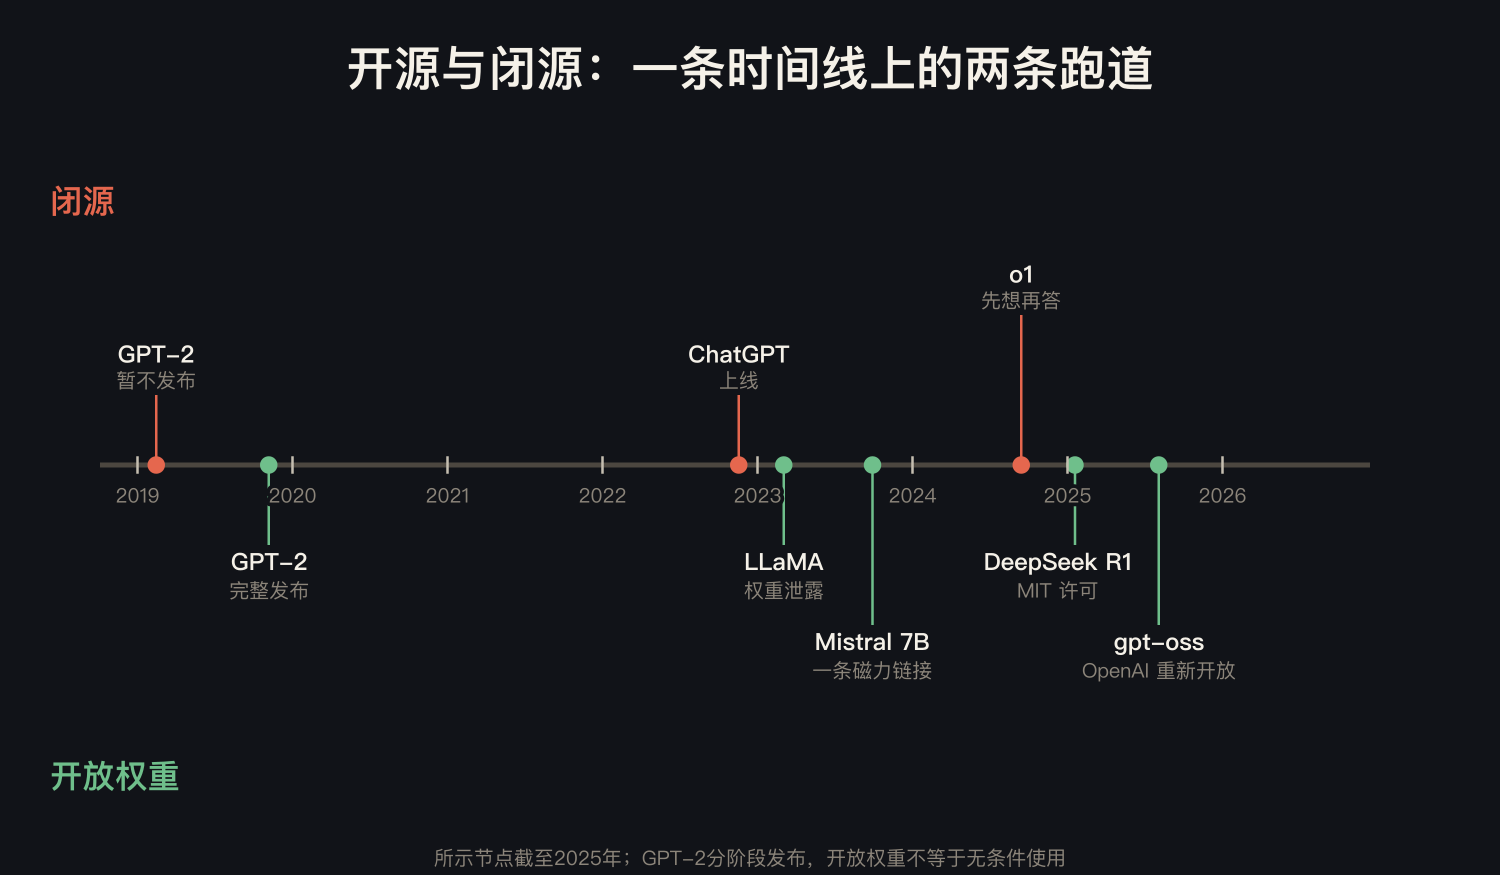
上面是闭源的里程碑,下面是开放权重的里程碑。最有意思的是两头:2019 年 OpenAI 不敢放 GPT-2,六年半以后,它自己又放出了可以下载的模型。
2025 年 1 月:R1把开放推理带到前沿竞争中
2024 年 9 月,OpenAI 发布了 o1,一种先“想”一大段再回答的新模型(第9期专门讲)。它在数学和编程上的跃升,让很多人以为闭源又拉开了一大截。
四个月后,2025 年 1 月 20 日,中国公司 DeepSeek 发布了 R1:同样先想再答,官方报告在若干评测中与o1对照,权重直接用 MIT 许可证放了出来——下载、修改、商用,拿它去教别的模型,全都允许。R1的市场影响留到后面的名场面文章展开。本篇先看它怎样改变了可以下载的模型生态。
又过了半年,2025 年 8 月 5 日,OpenAI 发布了两个可以下载的模型,叫 gpt-oss,许可证是 Apache 2.0。公告里专门写了一句:**这是 OpenAI 自 GPT-2 以来,第一次开放语言模型的权重。**从“太危险,不敢发”到重新开放,中间隔了六年半。
这条时间线也说明,开放与闭源不是两支永不换阵营的队伍。同一家机构可以公开某些模型、把另一些模型保留为在线服务;一个开放模型也可以接入收费产品。“是否收费”和“是否开放权重”不在同一条坐标轴上。
看商业策略可以提出推断:开放可能促进开发者生态,在线服务可能提供便利与收入。但要断言某次发布“真正是为了打击谁”,还需要当时的公告、经营数据或其他证据。模型文件能证明哪些东西放出来了,不能直接证明决策者心里的全部动机。
能拿到模型权重,把“在哪里运行”从服务商的选择变成了用户可以参与的选择。但这份选择仍要付出存储、内存、算力和维护成本。开放不等于硬件免费,宽松许可也不等于免除法律与权限责任。
“开源”到底开了什么?
最后,澄清一个几乎所有人都会搞混的词。
如果还用餐厅类比,权重更像一台已经调好的烹饪设备:内部设置保留了训练后的结果,带回去可以照它的计算方式运行,也可以继续微调。它不是写清每个训练步骤的完整配方。训练代码、数据处理和样本来源,需要另外交代。
这里其实有三样东西:
| 开放了什么 | 相当于 | 你能做什么 |
|---|---|---|
| 权重 | 训练后学得的参数 | 在兼容引擎运行,按许可继续微调 |
| 代码 | 厨房的操作流程 | 知道它怎么训练、怎么跑 |
| 训练数据 | 进货单 | 与代码、配方等一起支持理解和训练复现 |
“开放权重”准确说明你拿到的是训练后的参数,但不要据此猜代码、数据和许可也都齐了。2024年10月,OSI发布《开源AI定义》1.0,对使用自由、代码、参数和足够详细的数据说明提出要求;它不简单等于“把全部原始数据上传”。判断一个具体项目是否符合,需要逐项看材料与条款,不能凭下载量下结论。开源AI定义
| 你要确认什么 | 看什么材料 | 不能用什么代替 |
|---|---|---|
| 能否获取权重 | 发布仓库、文件清单、访问条件 | 宣传中一句“开源” |
| 是否允许你的用途 | 许可证全文及附加条款 | 免费或有下载按钮 |
| 能否复现训练 | 代码、数据说明、配方与实验条件 | 有推理程序即可 |
| 本机是否能跑 | 架构支持、文件格式与内存预算 | 在线演示速度很快 |
假设你下载到一个文件,模型管理软件也把它列出来了。下一步不是宣布部署完成,而是检查引擎是否认识架构、量化文件是否兼容、权重与缓存能否放进内存。文件识别是入口,启动是下一道门;能启动之后,还要用自己的任务验收。
文件格式与运行引擎,可以借播放器和视频文件理解:看到文件名,不代表播放器会解码;解码成功,也不代表设备能流畅播放。模型格式是参数怎样装进文件,引擎是怎样读它、计算它的程序,内存则提供运行时要用的空间。下载页上的三个“可以”——可以拿到、可以使用、可以在本机跑——因此必须分别打勾。
这不是给开放模型泼冷水,恰恰是把它的价值用起来:你可以检查版本、换运行地点、调整预算、保存结果,不必只信服务商的一次演示。自主权增加了,自己要承担的检查也增加了。
去看一眼“能下载”长什么样
- 打开 Hugging Face(huggingface.co),搜索
Qwen3-8B,进入官方页面 - 找到
license那一栏,看它写的是什么(以该模型当时页面的许可字段为准) - 点开“Files”,数一数有多少个
.safetensors文件,加起来有多大 - 再搜一个闭源模型的名字,例如GPT-4的官方模型资料——你会发现,找不到任何可以下载的文件
下载页是检查开放程度的入口,不是检查终点。先找到模型卡、许可文件、架构配置和权重清单,再去看你准备使用的运行引擎。少一环,结论就应停在那一环。
最后再看“开源追上闭源,只差几个月”这种句子。它可能指某个开放模型终于达到了旧闭源模型曾有的分数,也可能指同一天两个模型之间的分差。这两个问题不能用同一个数字回答:时间差需要明确历史基准,分差需要明确当前版本、任务、推理预算与工具配置。
不同尺子还可能给出不同顺序:数学推理强,不保证中文写作、长文检索和工具调用同样领先。本篇的时间线说明开放路径怎样变化,不把跨年代模型连成一条未经统一测试的能力榜。等到成绩单那几期,我们再专门拆这把尺子。
回到开头的问题
回到最初的问题:开放改变的是谁有机会拿到模型、检查模型、改造模型和选择部署地点。它没有自动消除训练复现、运行兼容与任务可靠性的困难。与其争论一个宽泛的“开源更强”或“闭源更强”,不如把能力证据、使用权利和部署成本分开读。
故事里出现的几个名词
| 术语 | 人话 |
|---|---|
| 闭源模型 | 只能通过网页或接口使用,权重不公开 |
| 开放权重 open weights | 公开训练好的权重,实际用途与运行受许可和兼容条件约束 |
| 开源 AI(OSI 定义) | 代码和权重都开放,训练数据描述到可复现的程度 |
| 许可证 | 规定你能拿模型做什么:能否商用、要不要署名 |
| 分阶段发布 | 先放小版本,观察一段时间再放大版本 |
| 磁力链接 | 一种种子下载地址;Mistral 用它发布过模型 |
| MoE 混合专家 | 参数很多、每次只动用其中一部分的结构 |
| Apache 2.0 / MIT | 两种最宽松的许可证:基本允许广泛使用与商用,但仍需遵守具体条款 |
下一篇接着看:给机器四组数字,不告诉它规律,它却能把两个旋钮拧向答案。再看神经元熔炉里的曲线:损失下降、界面能跑、真的学会,究竟差在哪里?
参考资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
把 Mac 变成私有 AI 盒子:本地转写、配音、生图、视频和 MCP 工具一站管理。
本轮公开 Apple Silicon Mac 安装包。聊天模型现在可通过同一代理按需调用已集成的语音、转写、图像、图片编辑、音乐和视频工具,并把实际产物交给下一项工具继续处理。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
在 AI 面板打开「制作动画」,输入讲解及自己的要求,从三组19种风格方法中选择。模型结合当前内容设计主体、动作与镜头,生成可编辑的原生动画图层和关键帧。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取
留言
正在加载留言…