摘要 一站一站传话,和随时查找前文,是两种不同的组织方式。2017年的论文改变了语言模型,但它没有送给机器一份永不遗忘的记忆。 黑粉科技 · 2026-10-05
同样三条要求,放进短文很显眼,埋进长文就可能被漏掉。模型卡写128K,究竟保证了什么?先看2017年那篇论文怎样改变信息的组织方式,再看为什么“有机会看到”仍不等于“能可靠使用”。
第6期把每个词变成了可以比较和计算的表示。可一句话里的词不是各管各的:“它”指的是谁,得看前后文。怎么让每个词都“看得见”别的词? Transformer及其改进是许多主流语言模型的重要基础,但也存在循环、状态空间与混合架构,不能说所有大模型无一例外。2017年的论文为我们提供了理解注意力的一条清楚入口。 这一篇把它拆开。它把前面那些零件真正连了起来,读完你会真正明白“注意力”是什么,以及为什么它能让模型规模爆炸式增长。会有一段二十行的代码,能跑,能看懂。
先看它取代了什么
2017 年之前,处理语言的主流是循环神经网络(RNN)及其改进版 LSTM。
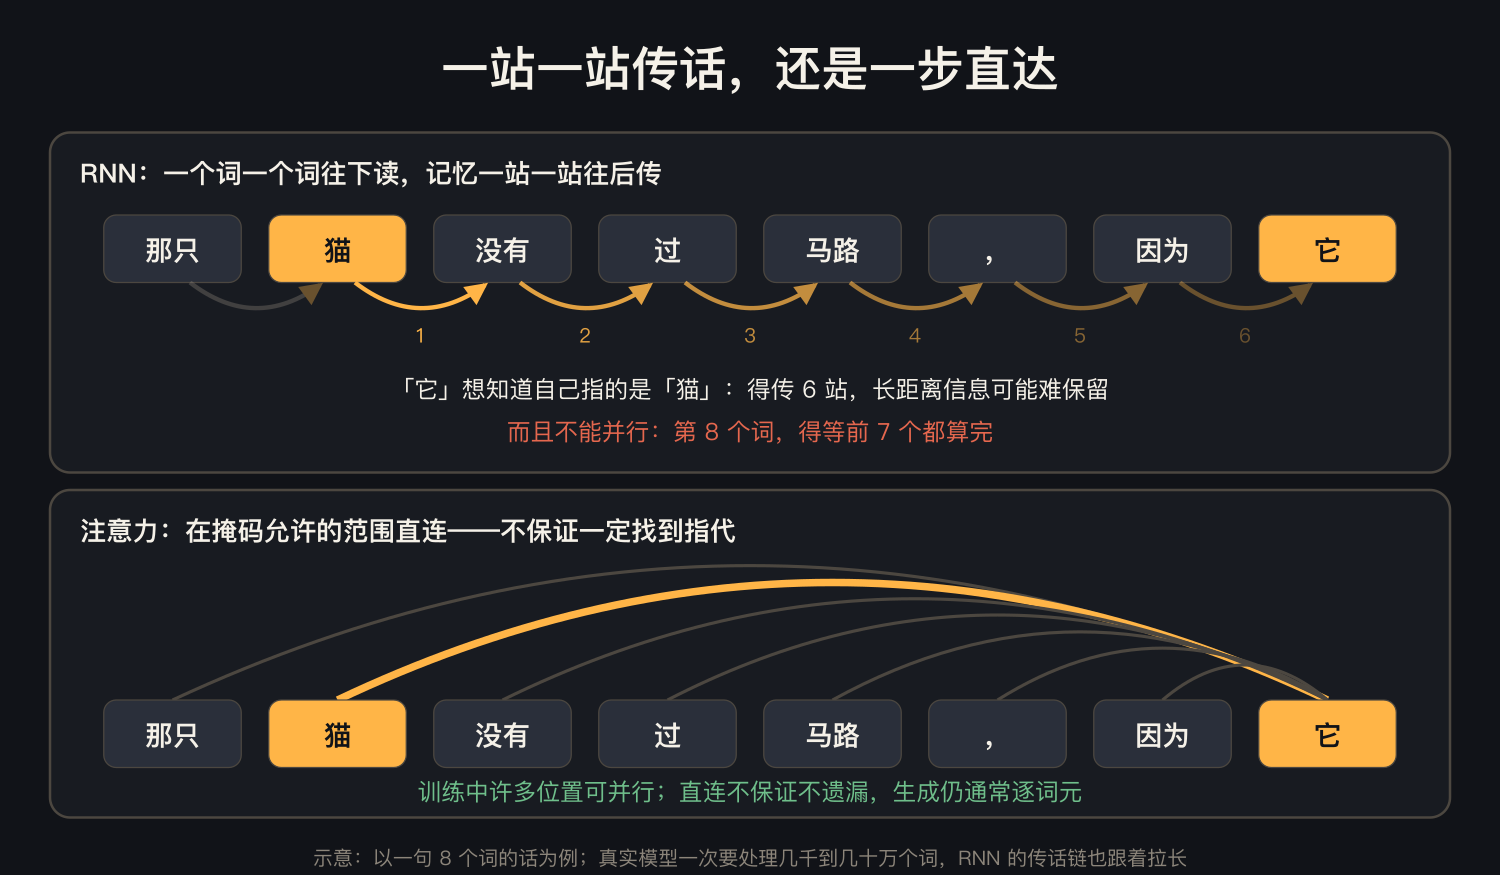
它的工作方式很符合直觉:像人读书一样,一个词一个词往下读,同时维护一个“记忆状态”,每读一个词就更新一次记忆。
沿序列传递状态,有两个需要处理的困难:
一、序列内的顺序依赖。 要算第 100 个词,必须先算完前 99 个——因为记忆状态是逐步传下来的。这意味着无论你买多少张显卡,序列方向上的计算受递归依赖约束;批次和部分内部计算仍可并行。这个瓶颈很重要,但不等于循环架构永远没有使用价值。
二、长距离遗忘。 信息要一站一站传递,传得越远衰减越厉害。一个出现在段落开头的关键人名,到段尾时早就模糊了。LSTM 用精巧的门控机制缓解了这个问题,但没能根治。
那篇论文的标题就是它的主张
2017 年,八位研究者发表了《Attention Is All You Need》——注意力就是你需要的全部。
标题里的挑衅意味很明确:此前注意力机制只是 RNN 的一个辅助组件;他们说,把 RNN 整个扔掉,只留注意力,效果更好。
结果确实如此。新架构他们命名为 Transformer。
注意力:一次全场查字典
理解自注意力最好的类比是查字典,或者说一次全场提问。
句子里的每个词,都会生成三样东西(都是向量,由三套可训练的权重矩阵从词向量算出来):
| 名字 | 全称 | 人话 |
|---|---|---|
| Q | Query,查询 | 我现在想找什么信息?(我的提问单) |
| K | Key,键 | 我这里有什么信息可供查找?(我的标签) |
| V | Value,值 | 我实际能提供的内容 |
然后发生这样一件事:
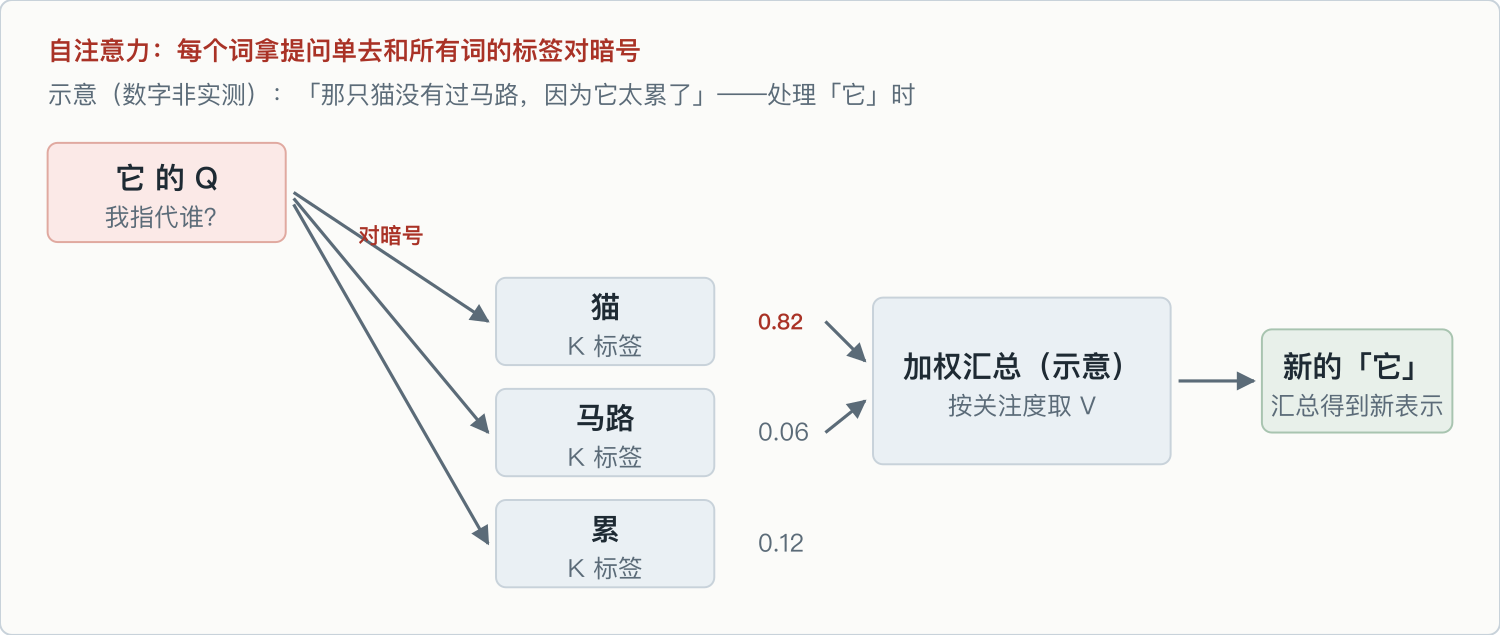
每个词拿着自己的提问单 Q,去和句子里所有词的标签 K 逐一比对,算出“跟谁最相关”,然后按相关程度把大家的内容 V 加权汇总起来。
举个例子。句子是“那只猫没有过马路,因为它太累了”。当模型处理“它”这个词时,“它”的提问单大致在问“我指代的是谁?”——这张提问单和“猫”的标签高度匹配,和“马路”的标签匹配度低。这个例子说明相关信息可以怎样被汇总,不是读取某个真实模型注意力得到的结果;实际关注分布需要检查具体层、头、位置与输入。
加权汇总提供了一种关联远处信息的计算方式;真实指代判断仍依赖多层表示、训练与上下文,不是单次加权就保证正确。
把“关注”落到一次小计算。假设当前位置对三个候选位置的分数是2、1、0,softmax会得到大约0.665、0.245、0.090。注意看:这些数加起来为1,最高分得到更多权重,但另两个位置并没有完全消失。
把这一步想成把一壶水分给几个杯子:候选分数先说明谁该分得多,softmax再把它们转成合计为一整壶的份额。它不是直接按原分数同比例分水,具体转换规则决定差距会有多明显。加权汇总则按各杯的份额取用对应内容。这个场景解释“归一化”和“加权”,不把分到更多水的位置说成更真实;所以下面还要把权重乘到V上,看最后到底汇总出了什么。
如果三个位置的V分别是10、20、30,这一维的汇总值约为10×0.665+20×0.245+30×0.090=14.25。这里用了手工单维值讲机制,不是某个模型的真实注意力记录。Q与K负责怎样匹配,V提供被汇总的内容;这就是为什么公式最后乘的是V。
| 容易误读的词 | 这次计算实际在做什么 |
|---|---|
| “提问” | 学得的Q与K参与点积,不是机器读到了一张中文问题单 |
| “关注度66.5%” | 本次加权比例,不是结论有66.5%概率为真 |
| “猫受到关注” | 某层某头的信息关联,不等于完整指代判断已被解释 |
这个过程能把远处的信息带到当前表示里,但后面还有多层计算。如果取到的资料是错的,汇总不会把它变成事实;如果任务需要精确计数,一次关联也不等于执行了一段计数程序。理解机制的价值,是知道它多提供了哪种操作,而不是给它贴上什么都能做的标签。
关键在于:这个比对是所有词对所有词同时进行的。第 1 个词和第 1000 个词之间是一步直达,不需要经过中间 998 站。它缩短了信息交互路径,并提高训练和预填阶段的并行机会;但生成词元通常仍有逐步依赖,长距离信息也可能被遗漏,并没有从此消除遗忘。
公式,逐项翻译
论文里的核心公式长这样:
Attention(Q, K, V) = softmax( Q·Kᵀ / √d_k ) · V
拆开看,每一步都是上面那段话的直译:
| 片段 | 在做什么 |
|---|---|
Q·Kᵀ |
每个词的提问单,和每个词的标签,两两求相似度 → 得到一张“谁跟谁相关”的分数表 |
/ √d_k |
除以向量维度的平方根,缩放 |
softmax(...) |
把分数表变成总和为 1 的关注度分配(百分比) |
· V |
按这个百分比,把所有词的内容加权汇总 |
缩放项是在处理数值范围:在原论文采用的分析假设下,点积的方差会随维度增长,过大的分数容易让softmax分布过尖,梯度变小。除以维度平方根有助于缓和它。不是任意高维向量必然变大,更不是所有训练故障都能靠这一项修好。
3×3矩阵:亲手算一次注意力
import numpy as np

def softmax(x):
    e = np.exp(x - x.max(axis=-1, keepdims=True)) # 减最大值,防数值溢出
    return e / e.sum(axis=-1, keepdims=True)

# 一句话 3 个词,每个词用 4 维向量表示
X = np.array([
    [1.0, 0.0, 1.0, 0.0], # 词1
    [0.0, 2.0, 0.0, 2.0], # 词2
    [1.0, 1.0, 1.0, 1.0], # 词3
])
d_k = X.shape[1]

# 真实模型里 W_q/W_k/W_v 是训练出来的;这里用单位矩阵简化,专注看机制
W_q = W_k = W_v = np.eye(d_k)
Q, K, V = X @ W_q, X @ W_k, X @ W_v

scores = Q @ K.T / np.sqrt(d_k) # ① 提问单 × 标签 → 相关性分数表
weights = softmax(scores) # ② 转成总和为 1 的关注度分配
output = weights @ V # ③ 按关注度加权汇总所有内容

print("关注度矩阵(每行总和为1):\n", weights.round(3))
print("\n每个词的新表示:\n", output.round(3))
跑一下,你会看到一个 3×3 的关注度矩阵。第 i 行第 j 列的数字,就是“第 i 个词有多少注意力分给了第 j 个词”,每行加起来正好是 1。
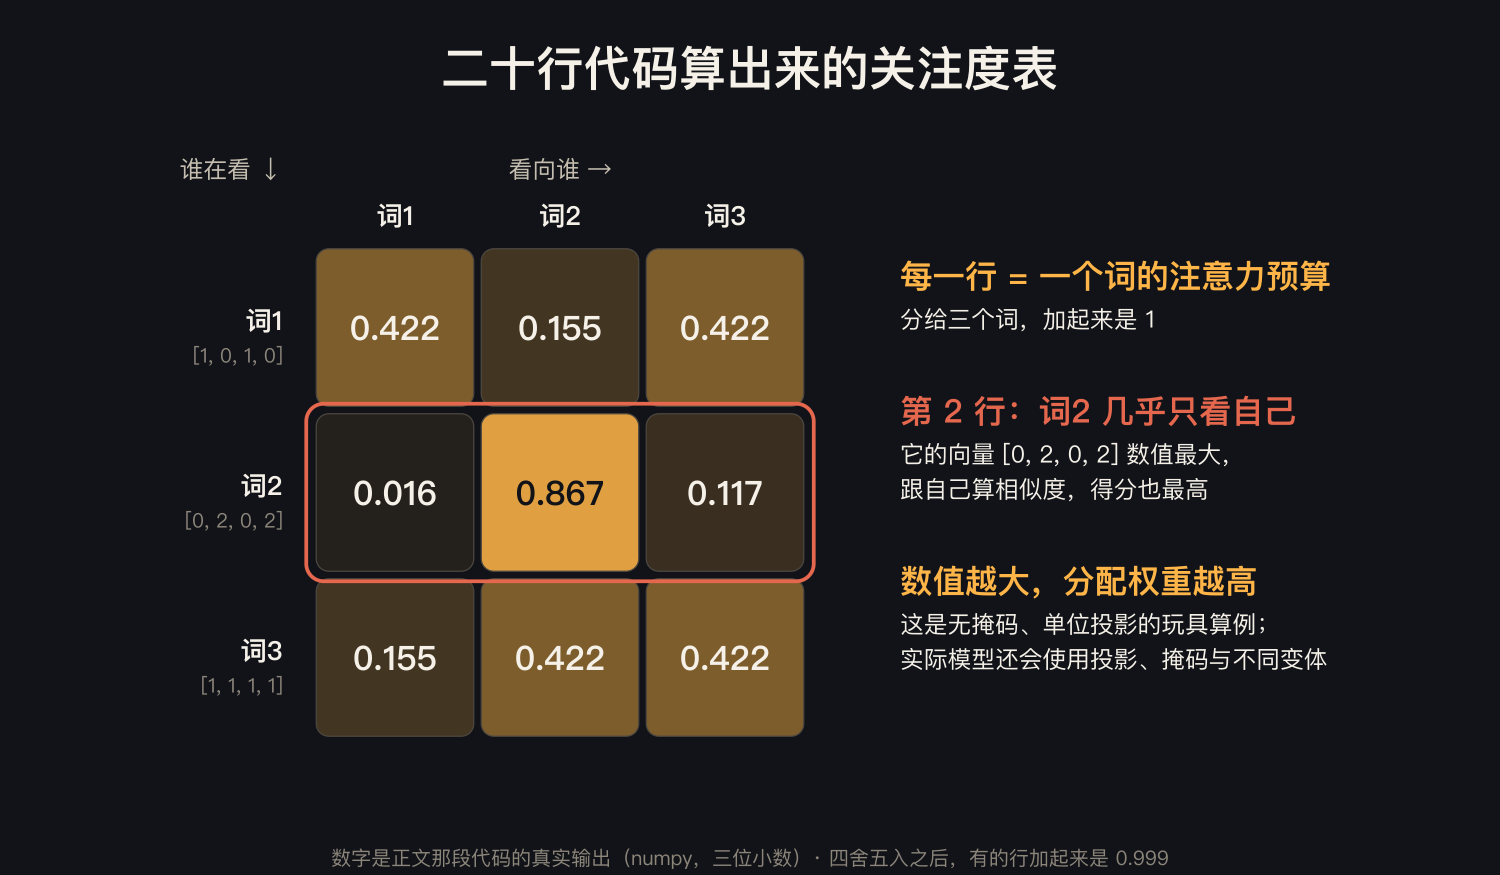
这段代码展示注意力模块的一次计算,不是一个完整Transformer。真实模型还要学习投影矩阵,并组合前馈网络、残差、归一化、位置表示与训练目标。这里没有因果掩码,因此不能直接当作GPT逐步生成的完整程序。
这里还有个门禁规则叫因果掩码:像做填空时盖住后面的标准答案,只允许使用前面已经给出的内容。训练虽能把多个位置的运算安排在一起,各位置仍不能偷看自己不该使用的后文。位置表示则像给材料加页码或顺序标记,让相近的内容不仅可比较,还保留先后关系。它们控制的是能用哪些信息、怎样辨认位置,不是让模型自动知道事实真假。
注意力为什么还需要这些搭档?
信息可以彼此关联之后,还要从不同角度组织关系、知道位置、稳定传递,并进一步加工。原论文把这些部件组合成可训练的网络,而不是只留下一个softmax公式。
多头注意力。 对输入进行可学习的投影,再组织成多组头并行计算,最后汇总。不是简单把原始词向量切几段就自动获得各自的专业知识。某些头可能呈现不同关系偏好,但职责由训练影响,不是人为规定一个头管语法、另一个头管事实。
二、位置编码(Positional Encoding)。 这里有个容易被忽略的大问题:注意力机制本身完全不知道词序。 在不加入位置等信息、也不加入因果掩码的纯自注意力中,重排输入会对应重排输出;它不能仅靠这一层区分词在第几位。不是说两个句子的逐位置输出数值一定相同。
而语序显然承载意义。解决办法是:在每个词的向量上,加一个表示“我在第几位”的编码。原论文用的是一组不同频率的正弦余弦波;位置表达可以用于未见长度,但不保证模型在那些长度上表现可靠,后来的模型有各种改进版本。
位置关系要通过架构中的适当机制进入计算。原论文的正弦余弦位置编码,与后来的旋转位置等方案,不是相同操作。容量扩展、位置处理与长文表现有关,但某次遗漏不能不查证就全部归因于位置编码。
三、残差连接与层归一化。 几十层堆起来,信号在传递中很容易失真或爆炸。残差连接的做法是让每一层的输出加上它自己的输入(走一条“捷径”),有助于信息与梯度传播,不保证任何细节都不会丢失;层归一化则把每层数值拉回稳定范围。这两个不起眼的设计,是深层网络能训得动的关键。
前馈网络。 注意力负责跨位置汇总信息,前馈网络继续变换每个位置的表示。它们与残差、归一化等共同构成层;不是注意力取回了资料,最终答案就已经确定。
继续沿着资料传阅的场景看:注意力先把其他位置的相关内容汇到手边,前馈网络再加工当前位置的表示;残差连接像修改稿旁边保留原稿,把原信息与新增修改合起来;归一化像比较几组读数前先调整数值尺度,让后续处理更稳定。每个部件都有自己的作用,组合起来才是一层完整处理。类比帮助分工,真实运算处理的是向量与参数,并没有开会讨论的同事。
从 Transformer 到 GPT
原论文的架构分两半:编码器(Encoder,负责理解输入)和解码器(Decoder,负责生成输出),因为它最初是为机器翻译设计的。
后来两条路分岔了:
- BERT 只用编码器 → 擅长理解类任务(分类、检索)
- GPT 采用解码器式因果语言建模 → 擅长生成;现代聊天系统仍可能采用其他或混合结构
GPT 这条路有个关键设定叫因果掩码(causal mask):生成第 N 个词时,注意力对预测下一个词元的当前位置,只允许关注当前已提供的前缀,不许看到待预测的后续答案,不许偷看后面。原因很朴素——它的训练任务就是预测下一个词,能看到答案就等于作弊。
这个“只能看已提供前缀”的限制,正是 KV cache 能够成立的前提(第22期缓存内容会拿它算一笔显存账):因为在固定模型与相同前缀、兼容位置和缓存设置下,先前位置的K、V不必因追加词元而重新计算,所以才可以算一次存起来反复用。
再把并行与缓存接起来。训练时,已知完整样本文本,可以在因果掩码约束下同时计算许多位置的预测损失;生成时,下一个词元还没有选出来,后面的前缀也就不完整。前者有并行机会,后者仍有顺序依赖。
KV缓存复用的是兼容前缀已算出的键和值。它让后续解码少做重复工作,却仍要处理新词元,并在相应注意力边界内使用前文状态。它既不是模型参数,也不等于跨会话永久记忆。窗口越来越长时,缓存占用与读取代价还会接到硬件那几期。
长上下文评测还要看信息放在哪。2023年的《Lost in the Middle》在特定模型与任务中发现位置影响:重要信息位于中间时,某些模型表现下降。它提供了一个值得复测的变量,不是所有当前模型一律失败的判决。原始研究
三个最容易混淆的“能看见”
| 说法 | 不成立的跳跃 | 可检查的办法 |
|---|---|---|
| 窗口装得下128K | 从容量直接跳到每个位置都可靠 | 把同一事实放在开头、中间、结尾,检查遗漏及条件 |
| 注意力权重高 | 从单层关联跳到最终答案因果解释 | 区分层与头的分布、最终输出和专门因果实验 |
| 训练能并行 | 从训练并行跳到生成无需逐词等待 | 分别测输入预填、首词延迟与后续解码,不混成一个速度 |
带着这件事,试一次
写一段含3条约束的短文,把最关键的一条分别移到开头、中间、结尾。先制定检查表,再决定是否请求模型。运行时记录完整输入、模型版本、回答和遗漏,避免只留下最好的一次。上面的单位矩阵算例用于说明算法,不是在证明某个真实模型把“它”的注意力分给“猫”。
Transformer缩短了信息交互路径,也改善了训练与预填阶段的并行机会。最终能否可靠使用长文,还要看容量、位置、任务、训练与推理配置。QKV帮助信息交互,不给事实盖章;128K提供预算,不保证每个位置都答对。
故事里出现的几个名词
| 术语 | 人话 |
|---|---|
| RNN / LSTM | 循环状态沿序列逐步传递,限制序列维度并行;其他维度仍可并行 |
| 自注意力 self-attention | 句内所有词互相比对、按相关度加权汇总 |
| Q / K / V | 提问单 / 标签 / 内容 |
| softmax | 把一堆分数变成总和为 1 的百分比分配 |
| 缩放 √d_k | 防止点积过大导致 softmax 饱和、梯度消失 |
| 多头注意力 | 并行做多次注意力,各关注不同类型的关系 |
| 位置编码 | 提供相对或绝对位置信息;纯注意力内容比较不自带位置编号 |
| 残差连接 | 输出与输入相加的捷径,有助于信息和梯度传播 |
| 层归一化 | 把每层数值拉回稳定范围 |
| 编码器 / 解码器 | 理解输入 / 生成输出;BERT 用前者,GPT 用后者 |
| 因果掩码 | 生成时只许看前文,不许偷看答案 |
下一篇接着看:补全机能接着列题,助手却会回答、解释或拒绝。把它教得像个助手,和让它每句话都真实,是两项并不相同的工作。
参考资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
把 Mac 变成私有 AI 盒子:本地转写、配音、生图、视频和 MCP 工具一站管理。
本轮公开 Apple Silicon Mac 安装包。聊天模型现在可通过同一代理按需调用已集成的语音、转写、图像、图片编辑、音乐和视频工具,并把实际产物交给下一项工具继续处理。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
在 AI 面板打开「制作动画」,输入讲解及自己的要求,从三组19种风格方法中选择。模型结合当前内容设计主体、动作与镜头,生成可编辑的原生动画图层和关键帧。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取
留言
正在加载留言…