
摘要 零件拆过了,现在把它们装回去。跟着“今天天气真”走进一间只认数字的翻译社,看一句话怎样变成概率,再变成你屏幕上的文字。 黑粉科技 · 2026-10-05
前几篇把零件一个一个拆开讲了:token、向量、注意力、训练、推理。这一篇把它们装回去——跟着你敲下的一句话,从按下回车,一路走到屏幕上蹦出第一个字。 读到这里,“推理”“token”“上下文”这些天天见的词,就从黑话变成了具体的机器动作。
一间只认数字的翻译社
想象一间奇怪的翻译社:里面的专家水平极高,但只认识数字,完全不认识文字。你递进去一句中文,要经过四道工序才能拿到回信:
- 前台把你的话切成小纸条,每张纸条换成一个编号(查一本固定的号码簿)
- 专家团队看着这串编号,反复传阅讨论,每个人在编号旁写下自己的理解
- 讨论完,专家给出“下一个编号最可能是什么”的投票表
- 前台按投票结果抽出一个编号,翻回文字,贴到回信末尾——然后整个过程重来一遍,猜下下个编号
大语言模型生成回答,就是这四步的机器版,而且每次只产出一个词块,循环往复。下面把每一站的正式名字对上。
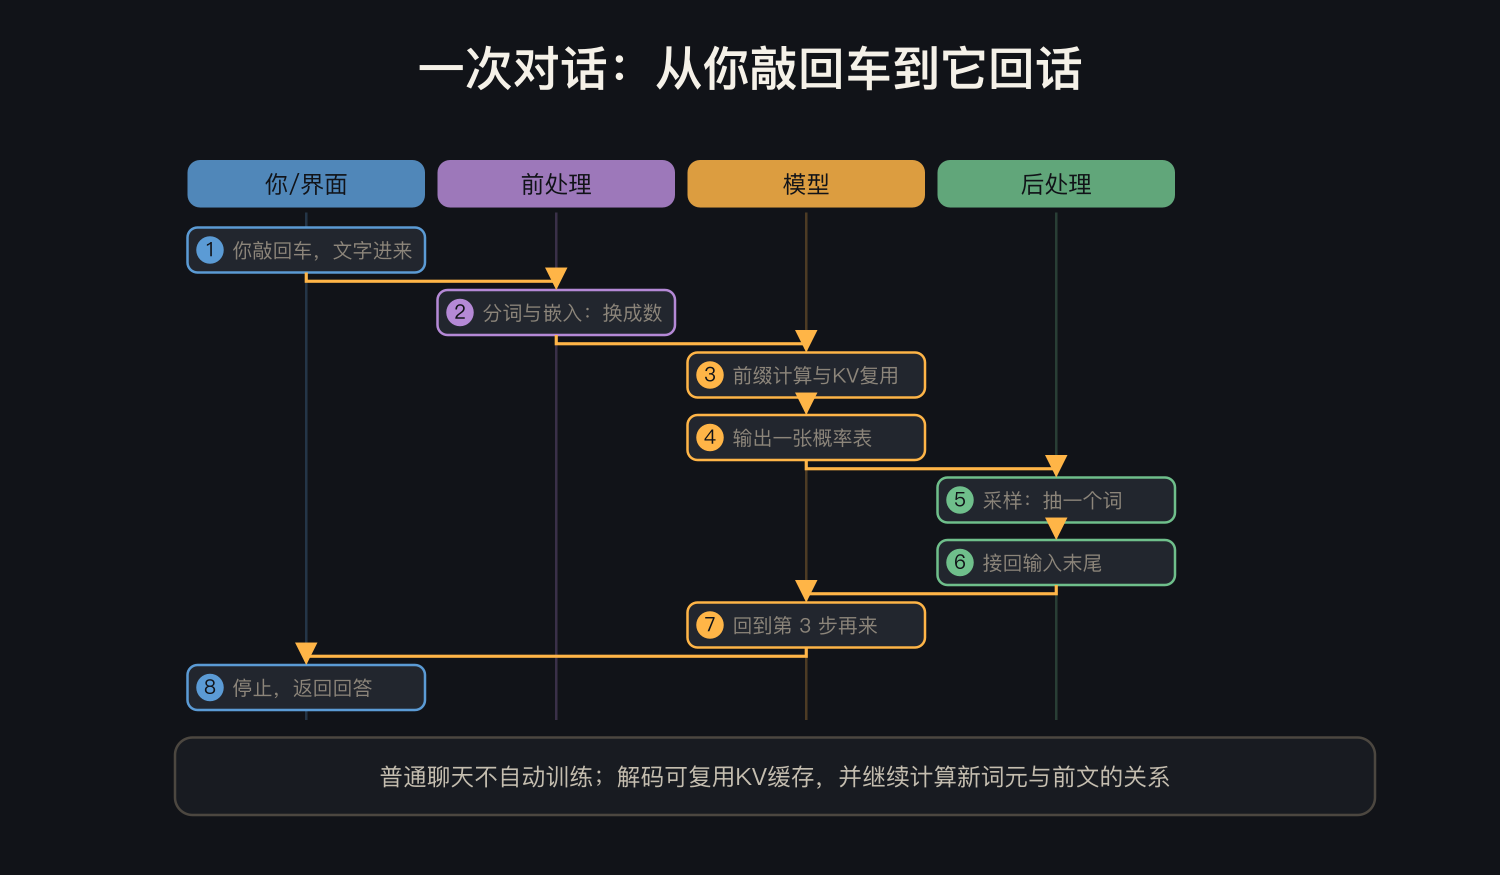
颜色是层,编号是顺序。第 3–7 步是一个循环——每生成下一词元都使用前缀信息;兼容缓存时不必重算前面所有层的K、V。训练不在这条链上。
第一站:分词(Tokenization)——把文字换成编号
模型不认识“汉字”或“单词”,只认识 token(词块)。分词器(tokenizer)拿着一本固定的词表(vocabulary,通常十几万条),把你的输入切碎并换成编号:
- “黑粉科技” 可能被切成
黑粉+科技两个 token,也可能是三个——切法由词表决定,不由语义决定 - 英文里
unbelievable常被切成un+believ+able - 同样意思的文本要用具体模型的分词器计算,没有适用于所有模型的固定汉字换算率
- 一个真实的例子:这篇文章后面用到的那个小模型,把“今天天气真”切成了
今天天气真四块——“今天”是一整块,“天气”反而被拆开了
为什么你要在乎:所有计费、所有“上下文长度 128K”里的 K,单位都是 token,不是字。128K的具体计数与输入输出占用,应看模型和服务说明——这是模型最多能看多远,不是你的电脑一定装得下的长度(第22期会算这笔账)。
第二站:嵌入(Embedding)——给每个编号发一张“性格档案”
编号本身主要起索引作用。第6期里,“狗”和“内阁”的示意编号挨在一起,语义却八竿子打不着。进入嵌入层后,每个编号才映射成一组可学习的数值。所谓“性格档案”只是类比,不是每一维都能直接翻译成一个人类概念。
关键性质:意思相近的词,档案数字也相近。“国王”和“王后”的向量距离很近,“国王”和“拖拉机”离得远。向量表示是计算语言的重要基础,不能把全部理解归结成两点间的距离。
顺带解开一个术语:模型参数里常见的 hidden_size = 5120,说的就是这份档案有 5120 个数字。
第三站:注意力(Attention)——专家团队的传阅讨论
这是 Transformer 架构的心脏,也是“GPT 为什么强”的答案。一句话版本:
生成每个新词之前,全注意力层会按掩码关联允许访问的前文位置;稀疏、滑窗与混合结构有不同边界,给它们分配不同的关注度权重,加权汇总后形成“此刻该说什么”的判断。
翻译社类比里的“传阅讨论”就是这一步。技术上它叫自注意力(self-attention),每个 token 会产生三份材料:
- Q(Query,提问单):我现在想找什么信息?
- K(Key,标签):我这里有什么信息可供查找?
- V(Value,内容):真正的信息本体
在当前前缀位置预测下一词元时,用当前位置的Q 去和前文所有 token 的 K 逐一“对暗号”(算相似度),对上号的 token 的 V 被重点吸收。这个“对暗号”要对所用架构与掩码允许关注的前文位置 做一遍——这就埋下了一个伏笔:前文越长,账越贵(第22期会细算)。
而且这套讨论不止一轮:模型有几十层(layer),每层有多组并行的“讨论小组”(注意力头,attention head),逐层深化理解。num_hidden_layers = 48 就是 48 层专家讨论。
第四站:采样(Sampling)——从投票表里抽签
讨论结束,模型输出的不是“一个词”,而是词表里每个 token 的概率——一张十几万行的投票表。知识库2026年9月11日保存的LFM2.5-2.6B原始输出中,接在“今天天气真”后面,排在前面的是这几个:
| 候选 | 概率 |
|---|---|
| 好 | 89.6% |
| 不错 | 2.5% |
| 好的 | 1.3% |
| 美 | 1.1% |
| …… | …… |
“不错”“好的”各算一个 token:模型挑的是词块,不一定是单个字。
抽签规则就是采样参数(temperature、top_p 这些,第23期专讲)。抽出的 token 贴到句尾,然后——新词元进入后续解码,前文KV可复用,继续模型计算与采样,猜下一个。直到抽中一个特殊 token:<结束>。
所以“AI 打字机式地往外蹦字”不是特效,是它真实的工作方式:一次循环,一个 token。
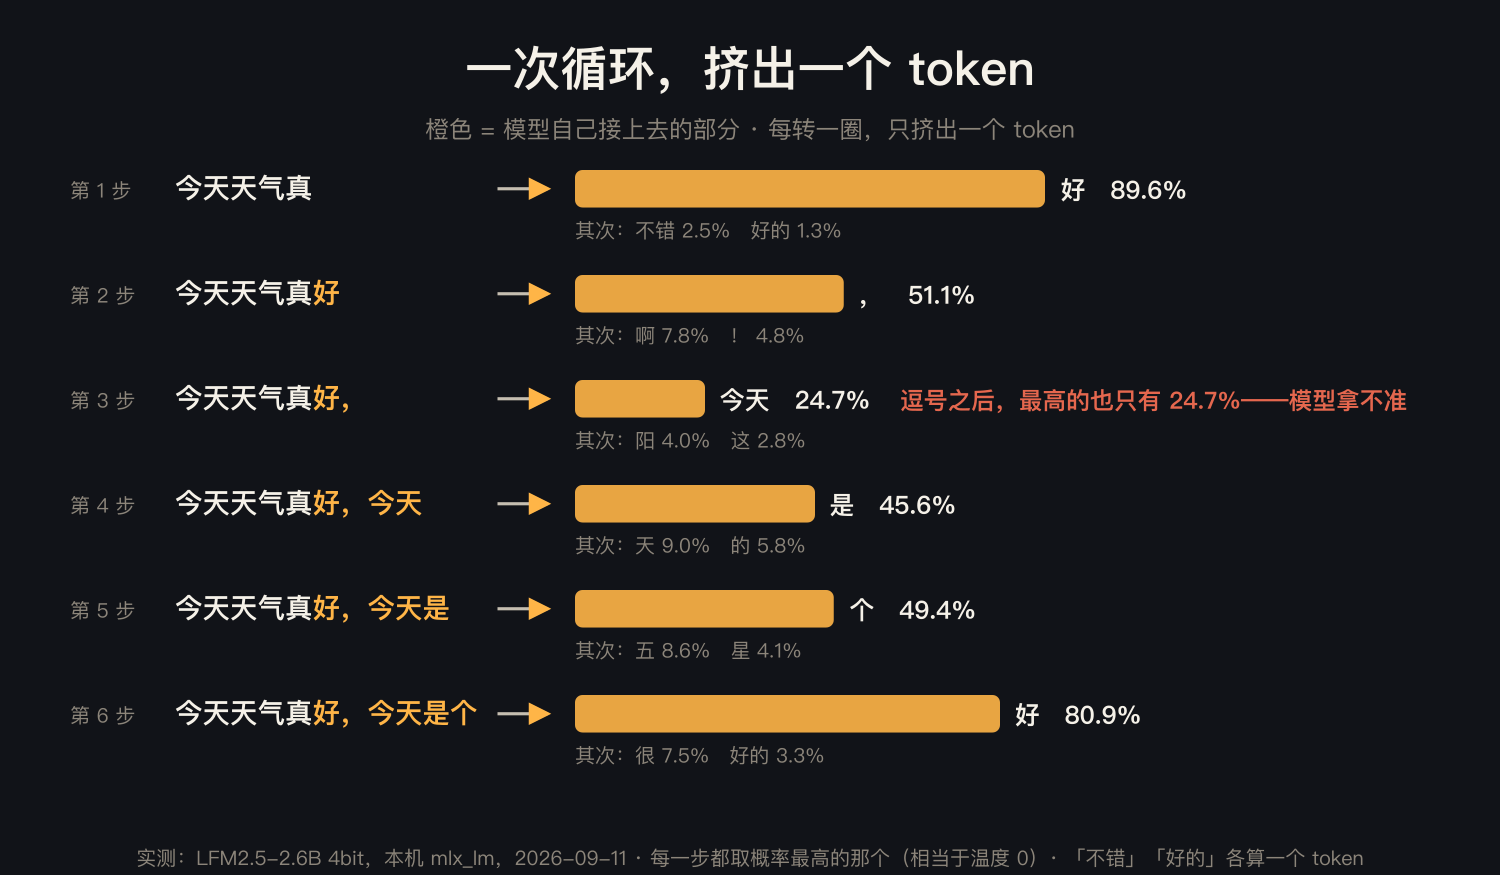
同一个小模型往下接了六步,每一步都取概率最高的那个。第 3 步最值得看:逗号之后,最高的候选也只有 24.7%——模型拿不准的地方,抽签规则最要紧。
这和评测有什么关系? 一个分数背后,其实是这一整条流水线。分词决定了同一段话算多少 token,所以“每秒多少 token”这种速度数字,换了分词器就不能直接比(第5期)。采样决定了同一道题每次答得一不一样:温度不是 0,就得多跑几次再看(第23期)。一次一个 token 的循环,决定了速度要拆成两个数:第一个字多久出来,之后每秒蹦几个(第16期)。
看看一句话被切成了几块
- 打开任意一个在线分词器的演示页(搜“tokenizer 在线”就能找到)。
- 依次贴进去:一句中文、意思相同的一句英文、一个 emoji,记下每一样被切成了几块。
- 再把“1883 年”和“一八八三年”各贴一次,看它们的切法有什么不同。
你会亲眼看到,第一站的“编号”和人的直觉差得有多远——分词是检查文本处理的一站;语音读错年份还可能来自规范化、读法规则或声学模型。
故事里出现的几个名词
| 术语 | 人话 |
|---|---|
| token | 词块,模型的最小处理单位;一切长度和计费的单位 |
| tokenizer | 分词器:文字 ↔ token 编号的翻译前台 |
| vocabulary | 词表:模型对应的号码簿,规模因分词器而异 |
| embedding / 向量 | 词的“性格档案”,一长串小数;相似性依训练与比较方式;不是事实认证 |
| hidden_size | 档案的长度(维度数) |
| self-attention | 在架构与掩码允许的范围内组合位置信息 |
| Q / K / V | 提问单 / 标签 / 内容——注意力的三份材料 |
| layer / head | 讨论的层数 / 每层并行的讨论小组数 |
| logits→采样 | 全词表投票表 → 按规则抽一个 |
| 自回归(autoregressive) | 一次生成一个 token、把它接回输入再生成下一个的循环方式 |
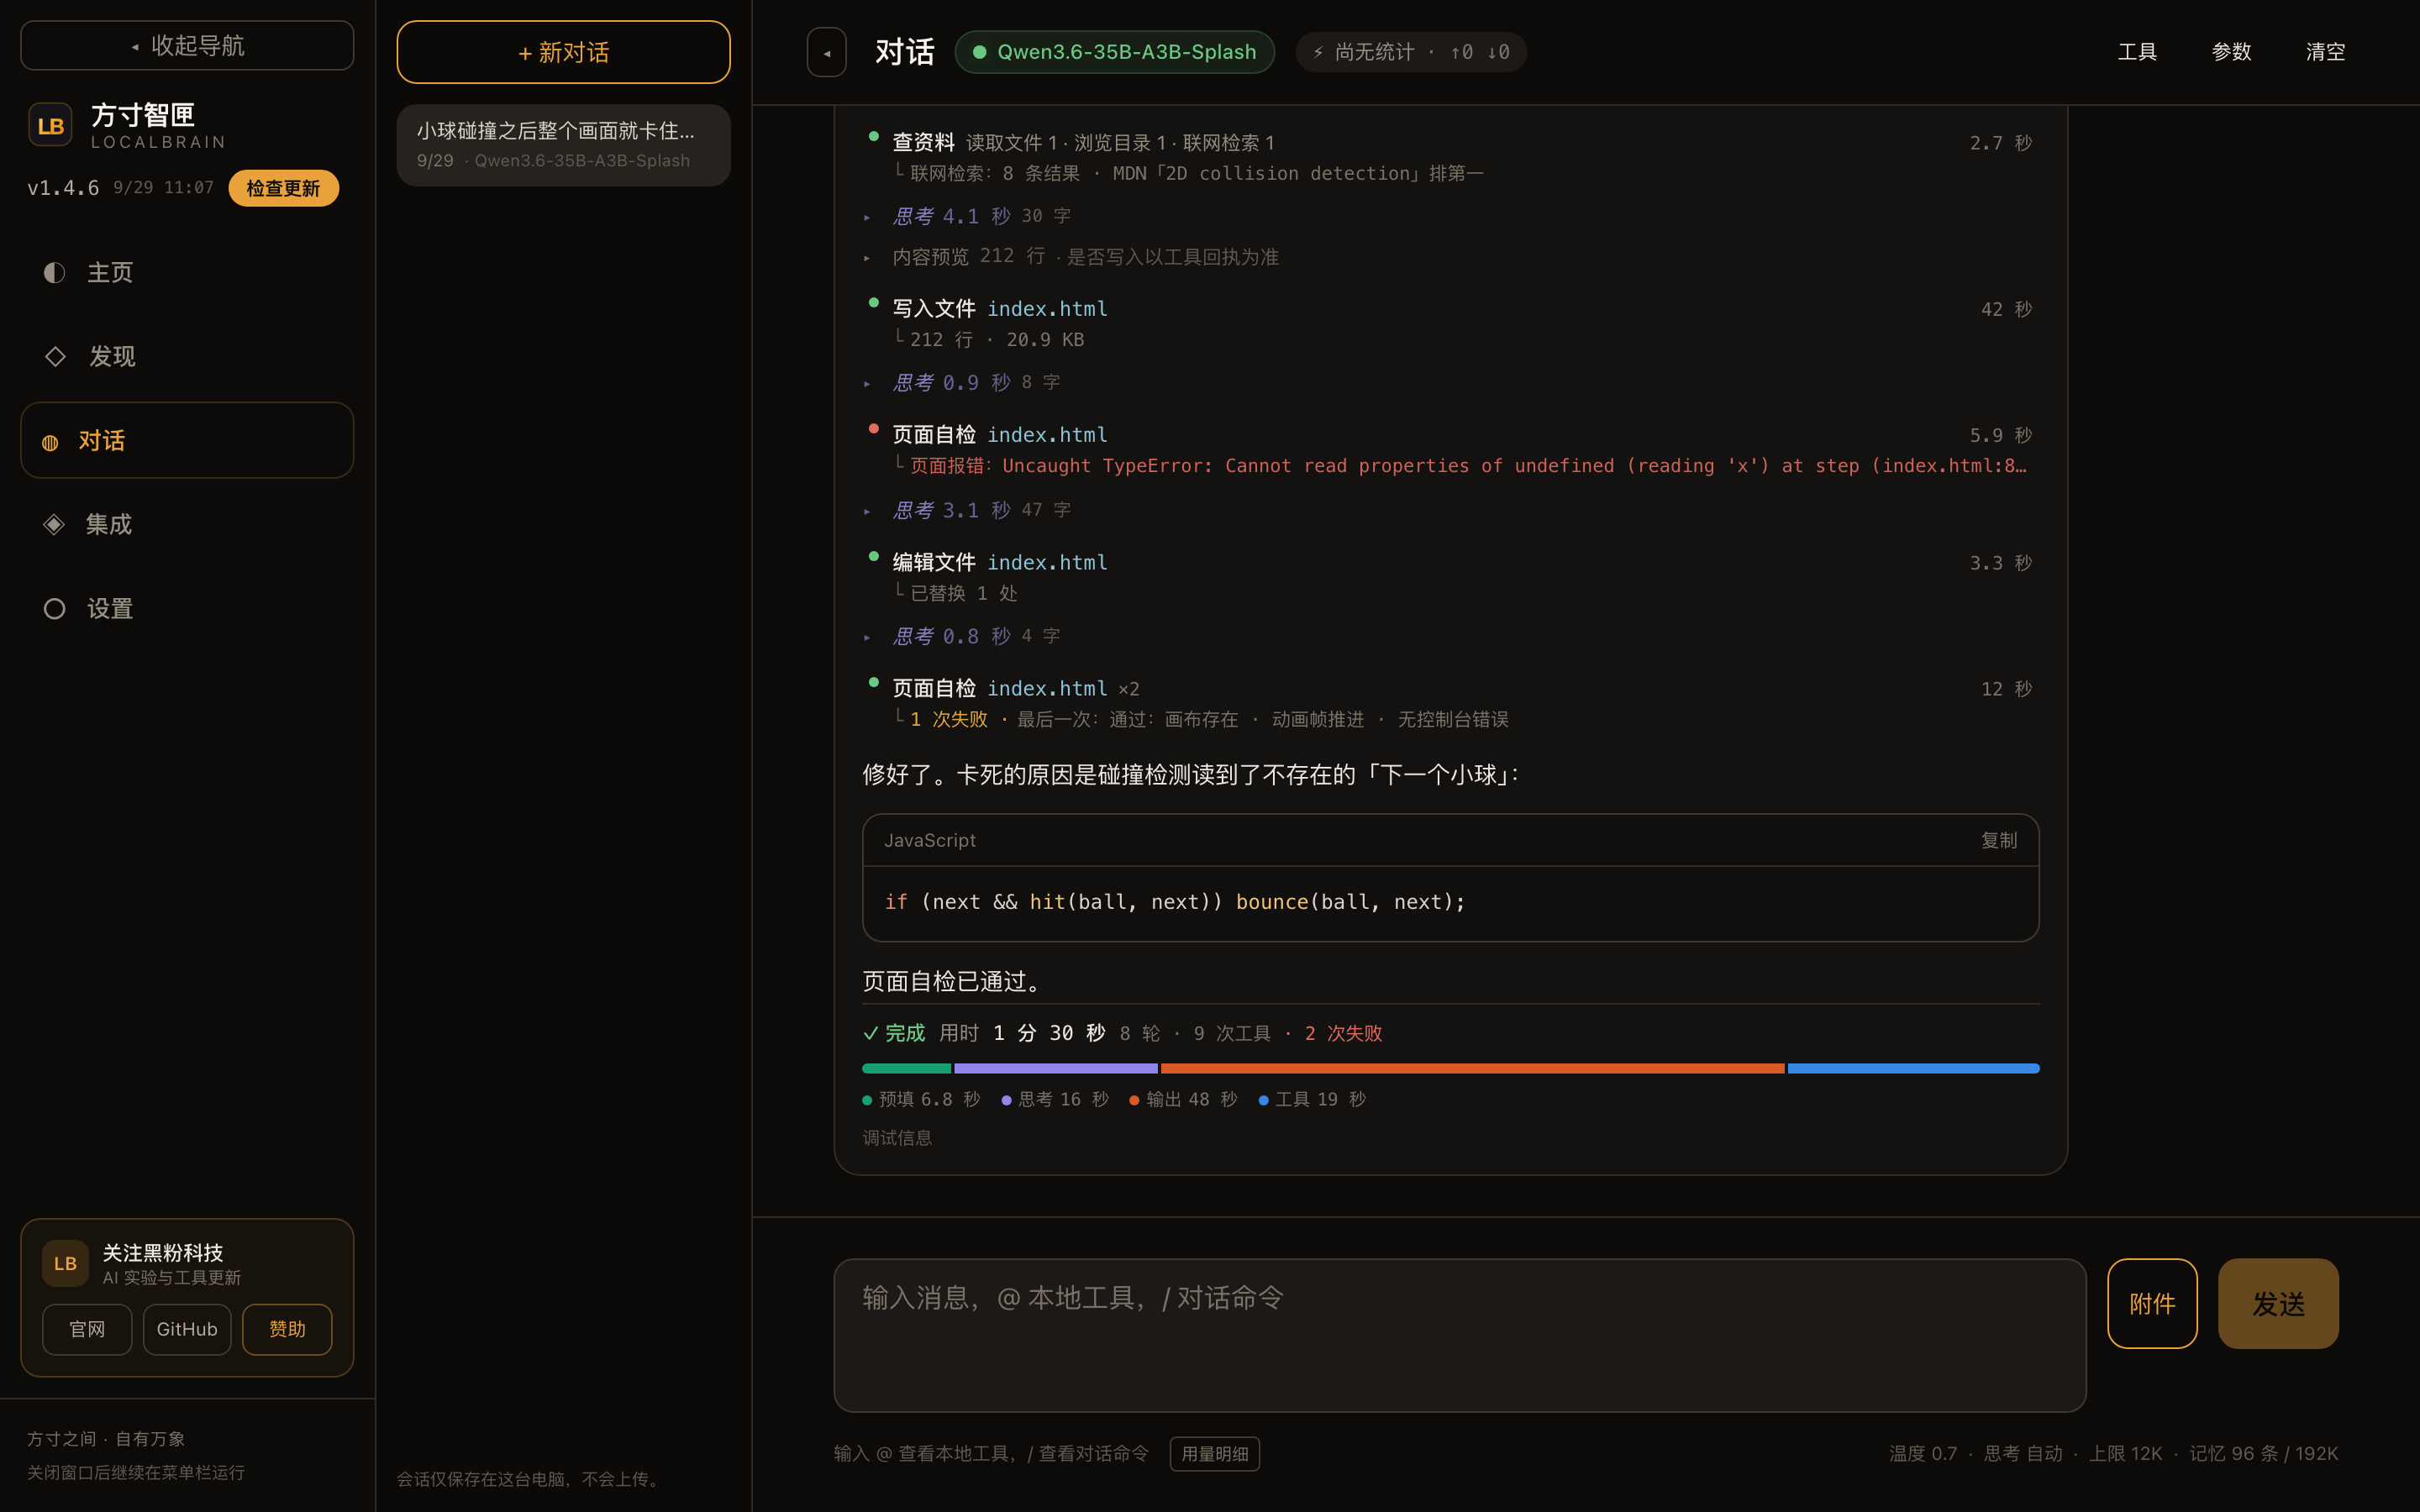
回到已有的LocalBrain旧界面:模型提出调用,工具返回错误,随后修改,再检查。这里是外围系统介入了回答过程,不是把所有动作都藏进神经网络。图中回执只能证明当时那几步,不证明每个任务都成功。
回到你的电脑
- 本地跑模型的工具(mlx_lm、llama.cpp、Ollama 这一类)起的就是这条流水线:每收到一次请求,就从第一站跑到第四站,循环若干次
- 推理模型的“思考”和正文,通常通过词元生成推进;预算是否共享、如何拆分依模型与服务实现:思考写得越长,留给正文的 token 就越少(第9期)
- 语音合成读错年份、字幕对不齐这类问题,还要检查文本规范化、时间戳、声学模型和对齐流程,不能只归因于分词
回到开头的问题
一句话带走:大模型 = 把文字换成编号(分词)→ 编号换成性格档案(嵌入)→ 回看全文分配注意力(attention)→ 从投票表抽下一个词块(采样),循环到抽中“结束”。
下一篇把镜头拉远:名字里那串参数、指令与量化后缀,怎样把一片模型市场变成你自己的选择。
参考资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
黑粉助手 HyphenAssistant
用手机浏览器接着操作电脑上的 DeepSeek Harness 会话;需原服务、电脑和网络保持在线,模型费用沿用原配置。
修复“开放端口”和“动态域名+开放端口”模式中,电脑无法回读自身外网地址时,配对二维码按钮一直不可用的问题。二维码和一次性配对令牌均在本机生成,不依赖在线二维码服务。外网回读失败时可以先生成二维码,再用手机移动网络实际测试;界面明确提示入口尚未验证。临时链接仍须实际连通后才能生成二维码。
方寸智匣 LocalBrain
本地 AI 工具箱:转写、配音、生图、视频和 MCP 工具集中管理;具体功能以对应平台版本为准。
Windows · Debian · AppImage · 完整验收 SHA-256:exe f3c4bdf65c914fee9ad49e8abe99975db771f99be0206e3d59b6efdb4e181efb · deb 9bdc2a0260e51f641347ed6aa379d5a8ed676d11c2c254031d…
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
图片与视频历史支持单条移除、批量清理已结束任务和撤销,默认只显示最近六条。清理状态与撤销信息在重开后保留,进行中的任务、生成文件、另存文件、原始事件与幂等键受保护;批量清理不受页面最近200条上限影响;新增可复用的平台协议配置:统一描述提交路径、类型化参数、模型列表、结果字段和异步查询。同协议新模型可沿用平台配置;协议、必填字段或输入…
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
修复 macOS 菜单栏右上角摄像头「视频效果」控制中心图标(人像居中 Center Stage、背景模糊、摄影室灯光)在 1.9.4 中消失的问题:将双二进制 execv 转发改为单主二进制直接链接 Electron Framework(桌面启动走 ElectronMain、无界面 api/info/pack/help 走 Elec…

微信赞赏 · 金额随意



留言
正在加载留言…