摘要 12 组全交付,但同题重复跑本身差 15 倍:长任务卡在外面那圈循环,不在模型。 黑粉科技 · M5 Pro 64GB 实测 · 2026-09-23
9 月 23 日早上八点半,我盯着一个进度条发呆。界面写着「均速 0.4 词元/秒」, 第 5 轮已经生成了 3,955 秒——六十六分钟。同一台 M5 Pro,同一个 Qwen3.8-27B-Splash,前一天测出来的解码中位速度是 53.4 词元/秒。差了一百多倍。
后来查明白了:模型早就跑完了。服务端日志写着 08:30:50 Done · output 1,900 · 32.9 tok/s, 五十八秒的事。流在第 51 秒静默,客户端又干等了 64 分钟。那个 0.4, 是拿词元数除以呆滞时间算出来的假速率。
**这就是本地长任务的真实形态:能不能跑完,多数时候不取决于模型有多聪明, 取决于外面那圈循环有没有替它收敛。**而那圈循环,在应用里,不在权重里。
**先把骨架给你。**下面十几节是一次次撞出来的,但撞出来的东西可以排成一条链——从买得起的硬件,到最后能不能写完一个文件,一共五层。每一层都能单独把长任务卡死,而多数人只盯着第一层。
| 层 | 它决定什么 | 本机实际卡在哪 |
|---|---|---|
| ① 内存 | 能装下多大的模型和多长的窗口 | 64 GB 跑 27B,余量够开 8 万词元窗口——但这层很少是真瓶颈 |
| ② 速度 | 一件事要花多久 | 解码中位 27–54 词元/秒;一轮 95%–100% 的时间花在生成,不在读历史 |
| ③ 额度 | 这一轮能写多少 | min(窗口剩余, 速率 × 单轮时长);超过约 567 秒后,卡你的从时间变成输出硬顶 |
| ④ 参数 | 配置有没有和模型对上 | 一组按 4B 算出来的预算跑着 27B——这层造成的损失比前三层加起来都大 |
| ⑤ 机制 | 循环会不会替模型收敛 | 流静默了没人管,客户端干等 64 分钟;判据太松,33 轮还在原地打转 |
前四层是物理和算术,第五层是软件写法。真正决定长任务能不能交付的,通常是最后一层
这一节是目录,不是结论。想直接看完整推导,跳到文末「本地部署到底被什么卡住」那一节;想知道我为什么会撞上它们,就按顺序往下读。
先说清楚「那圈循环」是什么
你让模型做一个能在浏览器里跑的贪吃蛇。它不可能一次吐完:要读环境、想方案、 写文件、跑自检、看报错、改回去。每一次「想 + 动手」是一轮,一个任务是很多轮。
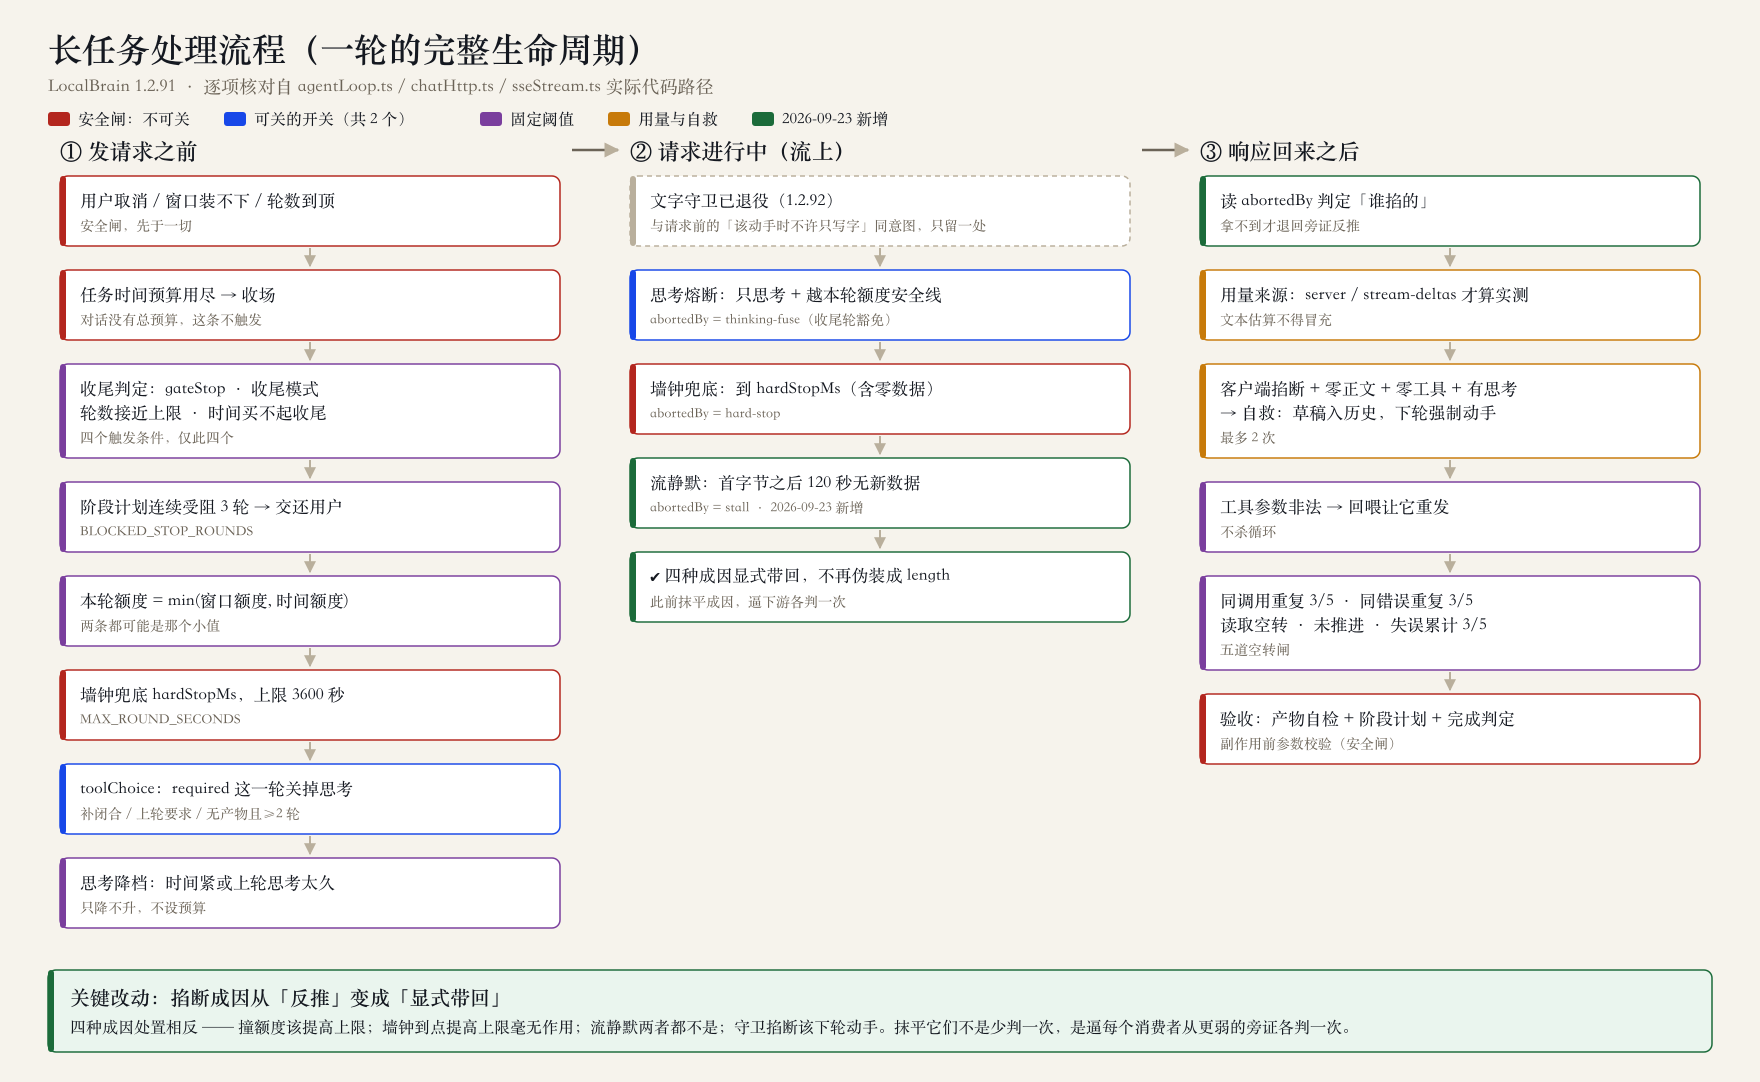
循环的工作就是在每一轮前后做判断:这轮该不该强制它动手?它是不是在原地打转? 额度还够不够?什么时候该停下来交差?这些判断加起来大约十三道,分布在三个位置—— 发请求之前、请求进行中、响应回来之后。上面那张图就是它们的全貌。
打个不太准但好懂的比方:模型是厨师,循环是厨房经理。厨师手艺没问题, 但他可能花四十分钟琢磨摆盘,可能把同一道菜重做五遍,可能菜齐了却不肯端出去。 经理不做菜,只负责在这些时刻插话。
拆开看:三种配置,十二组任务
四道题由简到繁——倒计时钟表、弹跳小球、贪吃蛇、打砖块;三种配置: 现有全部闸门(严格)、只放宽数值阈值(适中)、再关掉两个开关(宽松)。 每格记轮数、墙钟秒、产物字节、最终自检。
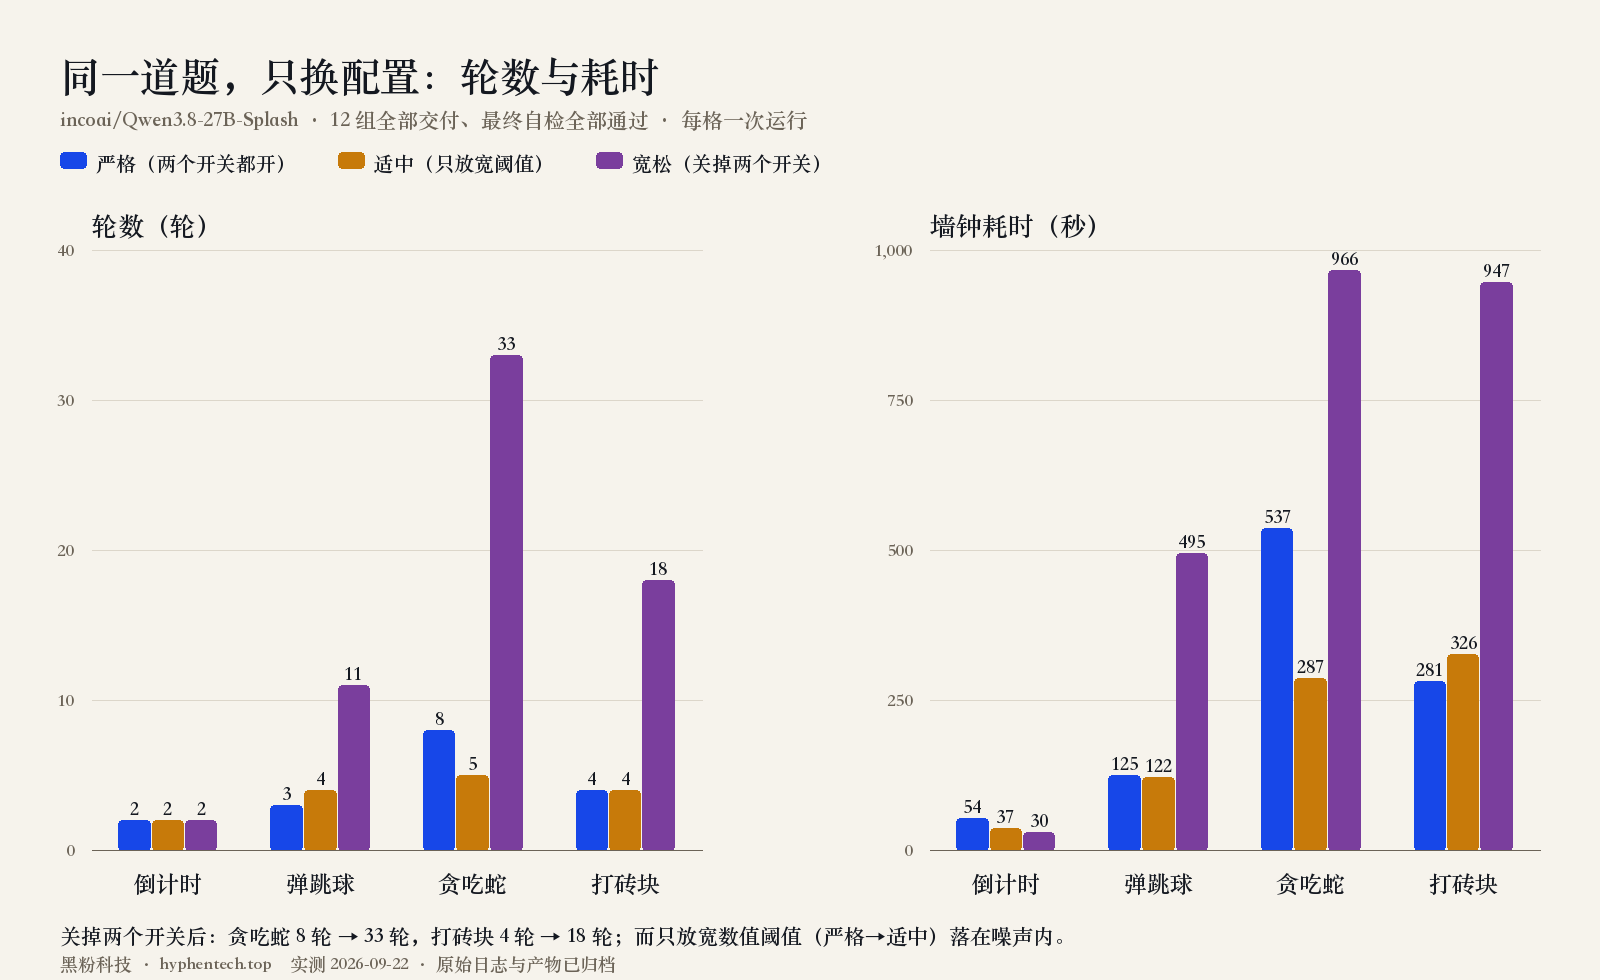
十二组全部交付,最终自检十一组通过。看到这张表我第一反应是「适中最优」, 这个判断是错的,我收回——理由下一节讲。
但表里藏着一个干净的自然实验。严格到适中,我只动了数值阈值(连续失误几次算空转, 从 3/5 放宽到 5/8 之类),两个开关一个没关,结果落在噪声内。适中到宽松, 阈值再放宽的同时关掉了两个开关,总轮数从 15 变 64。
数值阈值几乎不起作用,开关起决定作用。
顺带一个对照:这 12 组一共向 Splash 发了 110 次请求,解码速度最低 31.6、中位 53.4、最高 90.3 词元/秒。速度一直很稳,稳到它根本解释不了 17 轮和 64 轮的差别。
那两个开关是:尚无产物时强制调用工具,以及只思考、零产出时中途掐断。
宽松档省下的那点开场时间,账单开在别处:
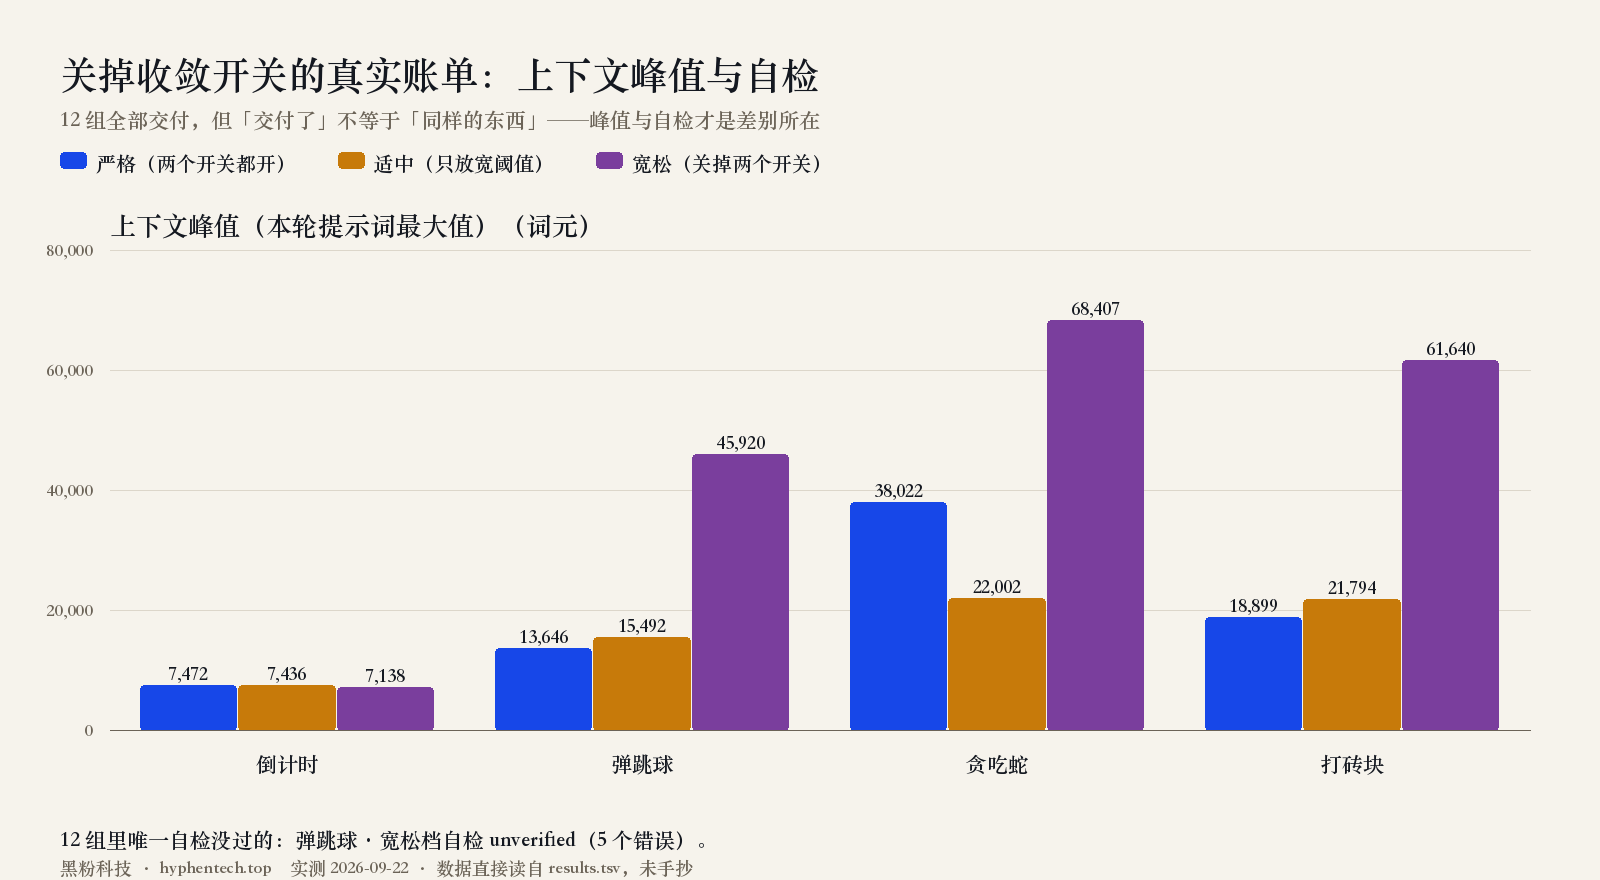
贪吃蛇那一组,上下文峰值从 38,022 词元涨到 68,407,几乎翻倍。 打砖块从 18,899 涨到 61,640。而十二组里唯一自检没过的, 正是宽松档的弹跳球——unverified,五个错误。「都交付了」和「交付了同样的东西」 是两回事。
最难的地方不是调参,是分辨噪声
这是我想重点说的一节。
同一道题、同一台机器、同一套参数,Ling-3.0-tiny 跑三次:5 / 12 / 39 轮, 88 / 270 / 1,346 秒。什么都没改,轮数差 7.8 倍,耗时差 15.3 倍。
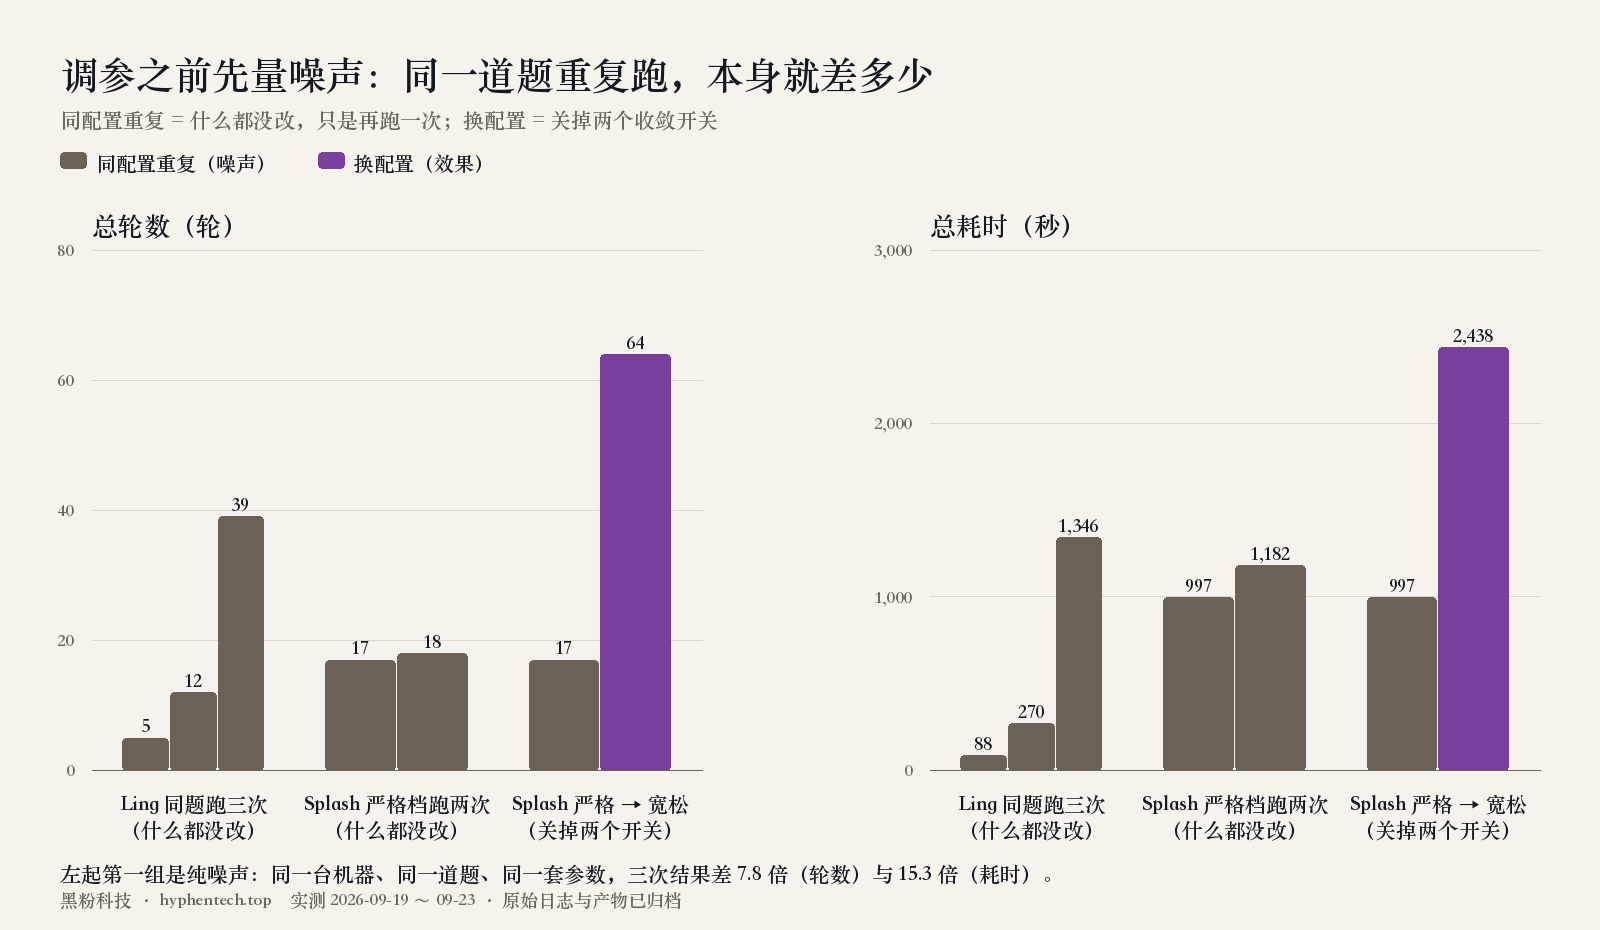
把这张图左边第一组(纯噪声)和右边第三组(真实效果)放在一起看,结论很刺眼: 在这个噪声水平上,跑一次就说「这个参数更好」,说的其实是运气。
9 月 23 日我重跑了严格档四格,想验证一处修复有没有让它变好。结果是 17 轮 997 秒 → 18 轮 1,182 秒。看着像退步了 19%,其实什么也说明不了—— 它落在噪声里。这次重跑的真实价值是回归检查:确认修复没有破坏已经能走通的路。
代价是实打实的。要在 15 倍跨度里分辨一个真实差异,需要的重复次数不是个位数; 而每一次重复在本机是几分钟到几十分钟的墙钟——这 12 组本身就跑了 4,207 秒, 接近七十分钟,还只是每格一次。「调一调参数」听起来像十分钟的事,实际是一整天。
这也是为什么我最后没有把数值阈值做成可调项。不是因为它不重要, 而是因为让用户在 15 倍噪声里自己试出一个值,是把不可能的任务转嫁给他。
当年 -O2 和 -O3 之争持续了很多年,很大一部分原因是基准测试的噪声接近两者的差距, 而每个人只跑一次。噪声吃掉效果,结论就会变成信仰。
关键选项:各自管什么,关掉会怎样
下面这张表按「你在界面上能改到什么」来排。有利与不利都是本机实测,不是推演。
| 选项 | 默认 | 作用 | 调高/打开的好处 | 调高/打开的代价 |
|---|---|---|---|---|
| 单次输出上限 | 自动 | 一轮最多生成多少词元(含思考与工具参数) | 复杂产物能一次写完,少几轮往返 | 思考也在这个额度里,越大越容易被思考吃光 |
| 单轮时长上限 | 180 秒 | 单轮墙钟兜底,上限 3,600 秒 | 慢机器不会被提前掐断 | 放太宽时,跑飞的一轮要等很久才停 |
| 工具代理轮数 | 自动 | 一个任务最多几轮 | 复杂任务有空间反复修 | 不收敛时把时间拖满才收场 |
| 思考强度 | 自动 | 给模型的思考预算份额 | 难题规划更稳 | 本地模板常把预算当建议,档位≠硬约束 |
| 该动手时不许只写字 | 开 | 连着两轮没产物就强制调用工具,并关掉这轮思考 | 避免一直描述计划不落盘 | 关掉后实测:弹跳球连做 8 轮重复自检,400 秒 |
| 只思考零产出时中途掐断 | 开 | 一轮只有思考、越过额度安全线时提前结束请求 | 不让一轮把整个额度烧在思考里 | 关掉后实测:一轮烧满 32,768 词元、11 分钟、零产出 |
| 上下文历史上限 | 24 条 / 12,288 词元 | 带多少历史进下一轮 | 模型记得住更早的决定 | 峰值直接推高,越长越慢越贵 |
| 截断自动接续 | 开 | 撞上限时带着已生成内容自动续写 | 长回答不会半截断掉 | 最多续 4 段,续不完仍是截断 |
| 上下文内存预算 | 50% | 剩余内存划给 KV 缓存的比例(1.2.100 起可调,30%–85%) | 直接换来更大的上下文窗口 | 留给计算缓冲和运行期波动的余量变少;分配失败会自动回退 |
**两个开关默认都开,就是加开关之前的行为。**数值阈值我没有暴露给用户—— 实测证明调它没有可观测效果,而一个调了没用的旋钮只会让人以为自己在控制什么。
这套剧本早在数据库的查询计划器身上演过一遍:调参手册厚得像砖头, 真正起作用的往往是少数几个开关,其余旋钮的存在更多是让人安心。 区别在于计划器手里有统计信息可依据,而这里没有——生成过程每次都不一样。
我不确定的部分
这套闸门是我一道道加出来的,加的时候每一道都觉得理所当然。9 月 23 日逐项核对, 发现其中三处是同一个病的不同变体:客户端自己掐断的请求,在消费端与「真失败」 长得一模一样。
文字守卫、思考熔断、墙钟兜底,三者中止后合成的终止原因都是「length」, 与真撞额度不可区分。代码里当初还专门写了理由:「不值得分出第三种状态让每个消费者 各判一次」。今天这句话被实测推翻——四种成因的处置相反:撞额度该提高上限; 墙钟到点提高上限毫无作用;流静默两者都不是;守卫掐断该下一轮强制动手。 抹平成因不是少判一次,是逼每个消费者从更弱的旁证各判一次,已经判错两回。
更难堪的是第三处:客户端拿不到服务端用量时会按文本长度估一个数填进去, 把「有没有拿到用量」这个信号抹掉了——而前两处的修复恰恰靠这个信号工作。 第三处会把前两处一起废掉。
至于开头那 64 分钟:读流的那行代码可以永远不返回。当时以为有兜底, 注释写着「由 undici 的 bodyTimeout 兜」。两点都不成立——这个选项在项目里 从没配置过,而且这条请求跑在 WKWebView 里,用的根本不是 undici。 静默的流当时零约束。
这些现在都修了:成因改成显式带回,读流加了总时限和首字节之后 120 秒的静默时限。 为这两处加的回归测试我都做了证伪——把时限逻辑短路掉,测试立刻挂死到超时; 还原后全绿。但我不敢说没有第四处。
当年做网页兼容也是这个局面:页面跑不通不是浏览器不够强,是缺一层抹平差异的东西。 不同的是那时候的差异可以穷举成一张表,而模型的失败形态写不出完整清单—— 今天这三处,每一处都是先在真实任务里翻车,才被我看见的。
后来:第四处有,而且其中一处是我自己漏看的
上面那句「不敢说没有第四处」写完的第二天,我按同一套办法把整条链再核了一遍。
先说最难看的一次。 我列了四条「从未触发、可以删」的机制,动手删的时候, 四次里错了三次:
| 候选 | 结果 | 为什么 |
|---|---|---|
| 文字守卫 | 删了 | 12 处引用 → 0,与「该动手时不许只写字」确系同一意图 |
| 撞上限截断反馈 | 救回 | 指纹写错了。真指纹在 103 次运行里触发 9 次 |
| 空响应闸 | 救回 | 全长 6 行、1 处引用。是安全网,不是复杂度 |
| 重复调用封锁 | 救回 | 改成「一律封锁」挂了 5 个测试,其中一个叫「失误上限是最后一道防线」 |
三次错的模式完全一样:拿「触发 0」当「无价值」。而那个 0 有两种来源—— 指纹搜错了,和它本来就是安全网(守住的事没发生,所以为零)。 更难堪的是,我自己写的核对文档第一节就写着「从未触发不等于无价值」, 然后照样按触发数去删。写下规则不等于会执行规则。
第二处是状态没被记下来。 那圈循环里有 22 个决定行为的局部变量, 检查点只存了 8 个。103 次运行里有 25 次真的从检查点恢复过——恢复之后, 「熔断后还能自救几次」和「连续几轮没推进」这两个计数器都从零开始。
重点不是「这 14 个都是 bug」。轮数预算归零是故意的,代码里有一行专门的守卫; 另外两个是没人决定过。现在的状态是:分不清哪些重置是设计、哪些是漏的, 因为没有任何地方记录过意图。
第三处是我自己的认知错误,而且犯了两次。 有人问我「到上下文极限前压缩 不能解决问题吗」,我两次回答「主动折叠默认关着」。翻代码才发现, 压缩其实有三层,而中间那层一直开着:正常工作预算放不下时, 程序会专门发一次无工具请求做摘要、替换历史,还要验证摘要确实装得下、 确实变小了才采纳。
我为什么会漏看它?因为我搜的是「fold / 折叠」,而这条路径在代码里叫「交接」。 **搜索词锚定了实现术语,没锚定语义。**同一个毛病这两天让我连错七次日志指纹。
内存明明还有,上下文为什么满了
顺着这个问题查出一个实打实的参数。本机 64 GB,模型常驻 33.3 GB, 扣掉系统预留 6 GB、应用预留 3 GB,还剩 21.7 GB。但真正进 KV 缓存的只有 10.85 GB——因为算式里写死了「剩余的一半」。另外那 10.85 GB 就这么闲着。
这个参数是真的,但我当时把它和另一件事接错了。界面上显示的窗口是 81,920, 我顺手用这条算式解释了它:10.85 GB 按每词元 139 KB 算,正好够开八万多。 数字对得上,因果是错的。
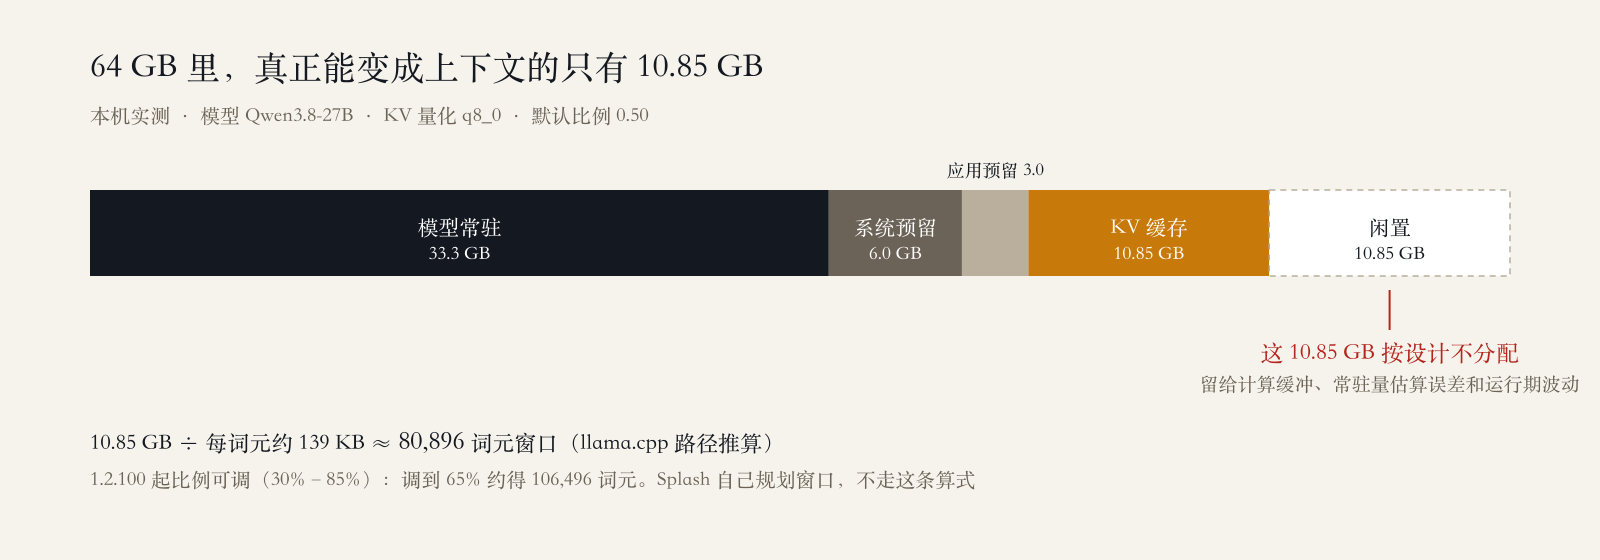
剩下那一半不是浪费:计算缓冲、常驻量估算误差、运行期波动都从它出。 但 0.50 是个保守默认,不是实测最优,源码里也没有任何注释说明为什么是 0.50。 所以 1.2.100 起把它开放成可调(30%–85%,默认不变)。按本机估算, 对走 llama.cpp 的 GGUF 模型,调到 65% 能把窗口推到十万出头—— 这个滑块管不到 Splash,原因下一段说。
调高不是免费的,但有自愈兜底:分配失败会被记下来,下次自动降到失败值的三分之二。
一个月后我发现这条解释是巧合
9 月 24 日重查这件事,我把那条内存算式单独拎出来跑了一次: 喂进 Splash 的真实参数,它返回的是 null——根本没执行过。 Splash 的模型包里没有 config.json,读不到每词元的 KV 开销, 那条算式缺了必需的输入,直接放弃。
81,920 来自另一个地方:一行写死的兜底常量,注释写着 「仅供旧 GGUF 缺失元数据时回退」。Splash 不是 GGUF,也不缺元数据, 它只是没被认出来——程序找的是 llama.cpp 的启动参数 --ctx-size 和 /props 接口,Splash 两样都没有,于是一路掉到兜底。
而那条内存算式按同样的输入算出来是 80,896。和 81,920 差 1,024。
差这么一点,是最难发现的那种差。要是差一倍,我当天就会去查; 偏偏它严丝合缝,我就把一个常量当成了计算结果,还写进了文章。 能解释得通,不等于是那个原因。
真正的窗口一直摆在那儿:Splash 自己在 /status 上公布 maximum_context_tokens: 262144,我们从来没问过它。 1.3.5 改成读这个数之后,同一台机器上记忆预算从 61,440 涨到 196,608, 保留条数从 64 涨到 96。
值得一提的是,这已经是同一条线上的第二次了。1.2.44 时我也收到过 「内存还有余量,参数是否太保守」,那次的结论是把旧的 20%+20%+55% 换成 现在这个统一预留模型。一个参数被问第二次,通常说明它该交给用户,而不是再调一次默认值。
真凶:一组按 4B 算出来的预算,跑着 27B
前面查到的都是机制里的毛病。但真正让我这一个月觉得「本地模型做不完长任务」的, 是一个更笨的东西。
9 月 24 日我把同一道题——做一个有采集、建造、战斗和胜负的单文件 HTML 游戏—— 翻出来重查。这道题我断断续续跑过 17 次,一次都没完成过。
先看这 17 次是怎么结束的:
| 停止原因 | 次数 |
|---|---|
| 「已按请求停止本轮任务」= 我自己按的停止 | 11 |
| 撞单次输出上限 | 2 |
| 未推进闸 / 读取空转闸 | 2 |
| 无记录 | 2 |
三分之二是我自己放弃的。而机制真正判死的那几次,理由指向同一处:
本轮实际生成 2,185 词元(单次上限 2,185),已用完但尚未开始正文或有效工具调用
单次上限 2,185 词元。 一份能跑的这类游戏至少上万词元,这个额度连开头都写不完。 模型每轮被截断,产物不变,未推进闸最后判它空转——看起来像「模型不行」, 其实它连一次完整表达的机会都没有。
而这 17 次里上下文没成为瓶颈:上下文折叠 0 次、摘要交接 0 次, 模型那侧 256K 的窗口最多只用到 16%。
这句话我后来收窄了。循环真正发给模型的输入上限不是 256K,是当时那个 81,920 减去预留之后的 61,440。9 月 24 日跑一道 3D 建造题时, 第 19 轮的剩余窗口只有 5,973——7%,模型开始反复重读同一个文件。 所以准确的说法是:在这 17 次里它不是瓶颈,不是「从来」不是。
查到最后,原因笨得让人不舒服:界面里选中的模型是一个 4B 的小模型, 而这 17 次跑的全是 27B。 自动优化按选中的 4B 规划预算,给出 单次输出 6,144 / 上下文 24,576,而且每次启动重新盖一遍—— 我手工改大过,重启就被覆盖回去,当时只当是自己记错了。
把选中模型换成真正在跑的那个之后,同一套自动优化自己算出了 16,384 / 61,440。
一次单变量对照:同一个模型,只把单轮时长从 180 秒改成 600 秒
参数修好后我做了一次对照,除单轮时长外全部不变:
| 180 秒 | 600 秒 | |
|---|---|---|
| 结果 | 草稿 · 自检未通过 | 已交付 · 自检通过 |
| 交互检查 | 4 项未过 | 12 项全过,864 个动画帧 |
| 轮数 | 11 | 6 |
| 耗时 | 710 秒 | 783 秒 |
| 整轮空转(被思考熔断掐断) | 5 次 | 1 次 |
多花 73 秒,换来的是从「未验证的草稿」变成「已交付且自检全过」。
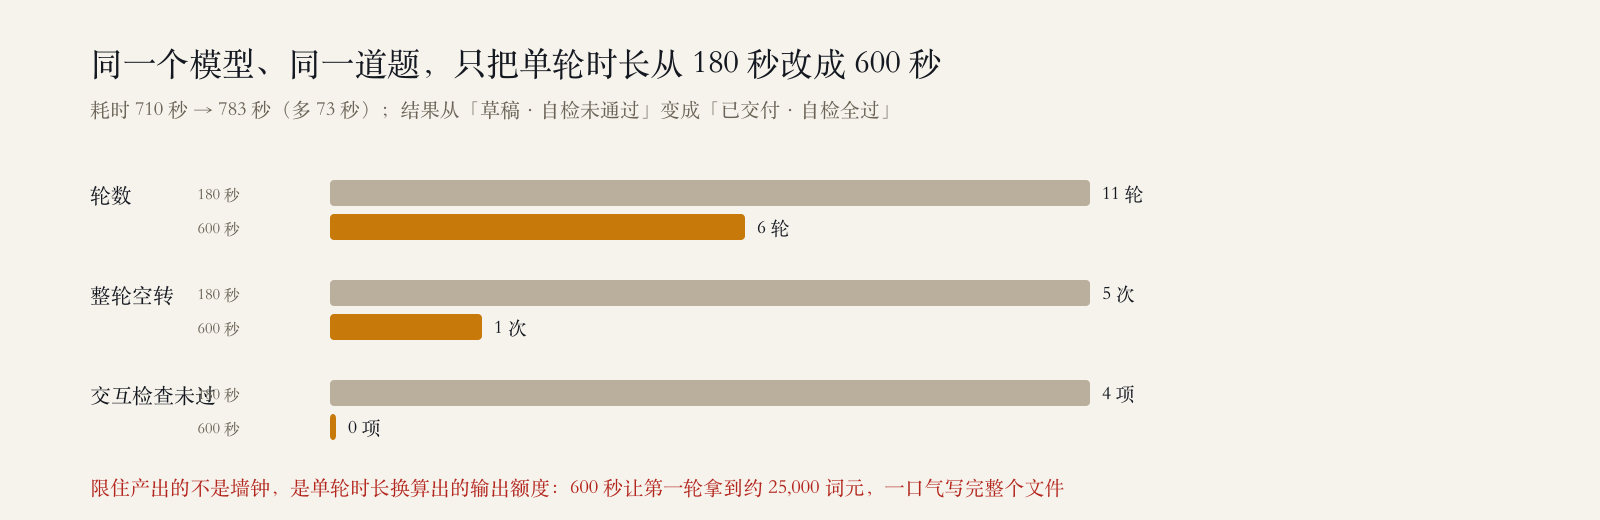
关键不在墙钟。单轮时长限的是它换算出来的输出额度(实测速率 × 秒数): 600 秒让第一轮拿到约 25,000 词元,一口气把整个文件写完——那一轮实际用了 374 秒; 180 秒只有约 7,700,写不完,后面十轮都在打补丁。
省下的不是时间,是浪费。
对照组:把同一个模型交给另一套调度
为了确认这不是「模型碰巧这次状态好」,我把同一个模型、同一道题交给另一套开源的 agent 调度框架跑,端点、额度、权限全部对齐:
| 额度 | 耗时 | 产物 | |
|---|---|---|---|
| 另一套调度 · 第一次 | 8,192 | 248 秒 | 0(我没开工具批准,失误) |
| 另一套调度 · 第二次 | 8,192 | 221 秒 | 0(额度只给了四分之一,又是我失误) |
| 另一套调度 · 第三次 | 32,768 | 843 秒 | 0(条件对齐后仍为 0) |
| 本文这套 | 32,768 | 783 秒 | 411 行,自检通过 |
第三次是公平对照:额度翻到四倍、时间多给六十秒,仍然一个文件都没写出来。 十万字节的输出从头到尾没离开推理,结尾还在讨论一个辅助函数该怎么定义。
差别就是前面那两道闸:一轮只思考零产出就中途掐断,以及 连续无产物就关掉思考、强制调用工具。180 秒那组靠它们救回了五轮。
这也顺便纠正了我自己的判断:前两次对照失败得特别干净(产物为零), 我一度把它当成有力证据,后来才发现两次都是我把对照组配瘸了。 对照组的结果越符合预期,越该先查它是不是根本没跑起来。
⚡ Splash 凭什么快:草稿模型换了三代
前面一直在说「外面那圈循环」,但速度这一层本身也在变。这台机器上跑的 Splash,解码中位能到 53 词元/秒,而同样是 27B 参数量,llama.cpp 那边只有 9.11 词元/秒。差出来的部分里,有一块不是量化位宽给的,是解码方式换代给的。
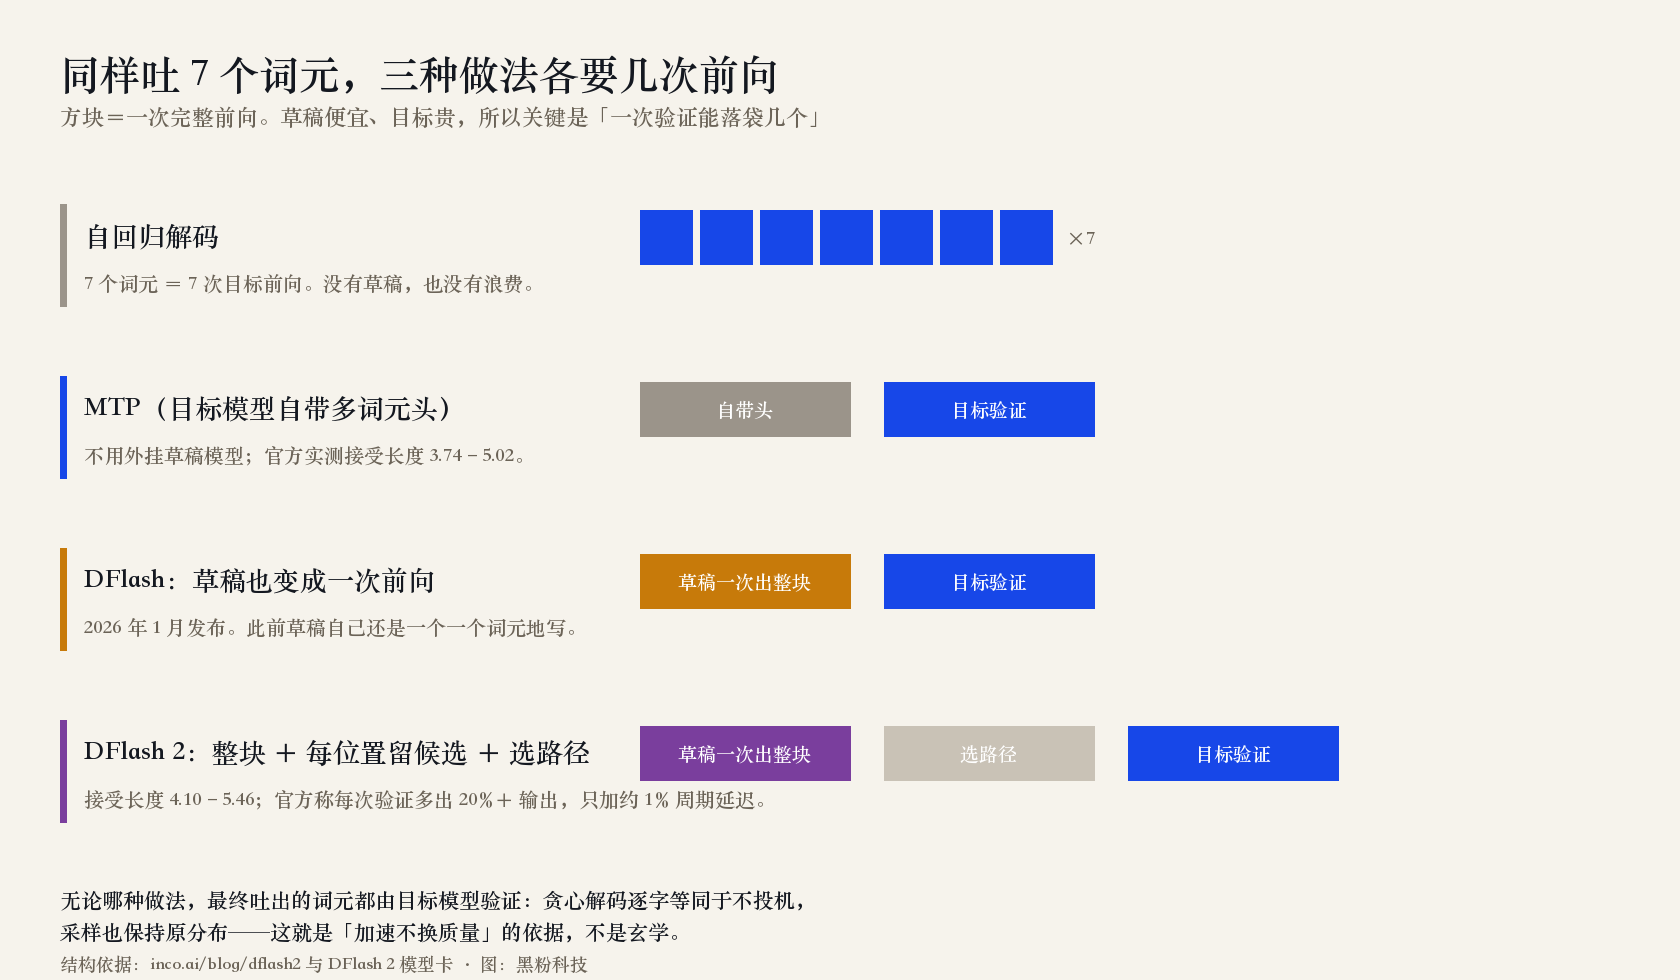
先说基本盘:投机解码。一个小的草稿模型先猜一串词元,目标模型把这一串一次前向全部验证。猜中就一次落袋好几个,猜错就丢掉重来。关键在于——最终吐出来的每个词元都经过目标模型验证,所以贪心解码的结果和不投机逐字相同,采样也保持原分布。这不是「用小模型换速度」,是加速不换质量。
三代的差别就在草稿那一头:
- MTP(多词元预测):不外挂草稿模型,用目标模型自带的多词元预测头一次提几个候选。Qwen3.8 自带七词元 MTP,官方实测接受长度 3.74–5.02。
- DFlash(2026 年 1 月):在此之前,草稿模型自己还是自回归的——一个词元一个词元地写。DFlash 把草稿也变成一次前向:整块所有位置并行预测出来。
- DFlash 2(2026 年 8 月):官方的说法很实在——每个位置各自独立预测,会在两处留下余量:选对词元和把精度保持到块尾。DFlash 2 用「每个位置留多个候选 + 一个轻量选择器挑出一条连贯路径」补第一处,用主干里的 two-tap 动态卷积补第二处。代价是约 1% 的周期延迟,收益是每次验证多出 20% 以上的输出。
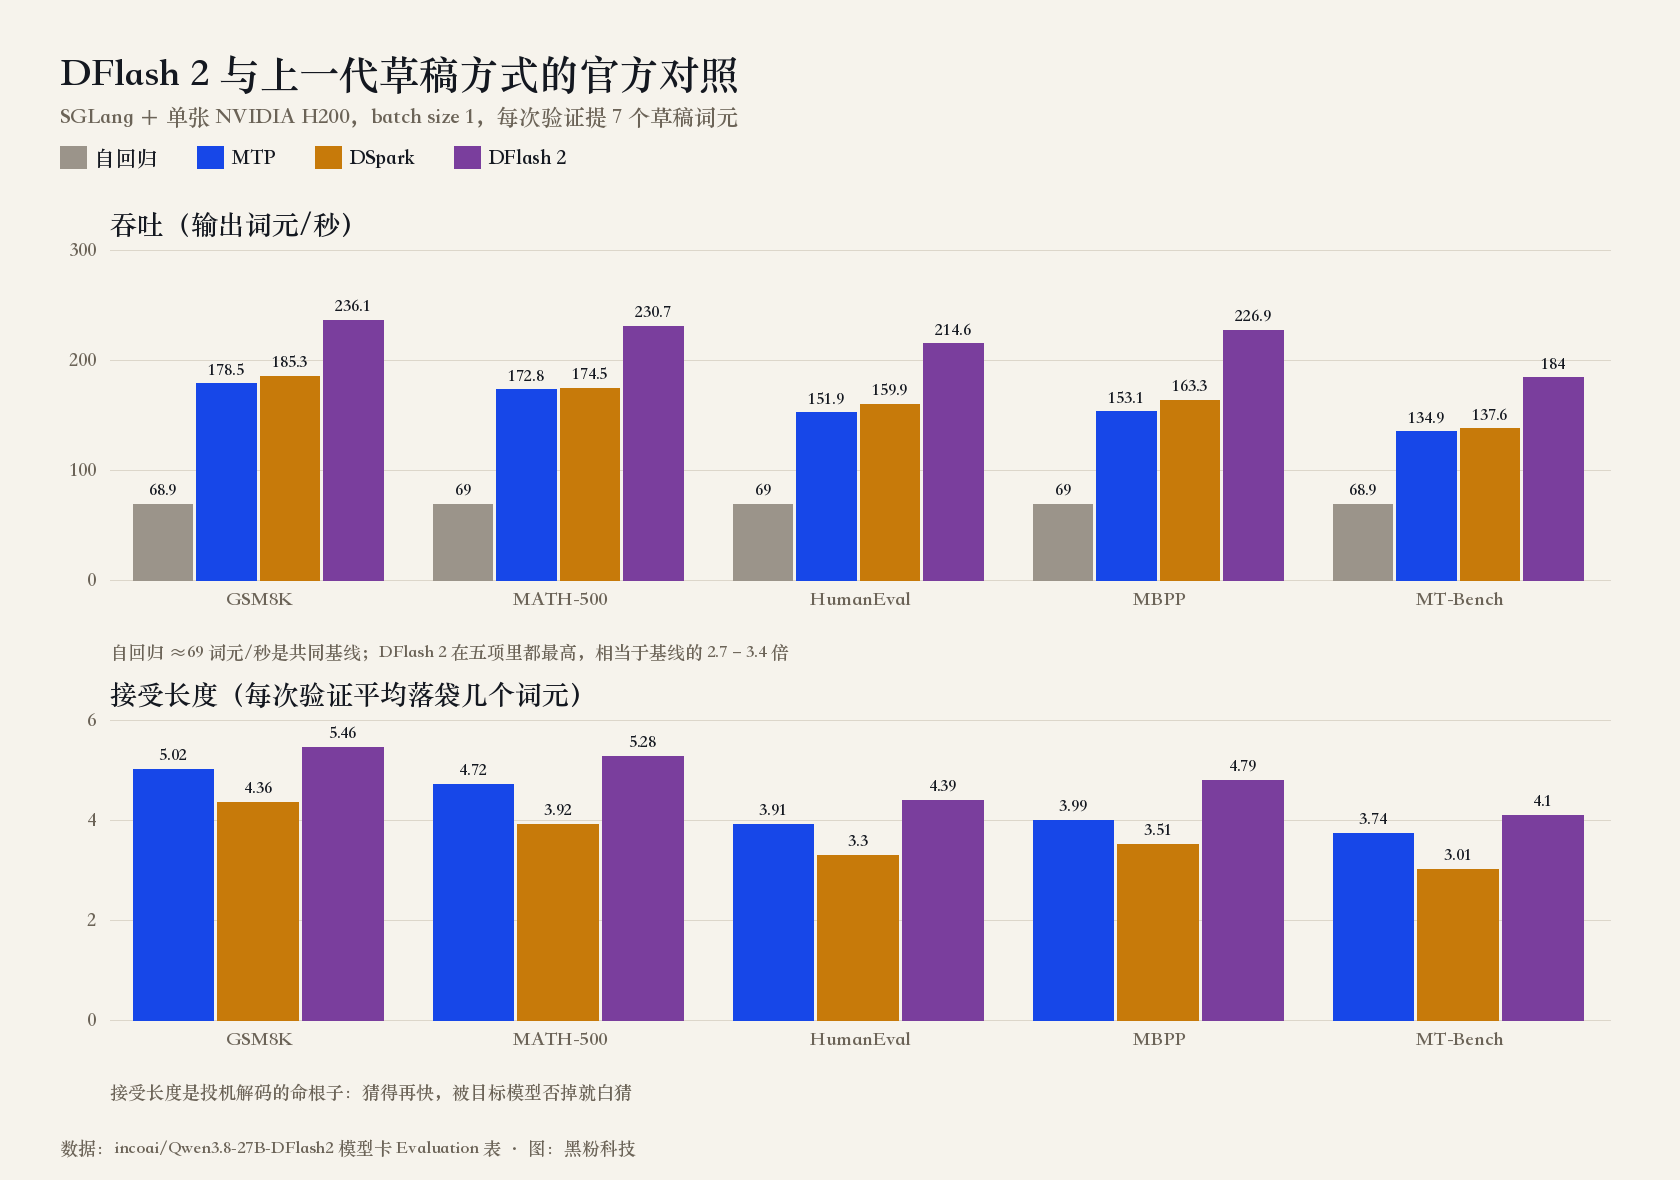
把这两张表读薄一点:**接受长度是投机解码的命根子。**猜得再快,被目标模型否掉就等于白猜。DFlash 2 把接受长度从 MTP 的 3.74–5.02 推到 4.10–5.46,于是同样的硬件上,吞吐从自回归的 69 词元/秒变成 184–236,也就是官方说的 2.7–3.4 倍。
而 Splash 是把这套东西搬到苹果芯片上的引擎(Inco AI 开源,brew install incoai/tap/splash)。本机跑的 incoai/Qwen3.8-27B-Splash 不是一个普通权重包,里面装着四样东西:4-bit 的目标模型、它的 DFlash 2 草稿模型、视觉编码器和分词器——只能在 Splash 里加载,MLX 和 Transformers 都打不开。门槛是 M3 以上、macOS 26.4 以上、36 GB 统一内存(官方建议 48 GB 起)。
警告 **别把上面那些倍数搬到自己机器上。**那是 H200 + SGLang 的数字,本机是 M5 Pro + Metal,量级完全不同。而且我这台上 Splash 与 llama.cpp 的速度差里,混着量化位宽(4-bit 主模型 vs Q8_0),这次实验分不开哪一部分是投机解码的功劳。要拆开,得再跑一组 llama.cpp 的 4-bit 27B 做对照——我还没跑。
📒 一份真实的请求账本:我自己用它做了什么
上面那些是台架数据。这一节换成我自己的日常使用记录——方寸智匣会把每一次模型调用记进本地账本:什么模型、提示词多大、写了多少词元、多快、怎么结束的。取 9 月 24 日晚到 9 月 25 日下午这一段,200 次请求,187 次完成,只涉及两个模型,都是 Splash。
先看东西:这段时间做出来的九个文件
账本里那些数字,最后都变成了具体的东西。下面八张是实际运行画面——全部是单文件 HTML,双击就能在浏览器里打开:没有构建步骤,没有 npm,没有后端,也没有一次是我自己写的代码。
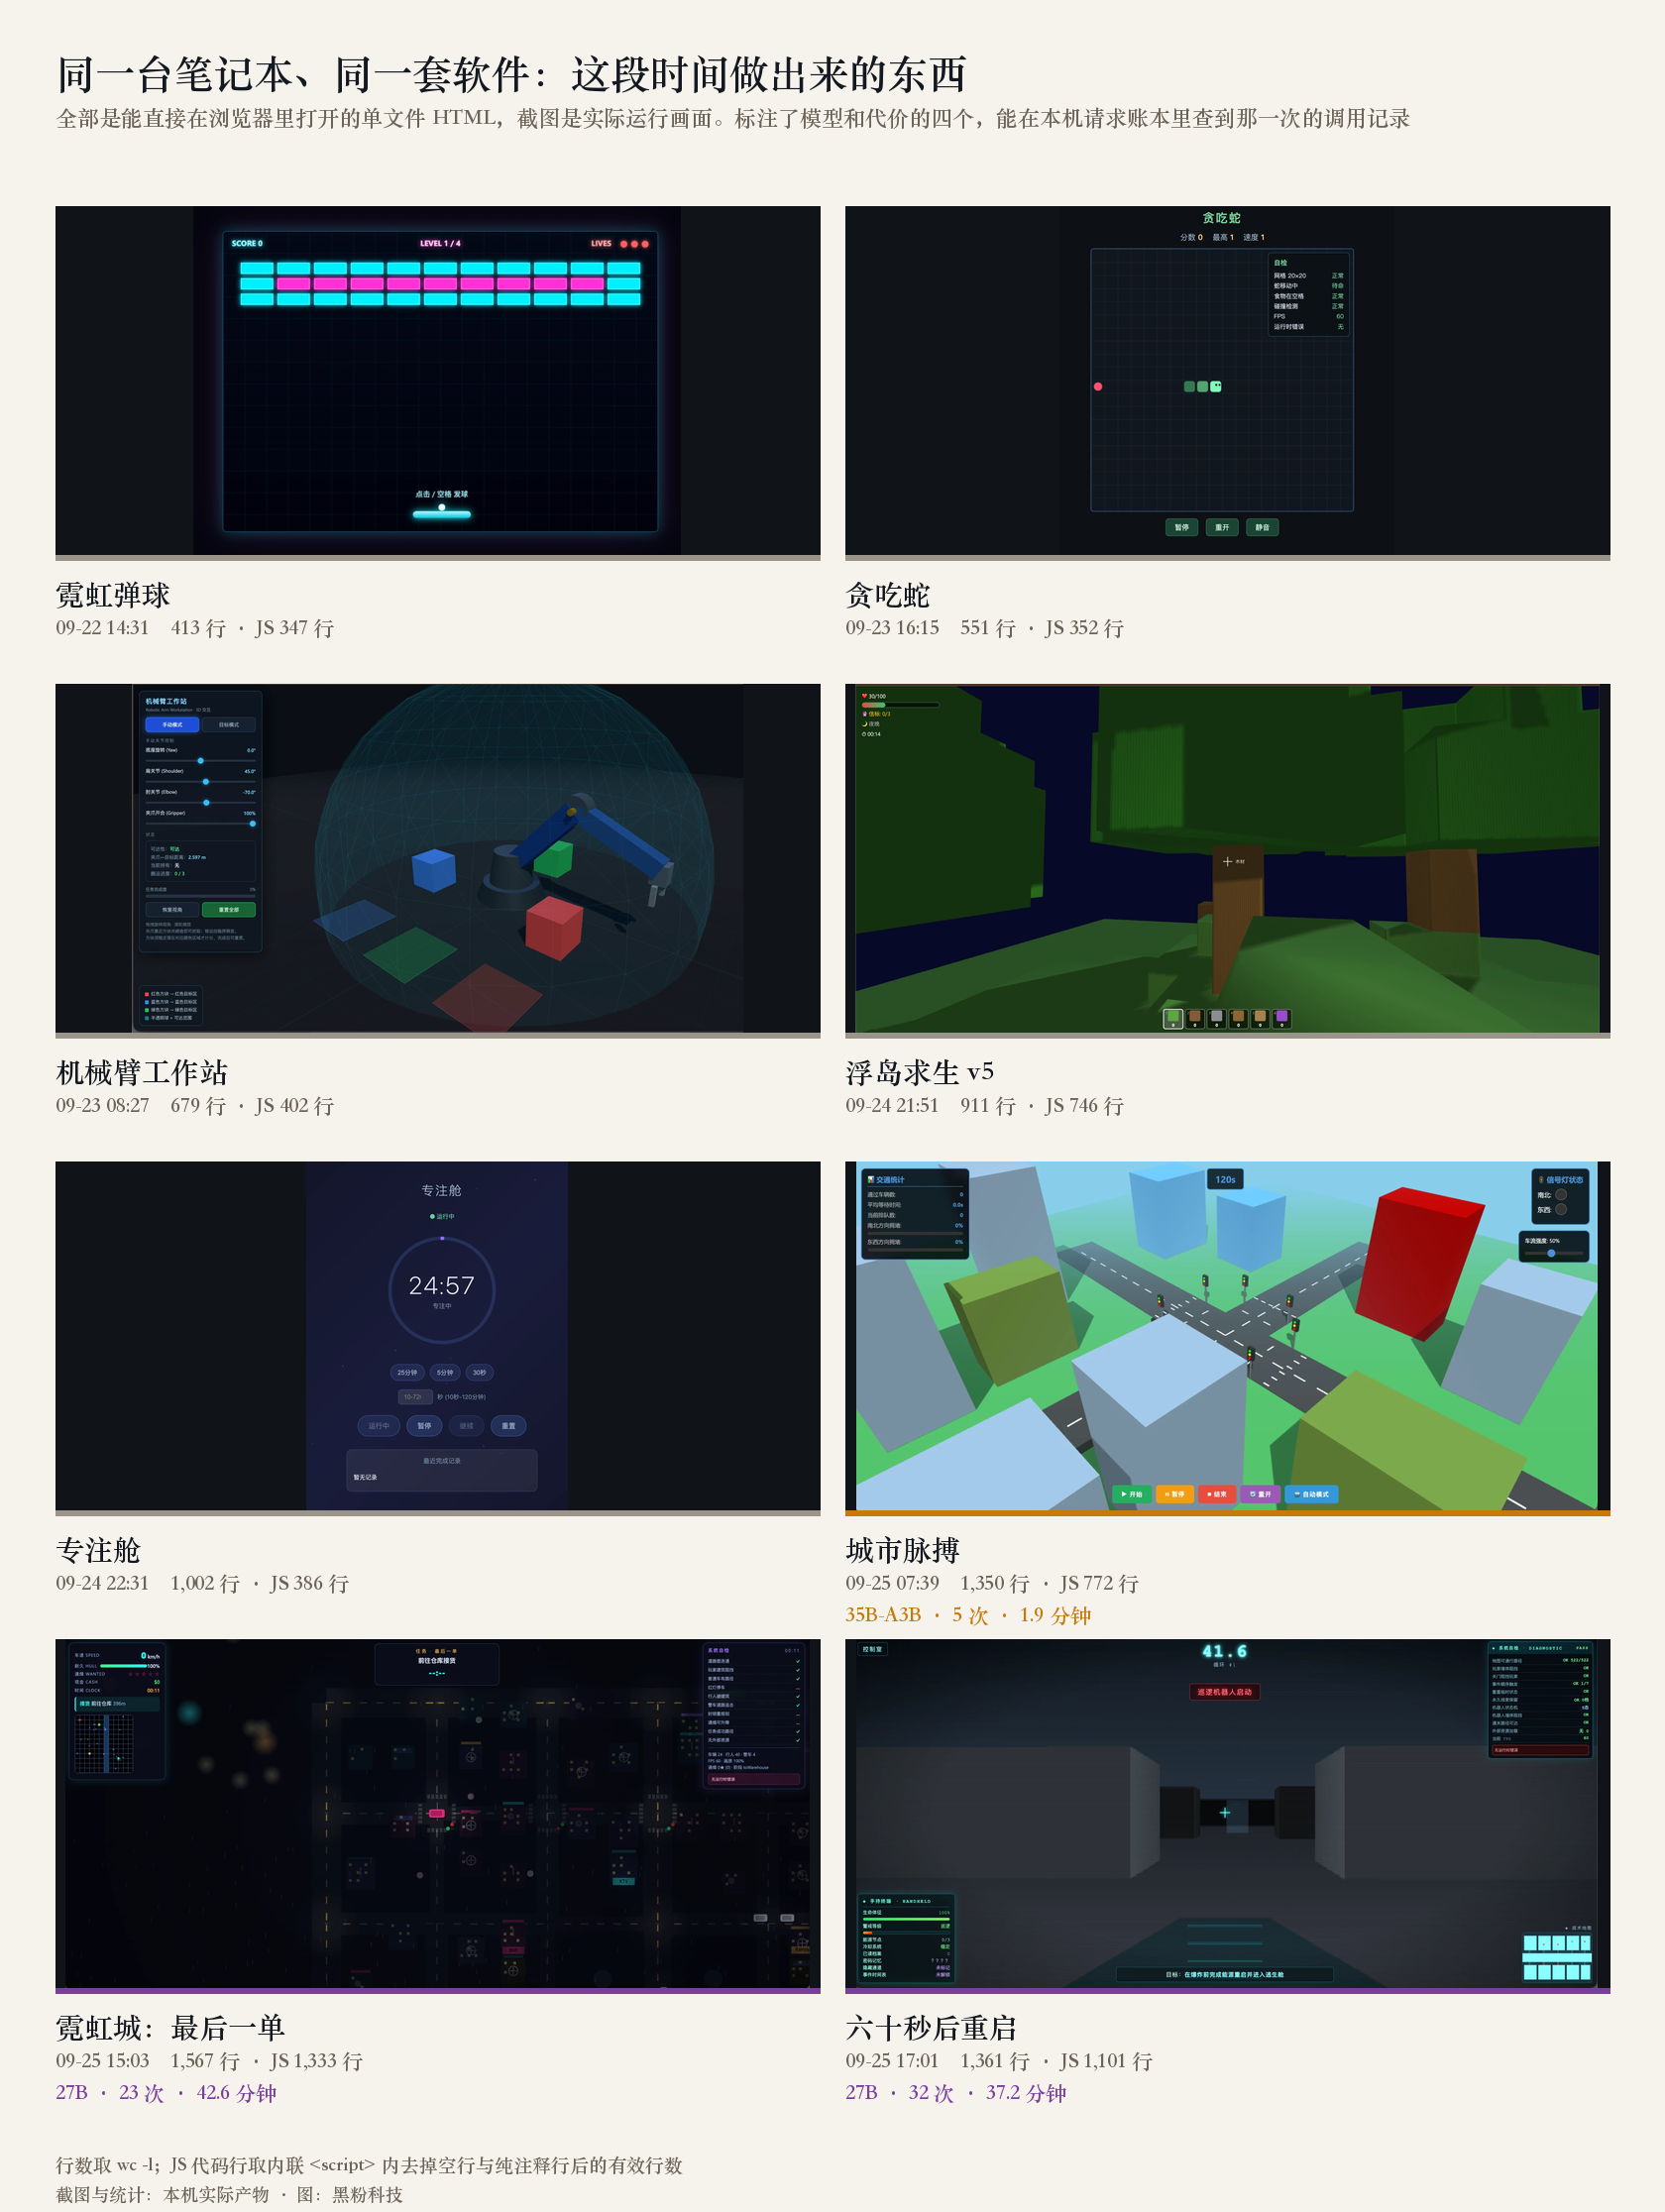
**归档目录里其实是九个文件,这里只有八张截图。**少的那一张不是我忘了拍——是它没有运行画面可拍。这一节的最后会回到它。
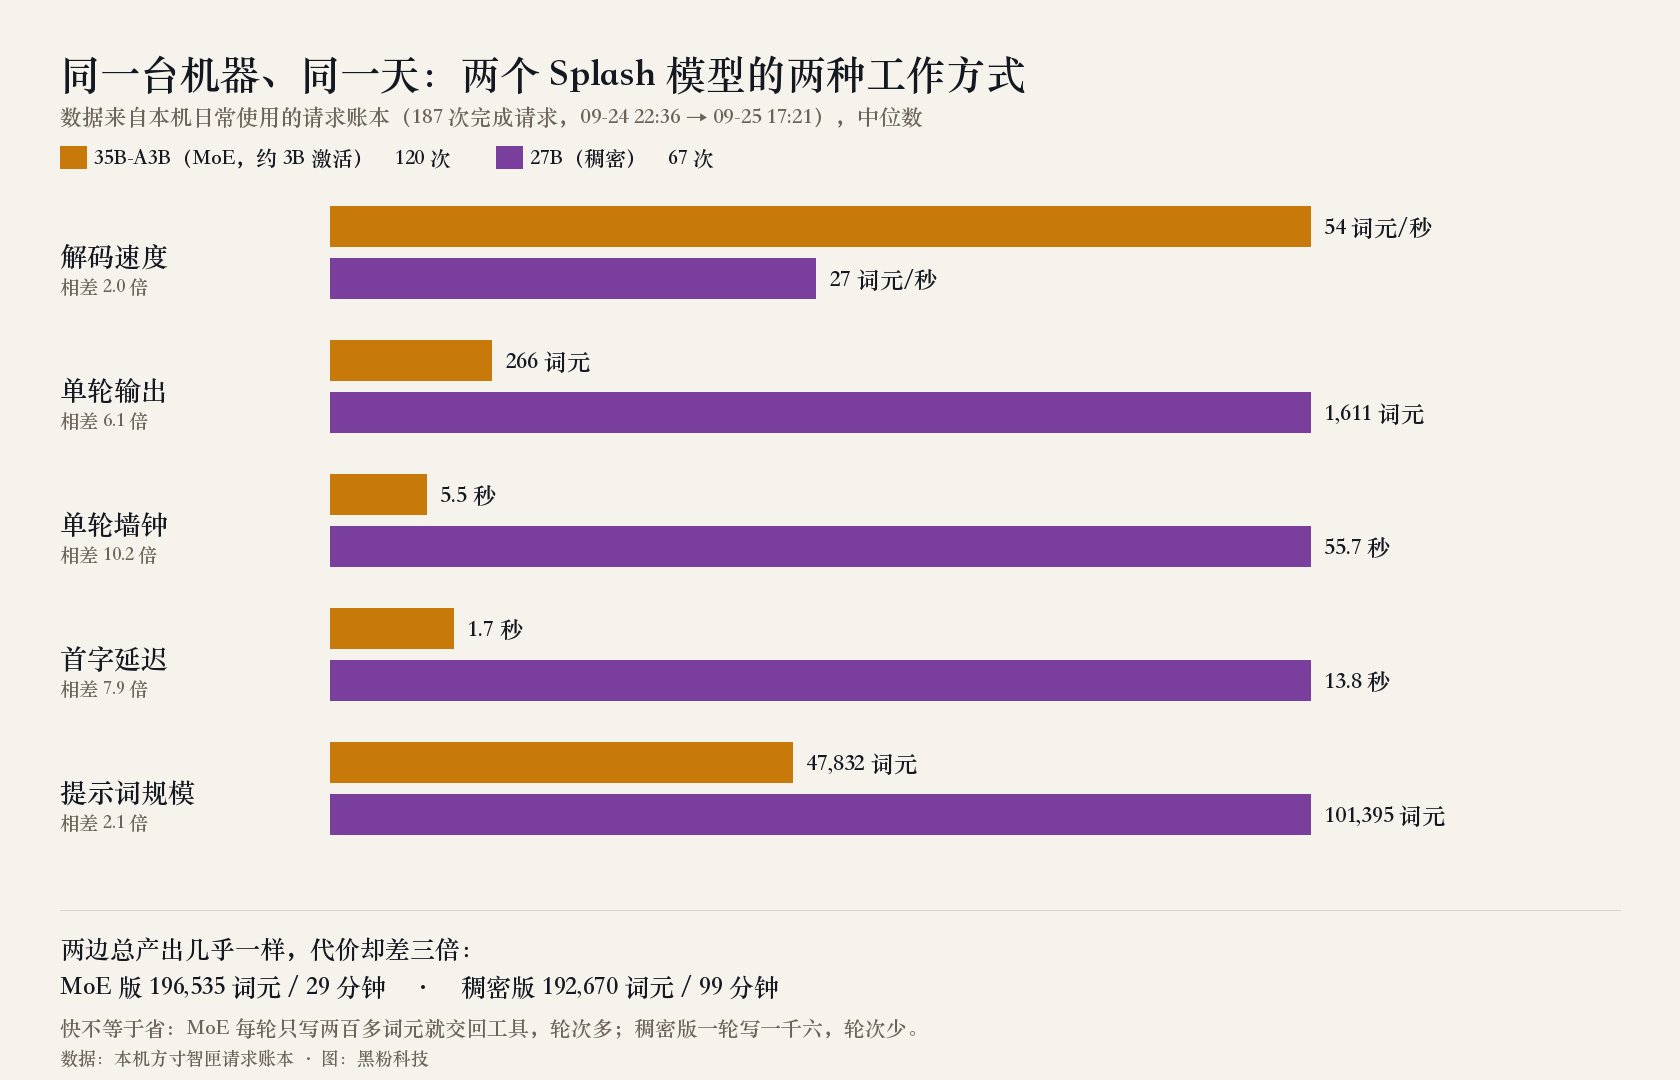
**同样是 Splash,两个模型是两种工作方式。**MoE 那个(35B 总参、约 3B 激活)解码 54 词元/秒、一轮只写 266 个词元、5.5 秒就交回工具,首字 1.7 秒就出来;稠密的 27B 解码 27 词元/秒、一轮写 1,611 个词元、要 55.7 秒,首字要等 13.8 秒。两边总产出几乎一样(19.7 万 vs 19.3 万词元),花掉的时间却是 29 分钟对 99 分钟。
还有一个数字值得单拎出来:这两个模型的提示词中位分别是 4.8 万和 10.1 万词元。这不是我在写长文章,是代理循环里每一轮都要把历史和工具结果重新带上。前面第二层算过一笔账——读历史几乎不要钱,写才是全部成本;这份账本是那笔账的实物证据。
四个成品,和它们各自的代价
同一段时间里,我用它做了四个能直接在浏览器里打开的东西。把账本按时间窗对齐,每个成品花了多少一清二楚:
| 成品 | 模型 | 请求数 | 生成词元 | 墙钟 | 结果 |
|---|---|---|---|---|---|
| 城市脉搏(3D 交通模拟) | 35B-A3B | 5 | 15,852 | 1.9 分钟 | 1,350 行 / JS 772 行 |
| 霓虹城:最后一单 | 27B | 23 | 86,802 | 42.6 分钟 | 1,567 行 / JS 1,333 行 |
| 六十秒后重启(第一人称逃生) | 27B | 32 | 72,576 | 37.2 分钟 | 1,361 行 / JS 1,101 行 |
| 浮岛求生(重做那次) | 35B-A3B | 36 | 12,794 | 3.9 分钟 | 213 行 / JS 0 行 |
成品在 ~/Downloads/方寸智匣/系统输出/归档程序/。行数取
wc -l;JS 行取内联<script>里去掉空行与纯注释行之后的有效代码行数
**最后一行才是这篇文章的主题。**那次跑了 36 个请求、写了 1.2 万词元、花掉近 4 分钟,产出的 HTML 有 213 行:主菜单、世界种子输入框、操作说明、暂停界面、失败界面、受伤闪烁——外壳一样不缺。而内联脚本里的有效代码是 0 行。
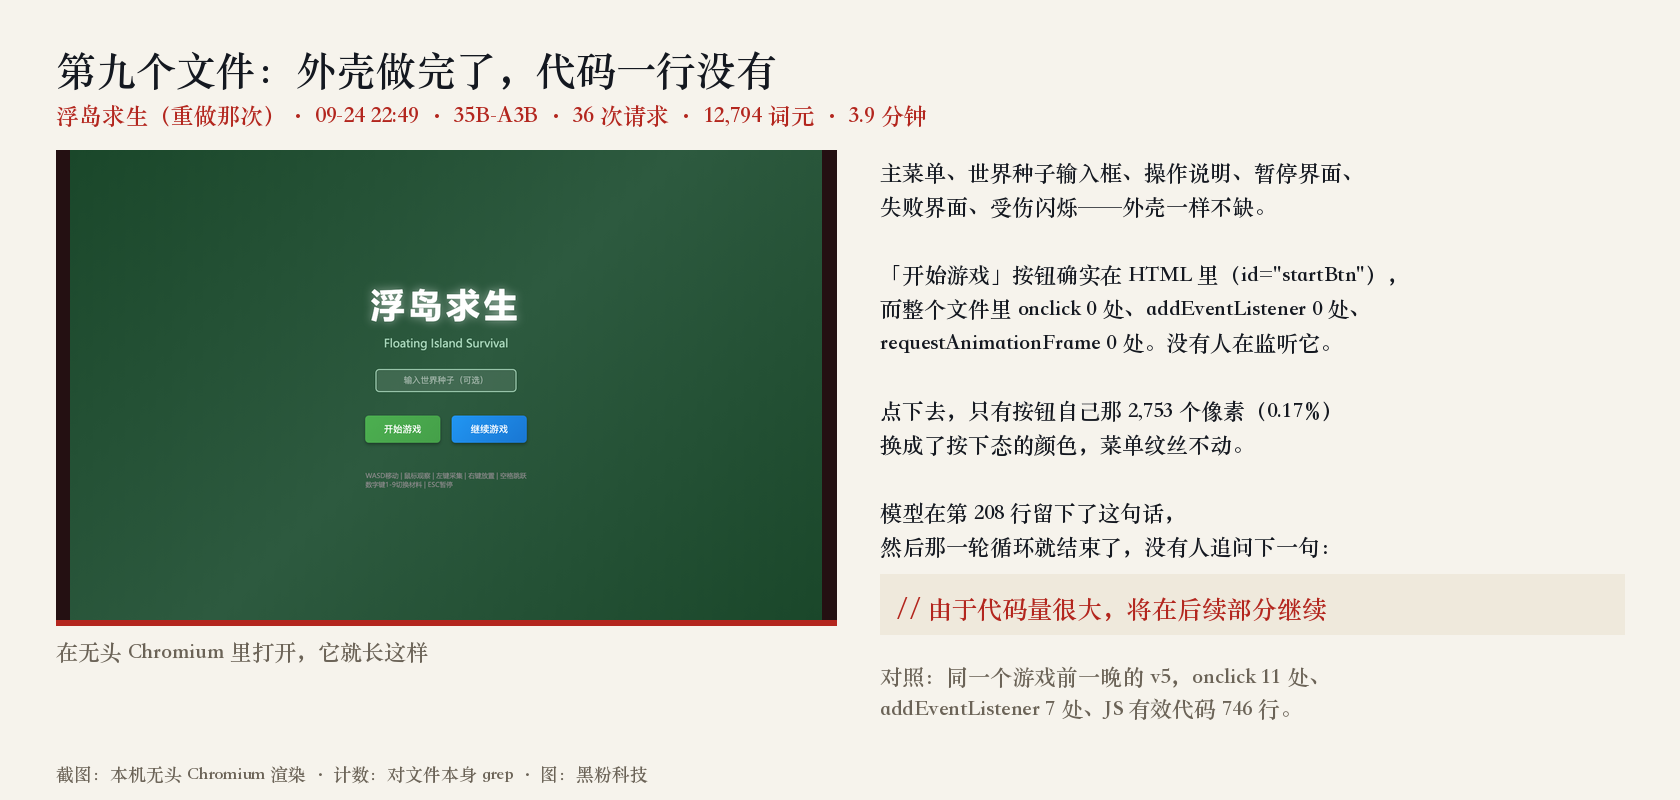
这不是「模型写崩了」。模型在文件第 208 行留下了这句话——// 由于代码量很大,将在后续部分继续——把活推迟到了下一轮。然后那一轮循环就结束了,没有任何人追问这个「后续」有没有兑现。它不是没能力,是没人接住它这句话。
对照同一个游戏前一晚的版本:911 行、JS 有效代码 746 行、onclick 11 处、addEventListener 7 处、requestAnimationFrame 5 处。空壳这边后三项全是 0——连一个事件监听都没有,「开始游戏」按钮(id="startBtn")在 HTML 里孤零零地待着。我在无头 Chromium 里真点了它:全图只有 2,753 个像素变色(占 0.17%),位置正好是按钮自己那个矩形,那是 CSS 的按下态。菜单纹丝不动。
警告 顺带一个量错就会判反的坑,我自己先踩了。最初我拿「JS 函数个数」当判据,空壳是 0,看着很干净——可城市脉搏那个能跑的 3D 模拟,
function关键字也是 0(它整篇用 class 加箭头函数写)。按那把尺子,能跑的和空壳并列。换成「内联脚本里的有效代码行数」才把两者分开:0 对 772。判据的粒度不对,好的坏的都会判反——这篇文章里我已经栽过两次了。
对照着看 3D 交通模拟那一行会更清楚:**5 个请求、1.9 分钟,出了 1,350 行。**同一个模型、同一台机器,差别只在任务本身收不收得住口。
本地部署到底被什么卡住:一条从硬件到参数的完整链
前面几节是一次次撞出来的。这一节把它们排成顺序——从买得起的硬件,到最后能不能 写完一个文件。全部数字来自本机(M5 Pro / 64 GB 统一内存)实测,样本是 180 条 真实请求,不是厂商标称也不是推算。
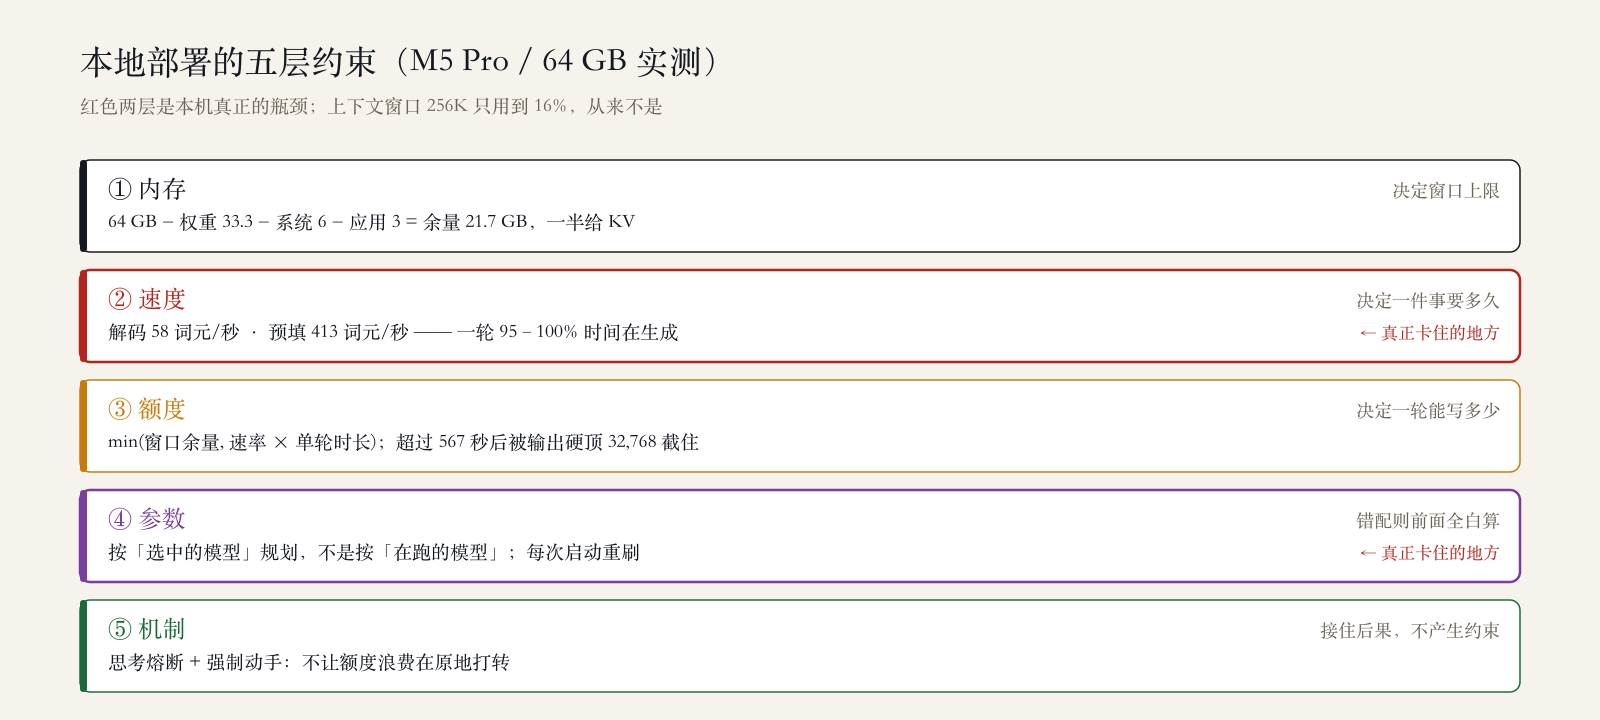
第一层:内存决定你能装下什么
统一内存要同时装权重、KV 缓存和计算缓冲。这套软件的分账方式是:
可用余量 = 总内存 − 常驻权重 − 系统预留 − 应用预留
系统预留 = 总内存 × 12%,夹在 3–6 GB
应用预留 = 总内存 × 6%,夹在 1–3 GB
本机跑 27B(常驻 33.3 GB)时:64 − 33.3 − 6 − 3 = 21.7 GB。
余量里只有一半划给 KV 缓存(剩下一半留给计算缓冲、常驻量估算误差和运行期 波动)。10.85 GB,按 q8_0 量化每词元约 139 KB 算,够开 81,920 词元的窗口。
这是硬约束,但不是本文这台机器的瓶颈——因为跑 Splash 时它自己管内存, 直接给到模型的原生 256K。二十五次启动,二十五次都是 256K,从不随内存伸缩。
一句话:内存决定窗口上限,但窗口很少是真正卡住你的那个。
第二层:速度决定一件事要多久
这是最容易被忽略、也最难绕开的一层。
| 指标 | 实测中位 | 波动范围 |
|---|---|---|
| 解码(写) | 58 词元/秒 | 8.7 – 100.9 |
| 预填(读) | 413 词元/秒 | — |
| 缓存命中率 | 96% | 20% 的请求低于 50% |
两个数字合起来,答案就出来了:预填比解码快七倍。
我一度以为长对话的成本在"每轮都要重读历史"。拆开一轮的实际耗时,这个想法被 直接推翻:
提示词  9,976 · 输出 32,768 → 预填  0.3 秒 + 生成 681 秒   生成占 100%
提示词 34,419 · 输出 32,000 → 预填  3.3 秒 + 生成 944 秒   生成占 100%
提示词  9,899 · 输出 19,866 → 预填 19.2 秒 + 生成 383 秒   生成占  95%
一轮的时间有 95% 到 100% 花在生成上。 读历史几乎不要钱(何况九成六命中缓存), 写东西才是全部成本。
于是有了这条谁也绕不开的下限:一份四百行的单文件网页约 15,000 词元, 光生成就要 260 秒。 不是"优化一下能到三十秒",是物理上就得四分多钟。
第三层:额度是时间和窗口里更小的那个
每一轮模型能写多少,取一个最小值:
本轮额度 = min(窗口还剩多少, 这一轮的时间买得起多少)
时间那一项 = 实测生成速率 × 单轮时长上限
本机 58 词元/秒时:
| 单轮时长 | 时间额度 | 实际发生 |
|---|---|---|
| 180 秒 | 约 10,400 | 写不完一个文件,靠后续轮次打补丁 |
| 600 秒 | 约 34,800 | 被输出硬顶 32,768 截住 |
超过约 567 秒(32,768 ÷ 58),卡住的就从时间变成输出硬顶。 所以"单轮时长设得越大越好"是错的——600 秒之后再加,一个词元都换不来。
实测也印证:600 秒那组最长的一轮用了 374 秒,还剩 226 秒没用上; 其余五轮只用 32 到 127 秒。时间在那时已经不是约束了。
第四层:参数错配——最笨也最贵的一层
上面那些是物理和算术,改不动也绕不开。这一项是配置,而它造成的损失比它们加起来都大。
预算是按界面里选中的模型规划的,不是按实际在跑的模型。选中一个 4B 的小 模型、实际跑 27B,预算就按 4B 给:单次输出 6,144、上下文 24,576。更麻烦的是 自动优化每次启动都重新盖一遍,手工改大过也留不住。
代价是前面那张对照表:同一个模型、同一道题,参数错配时十一轮交不出; 配对之后六轮交付、自检全过。
第五层:机制——它不产生约束,它把约束的后果接住
把同一个模型、同一道题交给一套没有收敛机制的调度框架,额度给到 32,768、 时间给够 843 秒,结果是零产物:十万字节输出从头到尾没离开推理。
本文这套多两道闸——一轮只思考零产出就中途掐断、连续无产物就关掉思考并强制 调用工具——同样的模型交付了四百行、十二项交互检查全过。
机制不让模型变强,它只保证模型不把额度浪费在原地打转上。
汇总:哪些能调,哪些调了没用
| 约束 | 本机实测值 | 可调性 |
|---|---|---|
| 统一内存总量 | 64 GB | 换机器 |
| 常驻权重 | 27B 占 33.3 GB | 换模型 |
| 上下文窗口 | Splash 固定给满 256K | 不可调,也不必调(实际最多用到 16%) |
| 生成速度 | 58 词元/秒 | 换更小的模型;或验证推测解码的真实增益 |
| 单轮时长 | 600 秒 | 可调,但 567 秒以上无效 |
| 单次输出硬顶 | 32,768 | 可调,本机用不满 |
| 选中模型与实跑一致 | —— | 必须一致,否则前面全白调 |
| 收敛闸门 | 默认全开 | 建议不动 |
如果只能记一条:先确认界面里选中的模型就是你实际在跑的那个。 这一条错了,后面每一项调整都会被下一次启动抹掉。
谁在这件事上赚,谁在赔
谁受益:卖硬件的。「换更大的模型」这句话可以直接翻译成内存需求。 还有按调用量计费的云端服务——本地跑不顺,用户自然回到云上。
谁受损:用户的时间。同一道贪吃蛇,关掉两个开关多花 16 分钟; 而调参本身的时间成本更大,大部分花在分辨噪声上。这笔钱不进任何人的账,纯蒸发。
谁在沉默:模型发布方没有动机告诉你「这个模型需要一层外部收敛机制才好用」, 那听起来像是模型不够好。所以公开榜单上全是单轮能力分,几乎没有「多轮任务完成率」 和「完成一个任务平均要几轮」。沉默方的立场就是结论:榜单的形状决定了大家优化什么。
这也解释了为什么厂商愿意公布解码速度而不公布完成率。9 月 20 日我撞过一次: 三值量化的 27B 解码快 2~3 倍、原子探针四项全过,真实长任务却超时交不出; 同题的 Q8 27B 用 31 分钟交付了。速度好测,完成率难测,于是只有速度被测。
回到那 64 分钟
开头那个进度条,现在会在静默 120 秒后停下,并明确说出「是这条连接不再出数据, 既不是额度也不是时间」。这是这轮改动里我最满意的一处——不是因为它复杂, 而是因为它把一个「看起来像模型慢」的现象还原成了它本来的样子。
给想上手的人三条路径:
只想跑通:两个开关保持默认打开,别动数值阈值,单轮时长留 180 秒。 Qwen3.8-27B-Splash 在 32GB 以上的 Apple Silicon 上,四道构建题都能交付。
想调参:先量你自己机器的噪声。同一道题同一套参数跑三次,把跨度记下来。 比这个跨度小的差异,别当结论。
想排障:卡住时先看是不是流静默——服务端日志说 Done 而界面还在转, 就是这个病,跟模型没关系。
我自己也在那份沉默里。写这篇之前,我一直以为这套闸门的问题是「阈值定得不够好」。 逐项核对之后才明白,真正的问题一次都不在阈值上。
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
把 Mac 变成私有 AI 盒子:本地转写、配音、生图、视频和 MCP 工具一站管理。
本轮公开 Apple Silicon Mac 安装包。聊天模型现在可通过同一代理按需调用已集成的语音、转写、图像、图片编辑、音乐和视频工具,并把实际产物交给下一项工具继续处理。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
在 AI 面板打开「制作动画」,输入讲解及自己的要求,从三组19种风格方法中选择。模型结合当前内容设计主体、动作与镜头,生成可编辑的原生动画图层和关键帧。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取

留言
正在加载留言…