Embedding相似就答对了?3个词、一个向量空间和知识库的误会
猫和狗像,猫和内阁不像。把这种直觉放进数字里,词语就有了距离;可“允许商用”和“不允许商用”也可能挨得很近。相关资料,不等于正确答案。
阅读全文第 2 / 5 页 · 每页 21 篇。 精彩依旧继续,我们等待着您。
返回首页 →猫和狗像,猫和内阁不像。把这种直觉放进数字里,词语就有了距离;可“允许商用”和“不允许商用”也可能挨得很近。相关资料,不等于正确答案。
阅读全文
普通人能在自己电脑上运行AI,并不是从天上掉下来的福利。分阶段发布、研究许可、开放引擎与下载链接,把同一场技术竞争分成了两条跑道。
阅读全文
一站一站传话,和随时查找前文,是两种不同的组织方式。2017年的论文改变了语言模型,但它没有送给机器一份永不遗忘的记忆。
阅读全文
录完直接剪,一句话交给 AI:28 分钟原始录屏剪掉 8 分钟,导出前的体检查出没打码的密钥;368 个原生动画,17 个平台的关注卡在动画里切。没做到的也写在里面。
阅读全文
LocalBrain 1.4.8 接进第二个本地视频引擎 LTX-2.5:写一句带引号的台词,画面里的人会说出来。64GB 的 M5 Pro 上 4 秒 1024×576 约 2 分钟、峰值 25GB,运行时默认参数本来要 54GB;43.4GB 权重国内经 ModelScope 直连,发现页一键下载。
阅读全文
同样是 AI 电脑,Mac 买共享内存和低维护,Windows 买兼容与显卡选择,Linux 买生产栈;加入 9 月 28 日官方现货价后,答案更具体。
阅读全文
31 GiB 权重,M5 Pro 上 20 步 69 秒;中文书法写对四字。接入 LocalBrain 踩中三处陷阱;第二轮换人像重测官方那三条,发现「商品保真」其实是道尺寸题。
阅读全文
Splash 在我的 M5 Pro 上把 Qwen3.8-27B 的代码生成跑到 79.3 tok/s,比同权重的朴素 MLX 快 5.11 倍;换成中文写稿只剩 1.44 倍。差别不在引擎,在草稿模型的接受率——代码 63.2%,中文 11.9%。
阅读全文
PrismML 把 27B reasoning 压到 5.93 GB、M5 Pro 跑出 27.7 tok/s,还留 98.2% 的 Qwen3.8 原始能力。两条部署路径的命令、踩坑和接下来在 LocalBrain 里实测的计划,一次写清楚。
阅读全文
录屏最怕的不是没录好,是录到了不该录的。黑粉录屏 1.0.2 正式版:本机识别敏感信息、打码跟着放大和滚动走,导出后回读成片做体检;录制和缓存放哪自己定。附实机截图的完整功能介绍。
阅读全文
用本地 Qwen3.8-27B 通过 blender-mcp 建模的方法,再在 LocalBrain 里实测五轮:模型能一步步动手,但慢;交付的黑图只差一个勾选,看不见时它当成完成,能看最终渲染图以后才用对了修法。
阅读全文
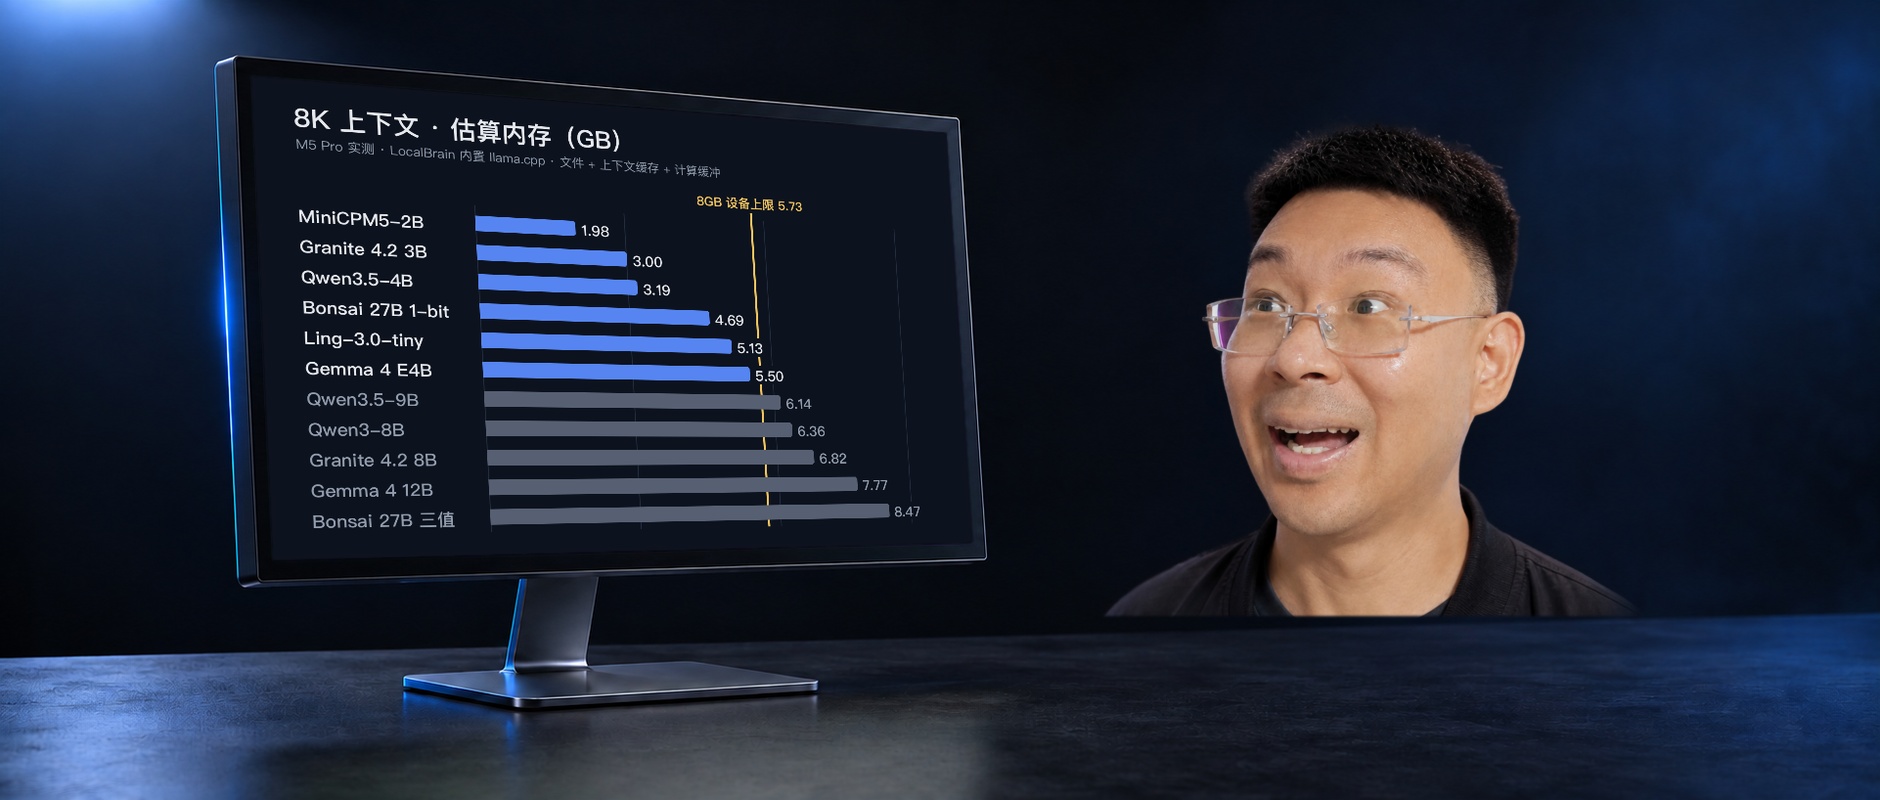
把今年发布的 11 个低内存本地模型下到本机,用 LocalBrain 内置的 llama.cpp 统一量内存、速度和工具调用:8K 上下文下 6 个压在 8GB 设备的默认上限内,Qwen3.5-9B 比去年的 Qwen3-8B 少占 3 GB,1-bit 的 27B 能跑但质量只有厂商数字。这批模型也加进了 LocalBrain 的发现页。
阅读全文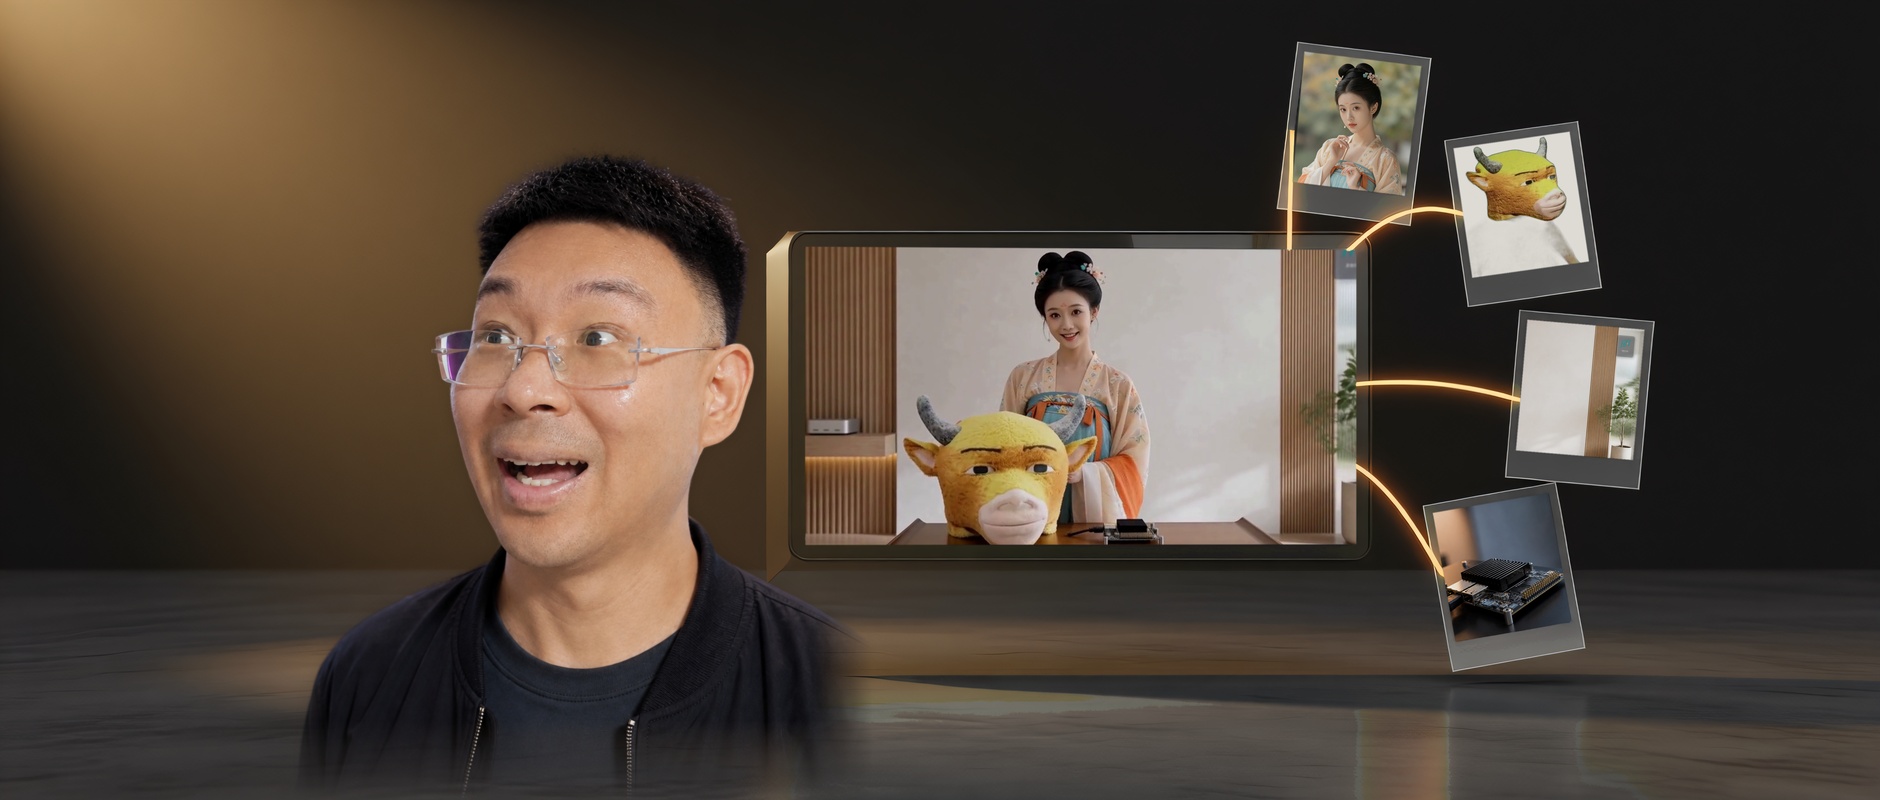
LocalBrain 1.2.65 能在本机跑 MiniMax H3 的多参考图版(REF2VA),一次最多 9 张图。我在 64 GB 的 M5 Pro 上用 0、1、2、4 张参考图各生成一条 960×544 的 3 秒视频,把耗时、内存、被照搬的细节和 Turbo 不能开的原因原样摆出来。
阅读全文
64GB Mac 上的 Qwen3.8-Flash-Next 连跑五道离线网页难题:1 题交付、3 题可运行、1 题放弃。每次超时、崩溃和长上下文失速,最终都变成了 LocalBrain 的通用修复。
阅读全文
llama.cpp 0.4 用懒加载、流式量化和 Apple RDMA 改写了大模型的内存边界。但 LocalBrain 的 64GB Mac 记录证明:文件大于内存可以启动,不等于长上下文也能满速跑。
阅读全文
MiniCPM5-2B 把 13 万上下文、Agent 训练和官方 GGUF/MLX 一起塞进 2.52B 参数;真正的看点不是越级跑分,而是它有没有资格成为本地软件里的常驻执行器。
阅读全文