
想在生成过程中继续添加物体、改变场景,再让镜头按指定路线移动,过去往往要重新生成或拼接多个片段。腾讯 Hy-Nomas 要解决的问题,是让同一个视频世界随着文字和镜头指令连续发展。
目前最值得关注的不是一张演示图,而是两个已经落地的入口:Hy-Nomas 官方模型页已经列出模型资产与离线推理说明,同时提供面向单张 NVIDIA GeForce RTX 4090 的配置。不过,“单卡支持”只代表官方给出了一条运行路径,不代表普通显卡都能跑,也不代表生成速度已经得到独立验证。
它生成的不是一段封死的视频
Hy-Nomas 按片段生成世界。每一轮都可以继续输入主体、动作、外观、风格和环境变化,也可以提供相机轨迹,改变观察位置与移动方式。官方将这种能力称为自由形式、多轮交互。
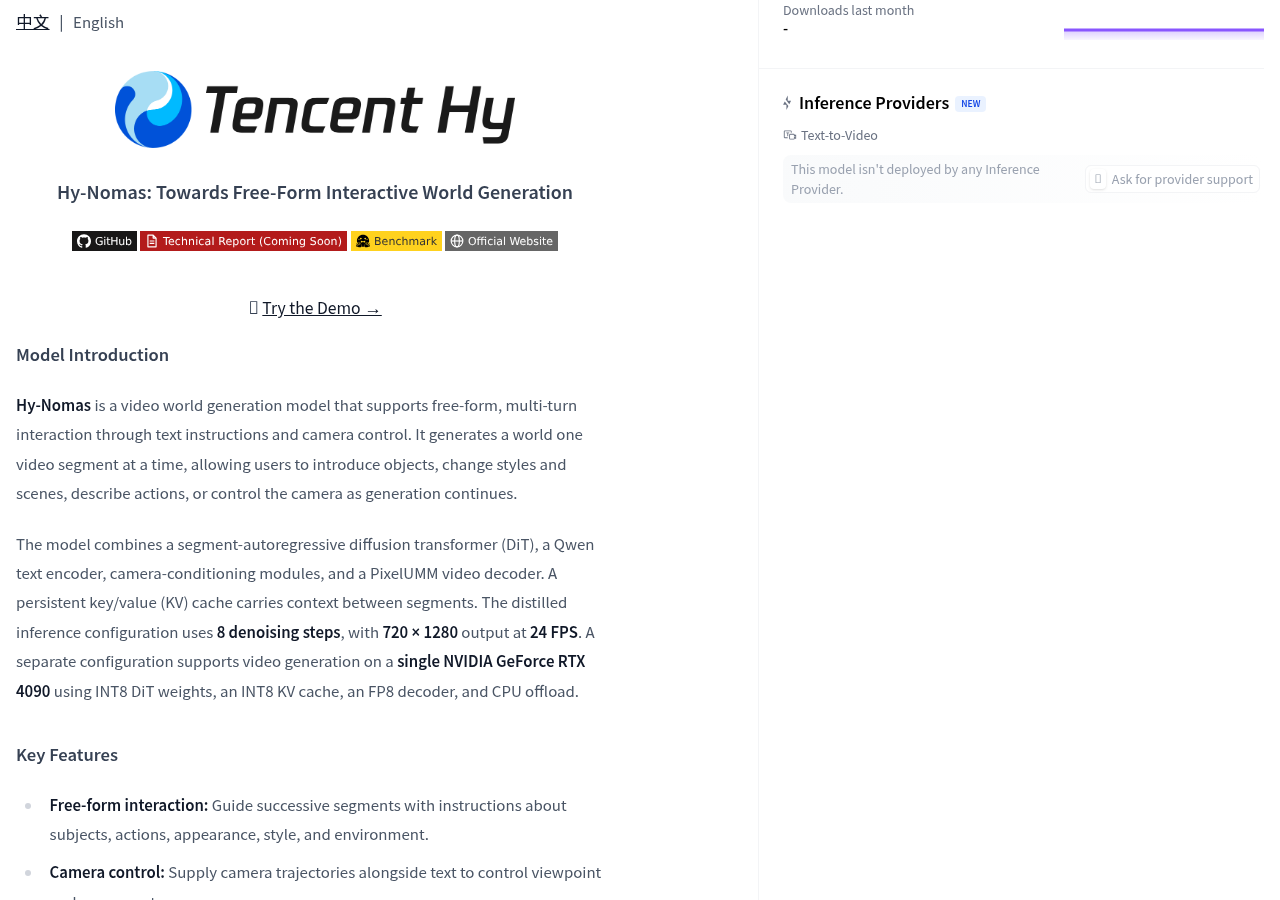
可以把它理解成微信里持续进行的一段对话:后发的消息不是另开一个聊天窗口,而是接着前面的上下文继续说。Hy-Nomas 也是一段一段往后生成,并通过 KV 缓存保留此前片段的上下文。这个类比只解释“怎样接着生成”;模型并不因此真正理解一个世界,其连续性仍受缓存、提示和生成误差影响。
- 文字可以在后续片段中加入物体、动作或场景变化。
- 相机轨迹可以与文字条件一起控制视角和运动。
- 同一世界可以继续扩展,不必每次从完全空白的状态开始。
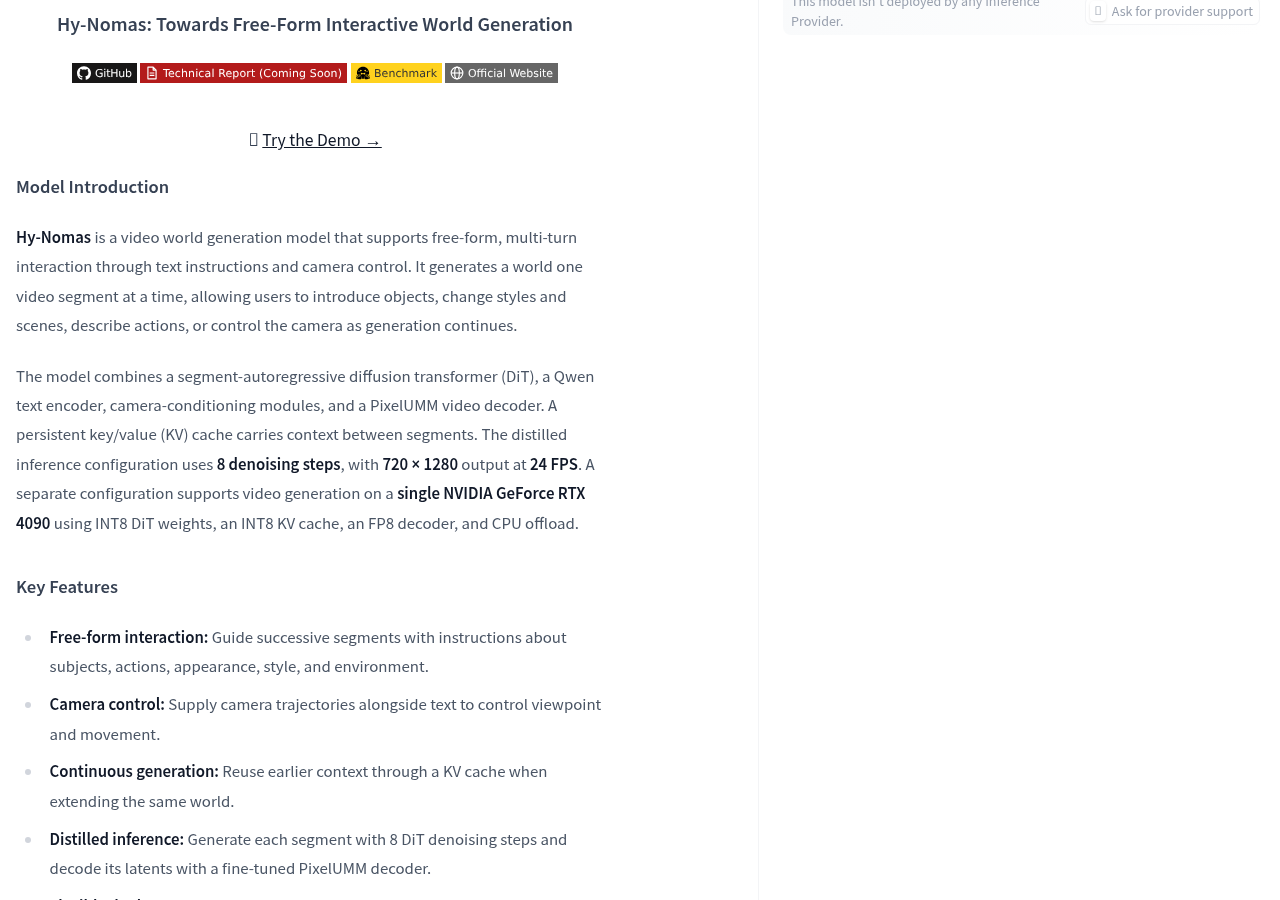
- 蒸馏推理配置使用 8 个 DiT 去噪步骤,默认输出为 720 × 1280、24 FPS。
权重已经列出,但“开放”不等于“一键运行”
官方模型页已经列出蒸馏 DiT、INT8 量化 DiT、基础自回归 DiT、DCAE-V、PixelUMM 解码器及其 FP8 版本等资产,并说明应保留仓库中的 DiT、VAE 和 PE 目录结构。标准离线推理还需要匹配的 PixelUMM 检查点和 Qwen/Qwen2.5-VL-7B-Instruct 文本编码器。
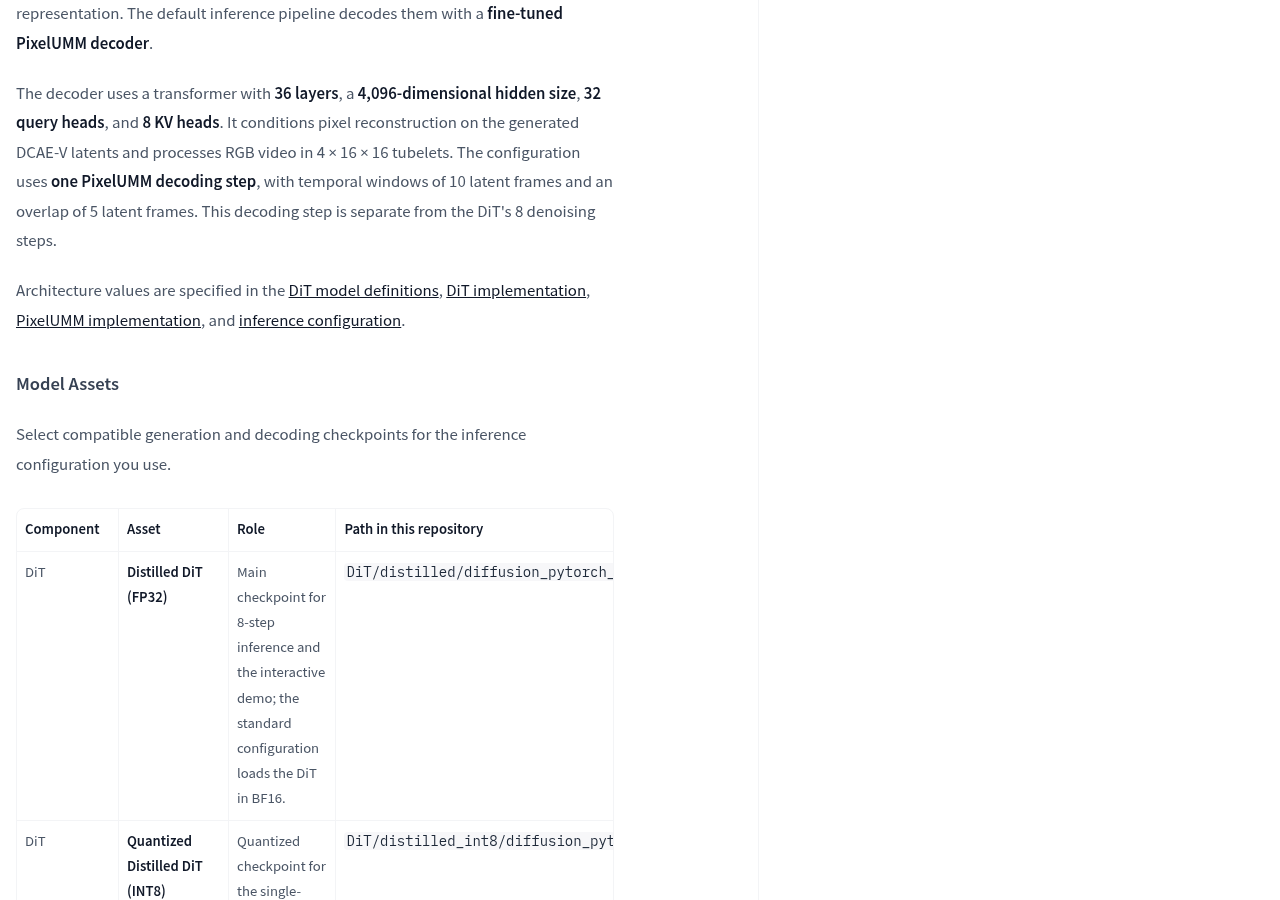
模型采用 Apache License 2.0,但第三方模型与组件仍受各自许可证约束。因此,能够下载 Hy-Nomas 文件,只解决了“文件是否开放”这一层;许可证、运行环境、配套组件和硬件是否合适,仍要分别检查。
标准方案和单卡方案不是同一套成本
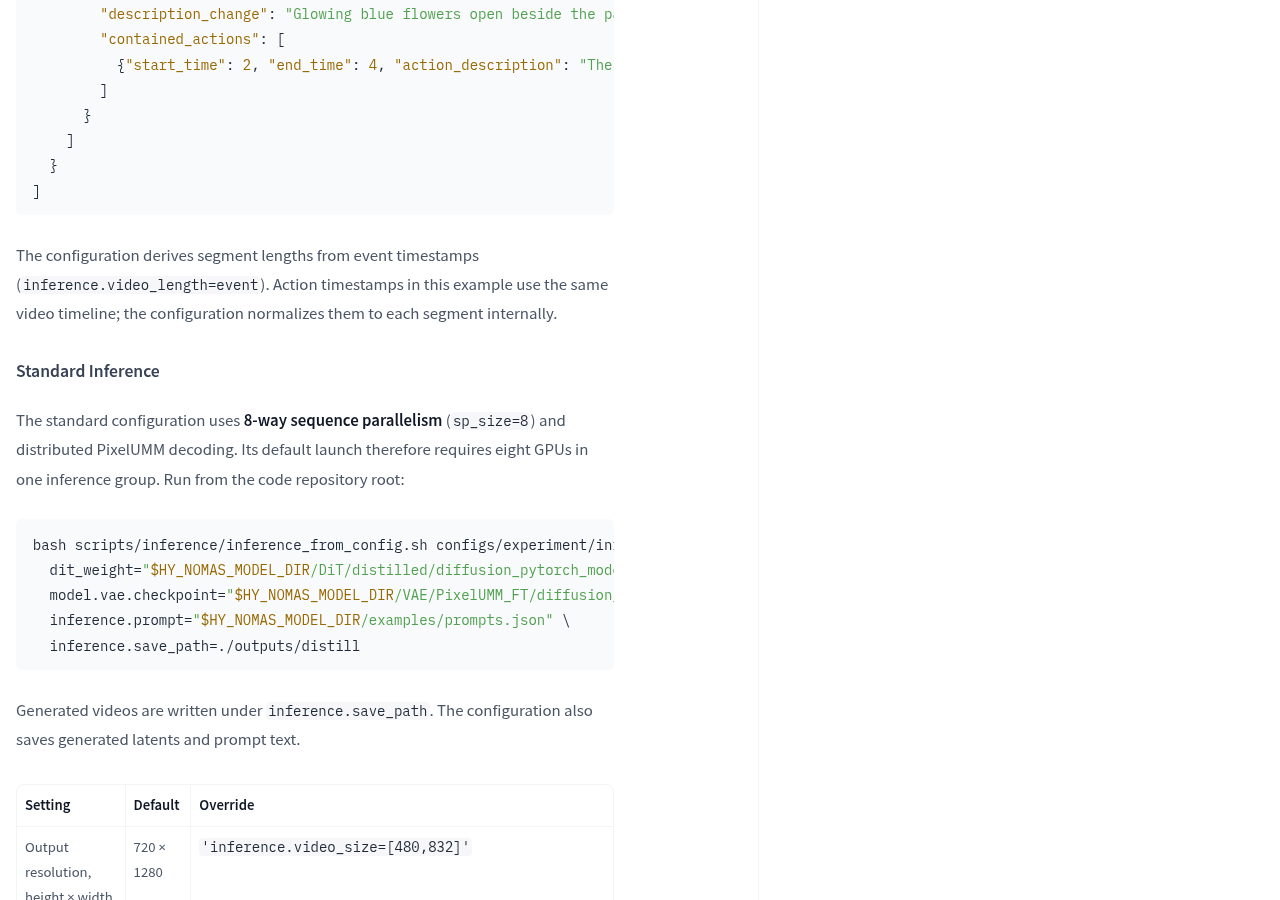
标准配置使用 8 路序列并行和分布式 PixelUMM 解码,默认需要同一个推理组中的八张 GPU。官方推荐使用预打包 Docker 环境;手动安装则要求 Linux、Python 3.12 以上、CUDA 13.0、C++ 编译器,以及对应的 PyTorch 和注意力内核。
单卡配置面向一张 NVIDIA GeForce RTX 4090:DiT 权重和 KV 存储使用 INT8,解码器使用 FP8,并把文本编码器、DiT 和解码器按处理阶段在 CPU 与 GPU 之间转移。它把序列并行改为 sp_size=1,同时保留 720 × 1280、24 FPS 和 8 步 DiT 去噪等默认设置。
| 项目 | 标准配置 | 单张 RTX 4090 配置 |
|---|---|---|
| 并行方式 | 8 路序列并行 | sp_size=1 |
| DiT 检查点 | 蒸馏 DiT,标准配置以 BF16 加载 | INT8 量化蒸馏 DiT |
| 视频解码器 | 匹配的 PixelUMM 检查点 | FP8 PixelUMM |
| 历史上下文 | 保留完整历史 | GPU 最多选择 18 个历史潜变量帧,更早历史归档到 CPU |
| 额外代价 | 需要八张 GPU 组成推理组 | 依赖 CPU 卸载,并增加 CPU 与 GPU 传输延迟 |
以上均为官方配置说明,不是独立性能横评。
警告 官方没有把“单张 RTX 4090”写成轻量运行。系统内存必须容纳被卸载的模型和持续增长的历史归档;峰值显存还会受分辨率、当前片段长度和所选配置影响。官方也明确指出,18 帧历史预算只限制历史上下文,并不限制当前片段占用。
KV 缓存让世界接得上,也会留下账单
KV 缓存可以类比快递站保存取件记录:新包裹到达时,系统可以查前面的记录,不必把所有信息重新登记一遍。Hy-Nomas 在生成下一段时复用此前片段的注意力键和值,让新片段参考已经生成的历史。
保存记录也要占空间。标准配置会保留完整历史,世界生成得越长,缓存内存就可能继续增加;单卡配置把活跃的 GPU 历史限制在一定范围内,但更早内容仍会归档到 CPU。这样降低了 GPU 侧压力,却不能消除系统内存增长和数据传输延迟。
在线演示、离线推理和评测套件要分开看
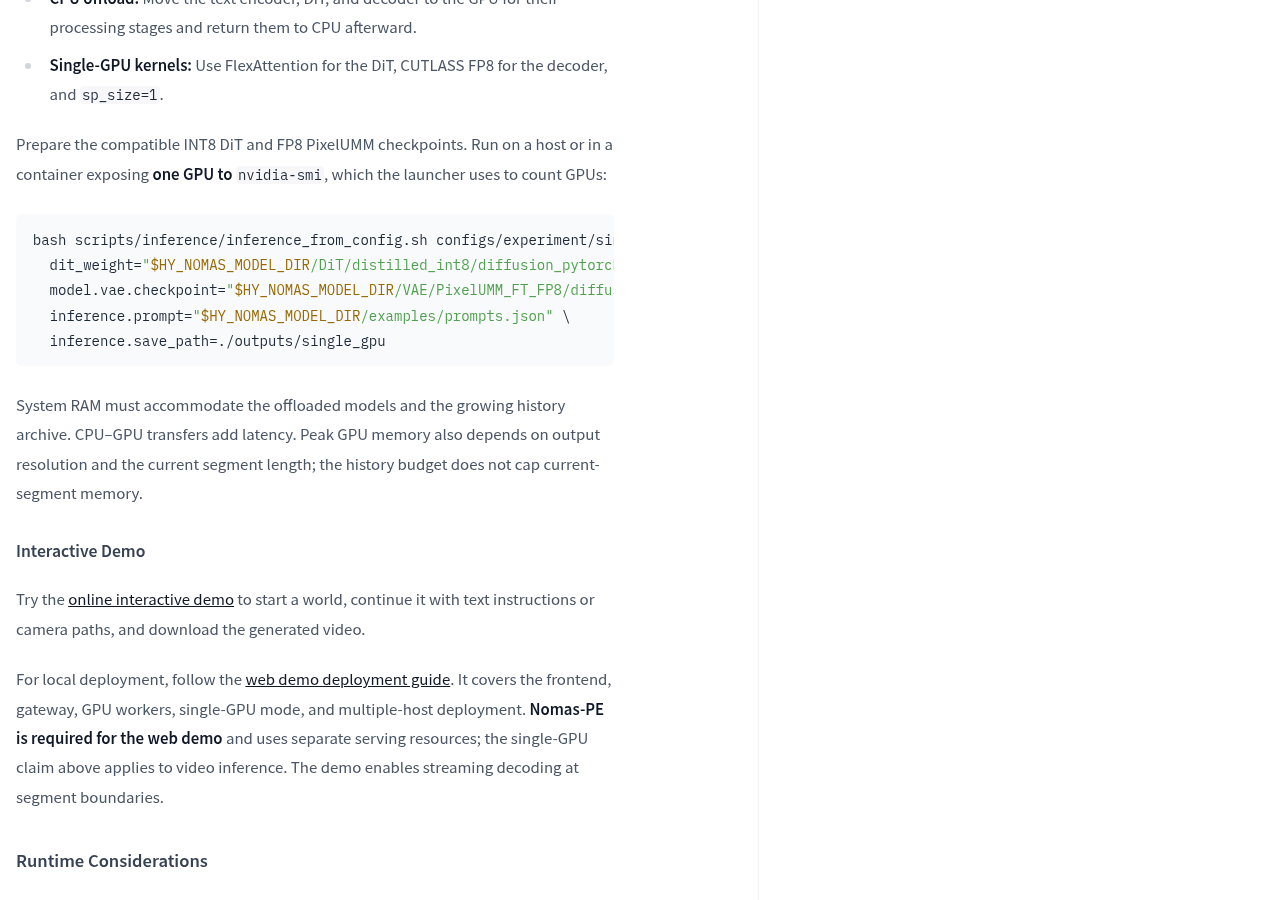
在线演示使用单独的 Nomas-PE 服务,把用户指令转换成结构化生成提示;离线推理可以直接读取准备好的提示文件。Nomas-PE 是网页演示所需的独立服务,因此,官方所说的单 GPU 视频推理不能直接扩大成“完整网页服务只需一张卡”。
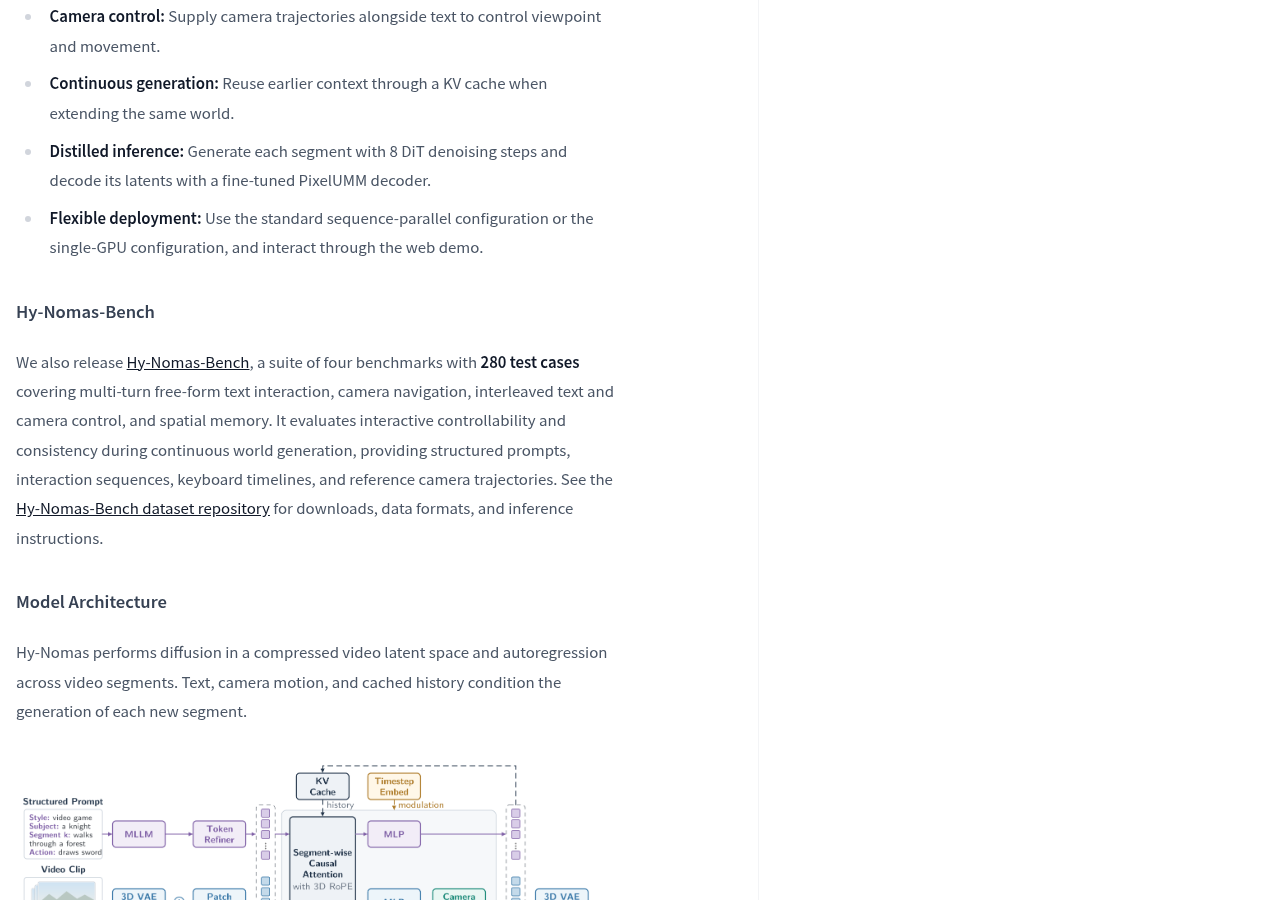
官方还发布了 Hy-Nomas-Bench,包含四套基准、280 个测试用例,覆盖多轮自由文本交互、相机导航、文字与相机交错控制以及空间记忆。当前材料说明了测试范围和数据结构,但没有提供可用于独立横评的成绩,因此不能据此推断它已经优于其他视频世界模型。
现在适合怎么选
- 只想先看交互形式:可以使用官方在线演示,观察连续片段、文字修改和镜头控制是否符合任务需要。
- 准备本地部署:先确认 Linux、NVIDIA 驱动、Docker 或 CUDA 13.0 环境、模型资产和 Qwen 文本编码器是否齐全。
- 只有一张 RTX 4090:使用官方单卡配置及匹配的 INT8 DiT、FP8 PixelUMM,不能把标准检查点随意混用。
- 需要长期生成:重点记录系统内存、峰值显存、单段耗时、历史增长和连续性变化;这些数据当前不能从配置说明直接推出。
- 使用 LoRA:官方说明 INT8 加载器不支持在推理时另行加载 LoRA,选单卡量化方案前要确认是否需要适配器。
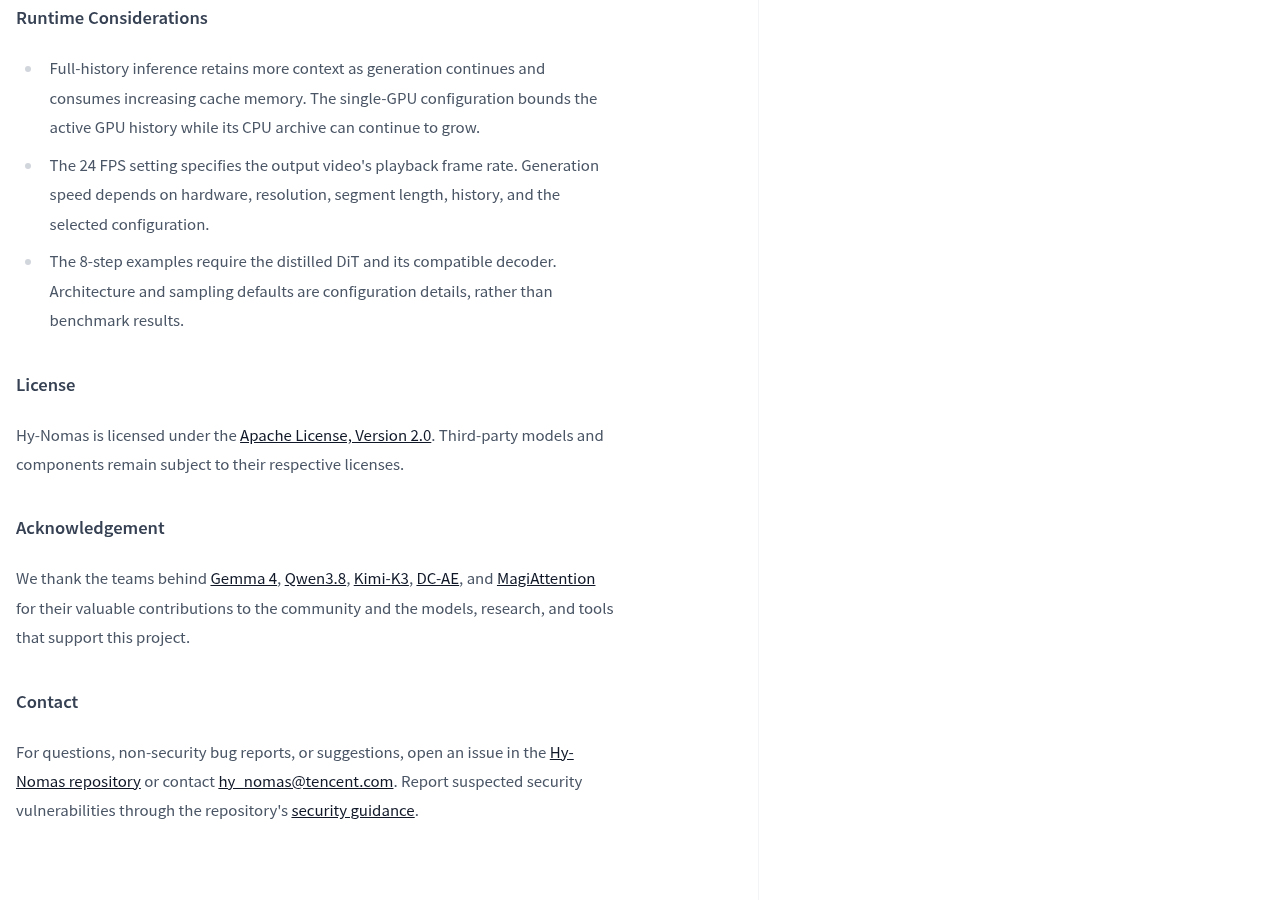
Hy-Nomas 已经跨过“只有概念演示、没有模型资产”的阶段,也给出了一条明确的 RTX 4090 推理路径。它更适合愿意处理 Linux、量化检查点、CPU 卸载和多组件依赖的使用者;如果期待普通电脑一键生成无限长世界,当前官方材料还不能支持这个判断。下一步真正有用的验收,不是再看一遍样片,而是在目标机器上记录能否启动、每段耗时、内存增长、镜头控制准确度,以及多轮修改后世界是否还能保持一致。
官方资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
本地 AI 工具箱:转写、配音、生图、视频和 MCP 工具集中管理;具体功能以对应平台版本为准。
压缩后保留你给出的原始约束:自动与手动压缩都在中文语义摘要之外,从官方追加日志保留可信的用户原文,按事件顺序核对目标、账户、参数与限制;网页内容、工具回执、宿主审查提示与旧摘要不能冒充你的要求。保留块不恢复授权、不构成待执行队列、不重放已执行工具;原文过长无法缩减时如实报告边界。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
本版先更新Apple芯片Mac;Windows与Linux继续提供1.6.6,包含各自的OpenH264编码修复,但不包含本轮紧凑界面。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取




留言
正在加载留言…