
腾讯混元官方模型列表新增 tencent/Hy-Memory-30B-A3B-GGUF,三档量化文件已经公开,最小的 Q4_K_M 只有 18.24 GB。它不是一个聊天模型,而是专门给长期记忆框架当“写入员”的模型:决定哪些对话值得留下、写成什么格式、旧记忆怎么更新。这篇文章只回答一个问题——你现在能不能把它跑在自己的机器上,以及跑起来之后它到底替你做什么。
它是什么:专门写记忆的模型
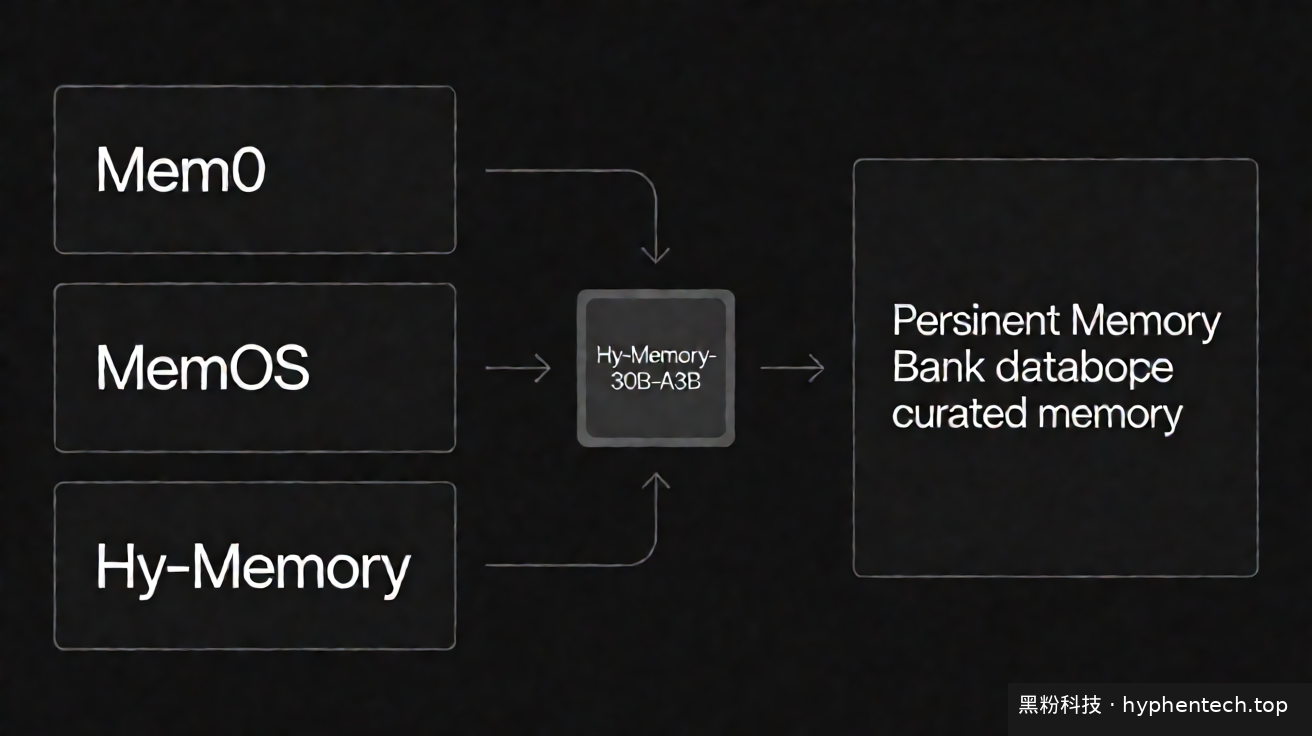
Hy-Memory-30B-A3B 是腾讯混元开发的紧凑型长期记忆写入模型,官方说明它直接替换 Mem0、MemOS 和 Hy-Memory 框架里的通用大模型,覆盖 Chat、Working、Coding 三种场景。你可以把它想象成快递分拣中心里专门负责贴面单的人:包裹(对话内容)进来,他决定哪件要进长期货架、面单上写什么、旧面单要不要撕掉重贴。总参数 30B,但每次激活大约 3B,相当于分拣中心很大,真正干活的只有一条流水线。
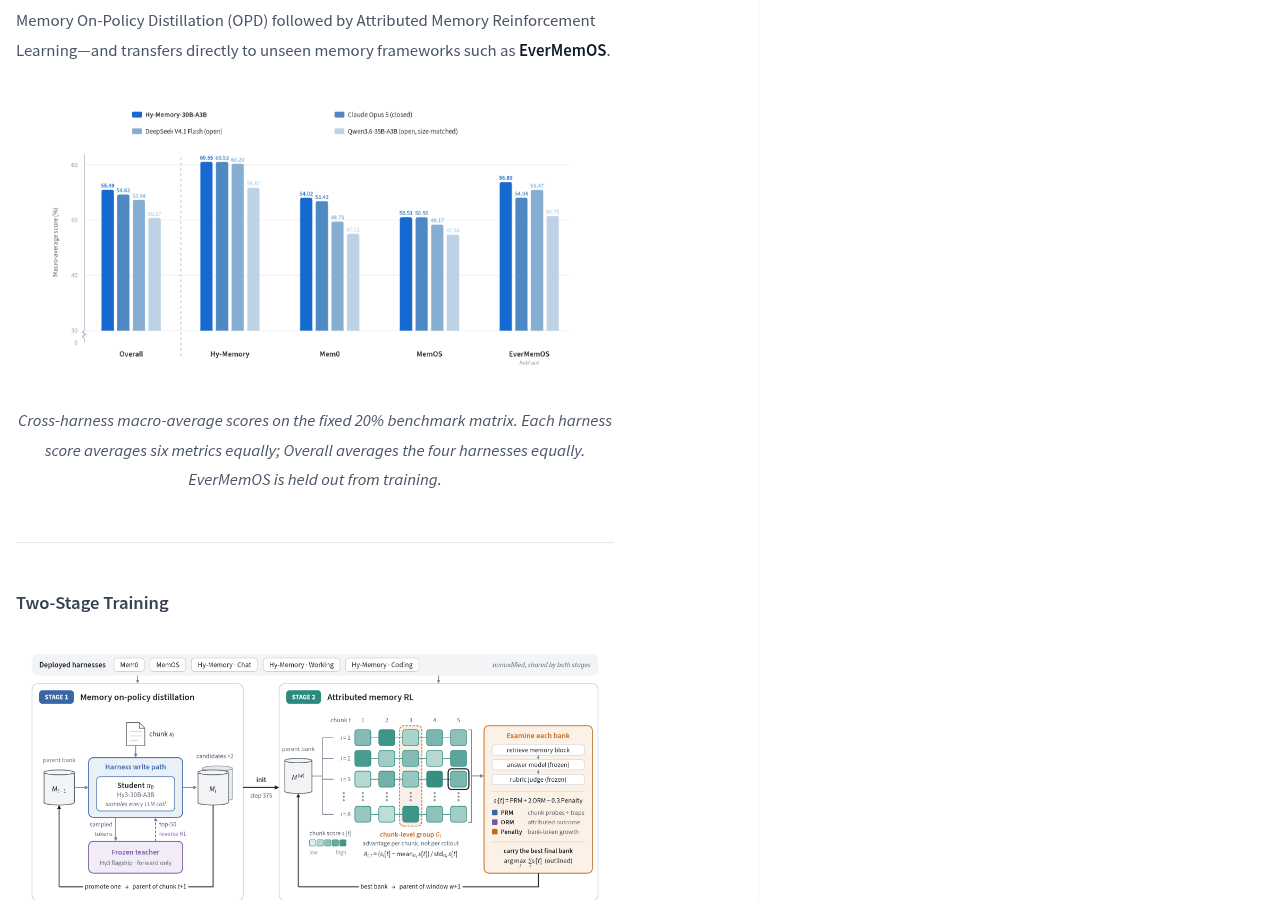
训练分两个阶段:先进行 Memory On-Policy Distillation,让模型在真实部署的框架配置里跟着教师信号学写状态链;再做 Attributed Memory Reinforcement Learning,按记忆块给分,把选好的记忆库带到下一个窗口。官方说这样训练出来的模型可以直接迁移到没见过的 EverMemOS 框架。
三档量化与官方成绩
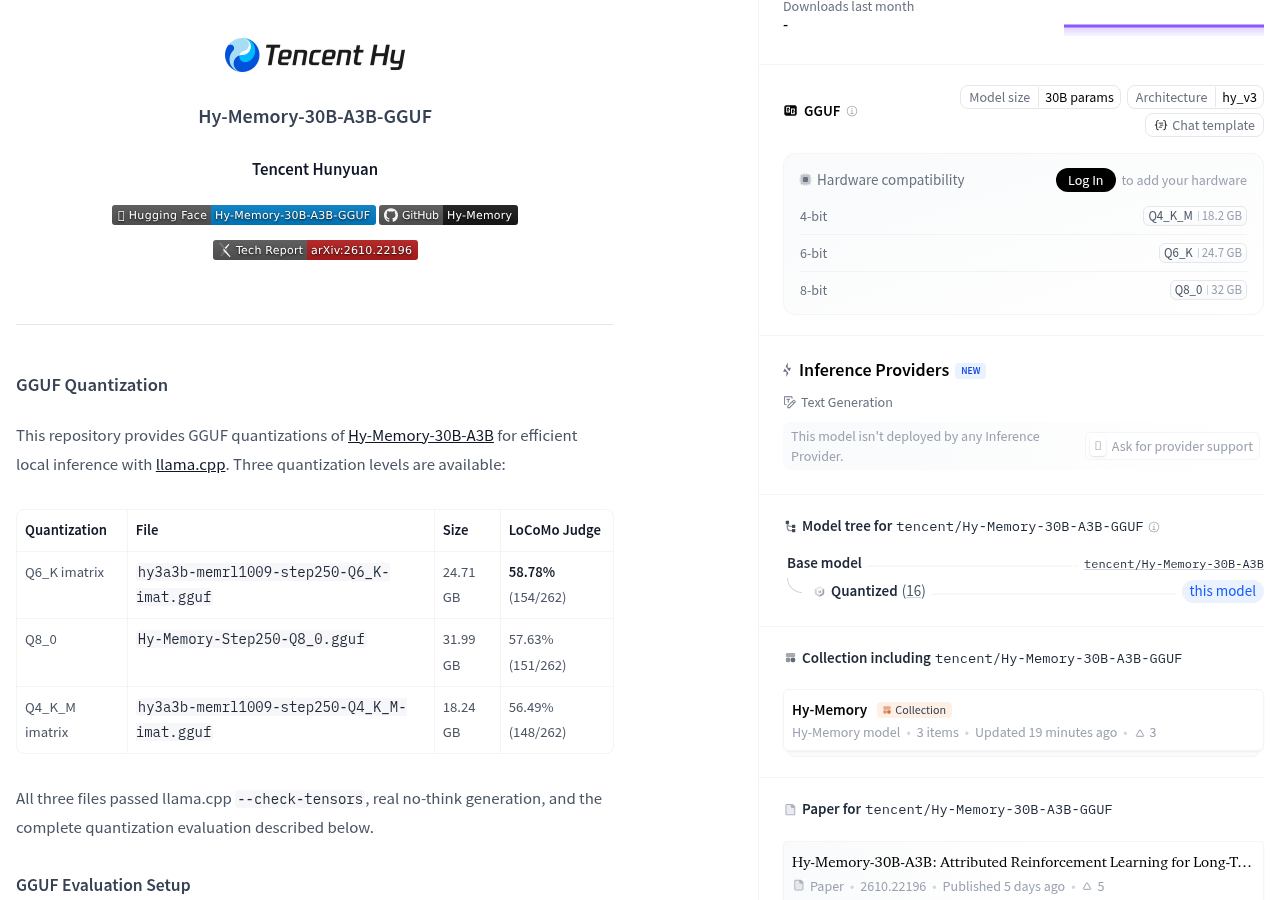
仓库提供三种 GGUF 量化,全部通过 llama.cpp --check-tensors、真实 no-think 生成和完整量化评测:
| 量化档位 | 文件名 | 体积 | LoCoMo Judge |
|---|---|---|---|
| Q6_K imatrix | hy3a3b-memrl1009-step250-Q6_K-imat.gguf | 24.71 GB | 58.78% (154/262) |
| Q8_0 | Hy-Memory-Step250-Q8_0.gguf | 31.99 GB | 57.63% (151/262) |
| Q4_K_M imatrix | hy3a3b-memrl1009-step250-Q4_K_M-imat.gguf | 18.24 GB | 56.49% (148/262) |
官方评测固定 20% LoCoMo 测试集,用 2 个用户、262 道题、59 个记忆块,检索 top_k=10,记忆温度 0.7,嵌入模型 qwen3-embedding-8b-for-online,裁判模型 gpt-5.6-sol,推理框架是官方 llama.cpp 指定 commit,KV cache 用 F16。Q6_K imatrix 是这次评测里质量最高的档位,Q4_K_M imatrix 则是下载和内存占用最小的档位。
官方跨框架成绩:能说明什么
官方在固定 20% 基准矩阵上做了跨框架对比,只换 memory writer,框架版本、提示词、检索配置、答案模型和裁判全部固定。六个指标等权平均,四个框架再等权平均:
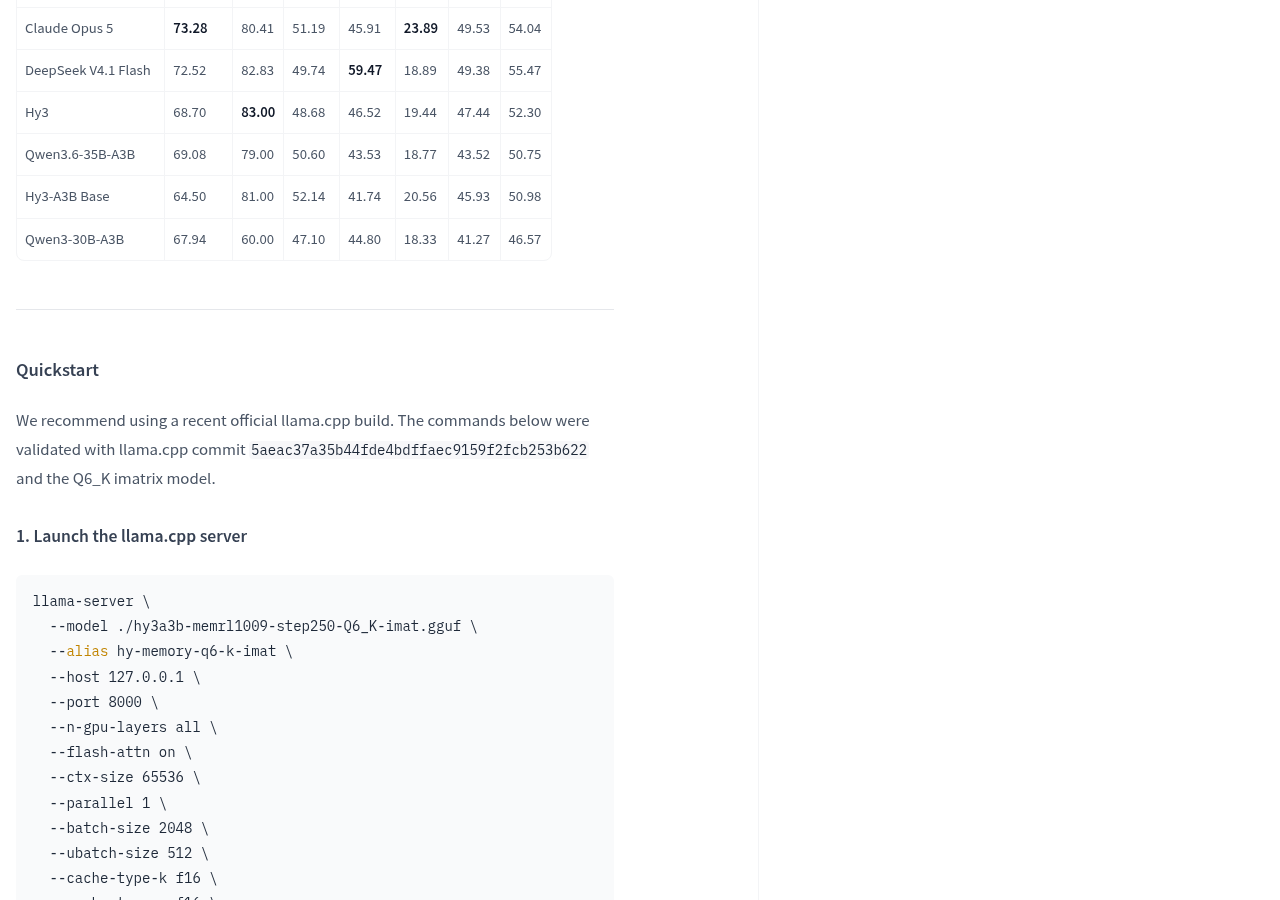
| Memory writer | Mem0 | Hy-Mem. | MemOS | EverMem. | Avg. |
|---|---|---|---|---|---|
| Hy-Memory-30B-A3B | 54.02 | 60.55 | 50.51 | 56.89 | 55.49 |
| Claude Opus 5 | 53.43 | 60.53 | 50.50 | 54.04 | 54.62 |
| DeepSeek V4.1 Flash | 49.73 | 60.20 | 49.17 | 55.47 | 53.64 |
| Hy3 | 45.99 | 58.06 | 50.19 | 52.30 | 51.63 |
| Qwen3.6-35B-A3B | 47.51 | 55.87 | 47.36 | 50.75 | 50.37 |
| Hy3-A3B Base | 40.20 | 50.39 | 49.05 | 50.98 | 47.66 |
| Qwen3-30B-A3B | 39.81 | 45.67 | 45.44 | 46.57 | 44.37 |
这些数字是官方报告的成绩,不是独立第三方复现。它能说明:在官方设定的条件下,Hy-Memory-30B-A3B 的平均分高于 Claude Opus 5 和 DeepSeek V4.1 Flash。它不能说明:在所有真实业务里都更好,也不能推出对手价格高低,更不能直接喊“最强”。
本地跑起来的最小路径
官方推荐用最近的 llama.cpp 正式构建,并给出在指定 commit 上验证过的启动命令。核心参数是 64K 上下文、单槽位、F16 KV 缓存、no-think 模式:
llama-server \
  --model ./hy3a3b-memrl1009-step250-Q6_K-imat.gguf \
  --alias hy-memory-q6-k-imat \
  --host 127.0.0.1 \
  --port 8000 \
  --n-gpu-layers all \
  --flash-attn on \
  --ctx-size 65536 \
  --parallel 1 \
  --batch-size 2048 \
  --ubatch-size 512 \
  --cache-type-k f16 \
  --cache-type-v f16 \
  --temp 0.7 \
  --top-k 0 \
  --top-p 1.0 \
  --repeat-penalty 1.0 \
  --jinja \
  --chat-template-kwargs '{"reasoning_effort":"no_think"}' \
  --check-tensors
如果想开两个并发槽位,官方要求把 --ctx-size 调到 131072,才能给每个请求保留最多 64K 上下文。启动后既可以用 OpenAI Python SDK 调用,也可以直接 curl 本机 8000 端口,请求里显式带上 reasoning_effort=no_think,方便审计。
现在能做什么,还不能做什么
- 现在就能从 Hugging Face 下载三档 GGUF,按官方命令用 llama.cpp 起服务,接入 Mem0、MemOS 或 Hy-Memory 当写入模型。
- 官方成绩显示它在固定基准上平均分高于 Claude Opus 5 和 DeepSeek V4.1 Flash,但这是官方口径,需要你自己在真实数据上复测。
- 权重文件开放下载,不等于你的电脑一定能跑:Q4_K_M 也要 18.24 GB,显存或内存不够就得降档或换设备。
- 它不是通用聊天模型,不要拿它当日常对话助手;它的价值只在长期记忆写入这一条流水线上。
- 下一步验收方法:用你自己的对话数据跑一遍记忆写入,检查它留下的记忆是否准确、更新是否及时,再决定是否替换现有框架里的通用模型。
相关资源:框架代码与评测工具在 GitHub 的 Tencent-Hunyuan/Hy-Memory,GGUF 权重与模型卡在 Hugging Face 的 tencent/Hy-Memory-30B-A3B-GGUF,原始 BF16 模型在 tencent/Hy-Memory-30B-A3B,技术报告编号 2610.22196。
官方资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
本地 AI 工具箱:转写、配音、生图、视频和 MCP 工具集中管理;具体功能以对应平台版本为准。
压缩后保留你给出的原始约束:自动与手动压缩都在中文语义摘要之外,从官方追加日志保留可信的用户原文,按事件顺序核对目标、账户、参数与限制;网页内容、工具回执、宿主审查提示与旧摘要不能冒充你的要求。保留块不恢复授权、不构成待执行队列、不重放已执行工具;原文过长无法缩减时如实报告边界。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
本版先更新Apple芯片Mac;Windows与Linux继续提供1.6.6,包含各自的OpenH264编码修复,但不包含本轮紧凑界面。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取




留言
正在加载留言…