
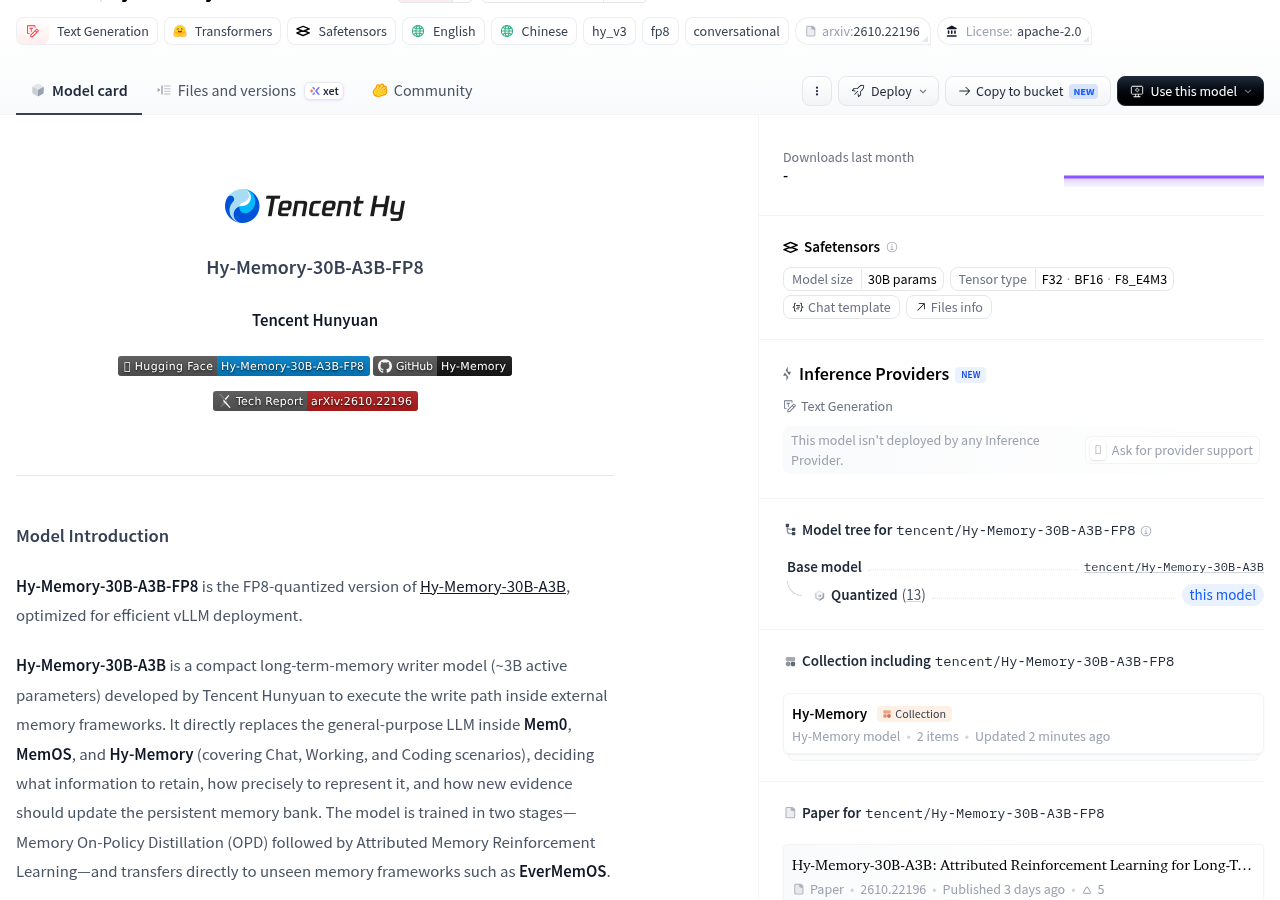
腾讯混元的 Hy-Memory-30B-A3B-FP8 权重、配置与模型卡已经出现在官方模型仓库。它是 Hy-Memory-30B-A3B 的 FP8 量化版本,官方把优化方向写得很具体:提高使用 vLLM 部署时的效率。模型页面没有给出明确发布日期,因此只能确认当前资源状态,不能把页面发现时间当成正式发布日期。
这也不是一款主要负责陪聊或直接回答问题的通用模型。它承担的是外部记忆框架里的“写入”环节:判断哪些信息值得留下、应该怎样准确表述,以及新证据出现后,旧记忆应当如何更新。
它解决的不是“怎么回答”,而是“该记住什么”
可以把外部记忆系统想成快递站的货架。通用大模型负责处理眼前的取件需求,记忆写入模型则要决定哪些包裹应该入库、标签怎样填写、重复包裹是否合并,以及新单据能不能覆盖旧记录。货架很大不代表整理得好;写错标签,后面检索再快也可能拿错东西。
官方介绍称,这个模型可以替换 Mem0、MemOS 和 Hy-Memory 内原本负责写入记忆的通用大模型,覆盖聊天、工作和编程场景。官方还表示,它可以直接迁移到训练时未见过的 EverMemOS 框架。这里的“迁移”是官方报告中的实验结果,不等于任何外部系统接入后都会自然获得相同表现。
模型采用两个训练阶段:先进行 Memory On-Policy Distillation,让学生模型学习教师提供的状态链;再进行 Attributed Memory Reinforcement Learning,根据最终形成的记忆库分配片段级反馈。简单说,前一阶段像先照着规范整理快递,后一阶段再根据后续是否容易找对包裹,反过来调整整理方法。
官方成绩值得看,但要先看测试口径
官方评测只更换记忆写入模型,固定了框架版本、提示词、检索配置、回答模型、裁判模型和其他框架组件。各个写入模型都从空白记忆库开始,使用相同的测试样例与评分规则。这个设计试图把差异集中到“谁在写记忆”,避免把检索器或回答模型的变化混进结果。
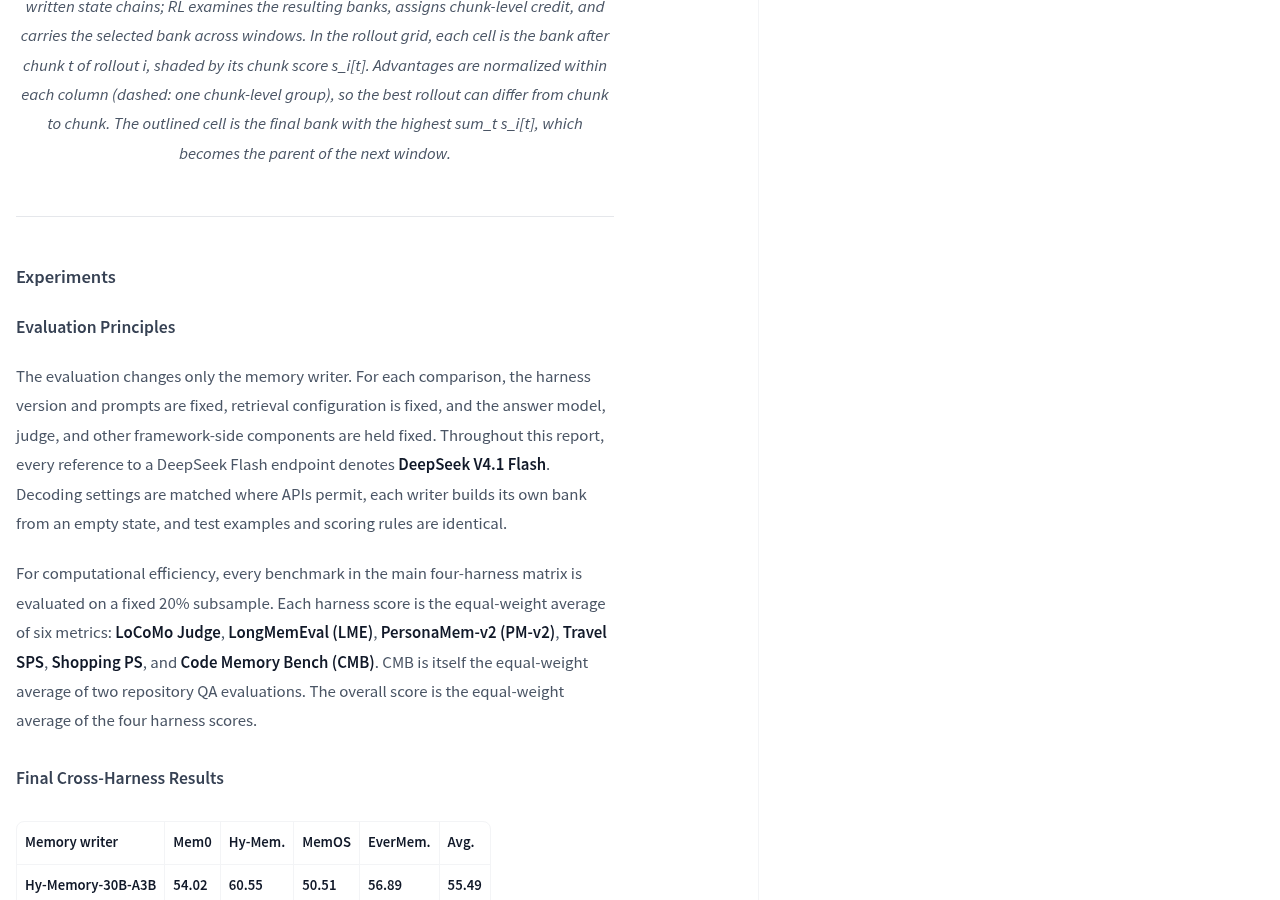
主评测矩阵采用固定 20% 子样本。每套框架的成绩由六项指标等权平均,总成绩再对四套框架等权平均。这里的宏平均可以理解为四份成绩单各占同样分量,不让某一套框架因为题目更多就自动获得更大影响。
| 官方列出的记忆写入模型 | Mem0 | Hy-Memory | MemOS | EverMemOS | 平均分 |
|---|---|---|---|---|---|
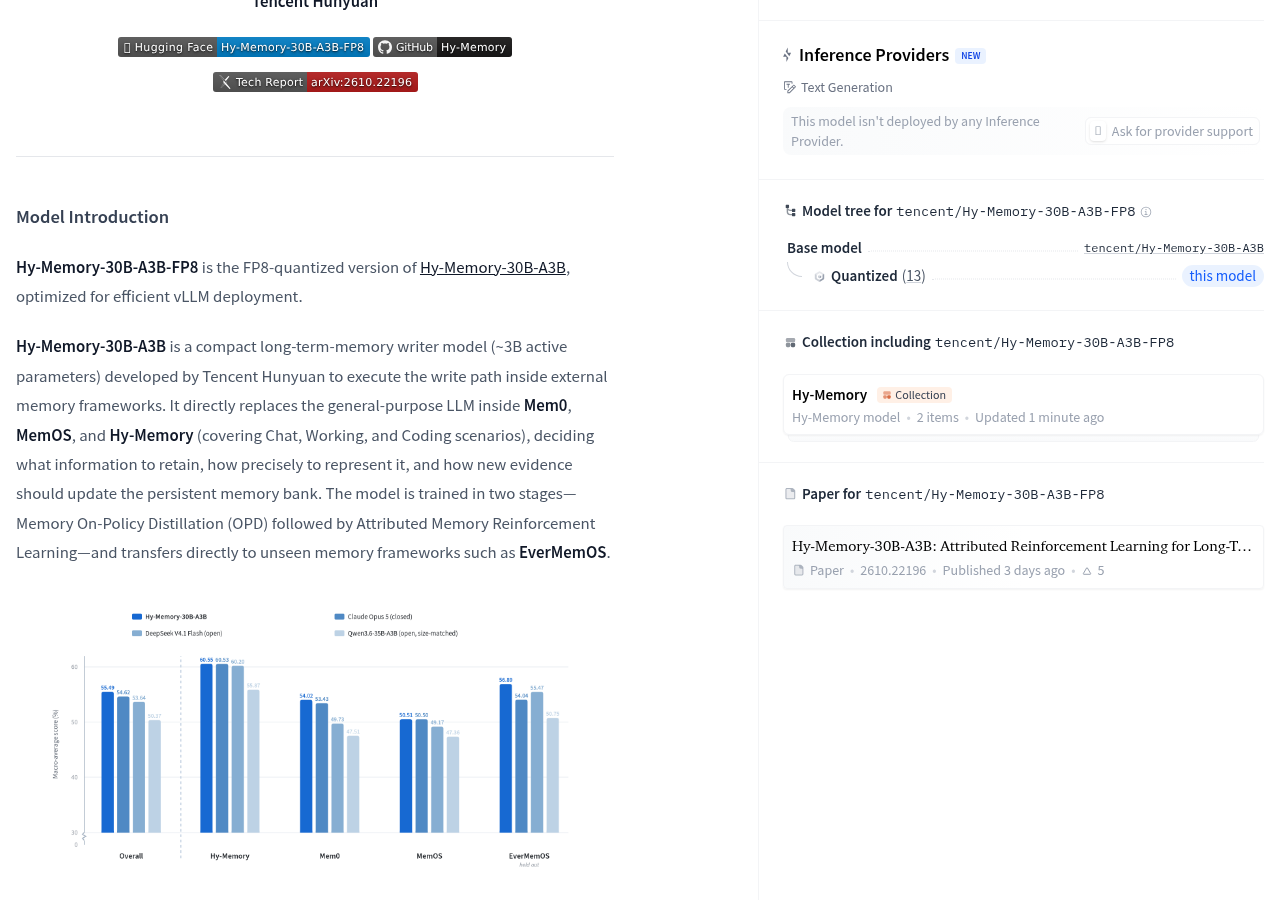
| Hy-Memory-30B-A3B | 54.02 | 60.55 | 50.51 | 56.89 | 55.49 |
| Claude Opus 5 | 53.43 | 60.53 | 50.50 | 54.04 | 54.62 |
| DeepSeek V4.1 Flash | 49.73 | 60.20 | 49.17 | 55.47 | 53.64 |
以上均为腾讯混元官方报告列出的固定 20% 子样本结果,不是独立复测。
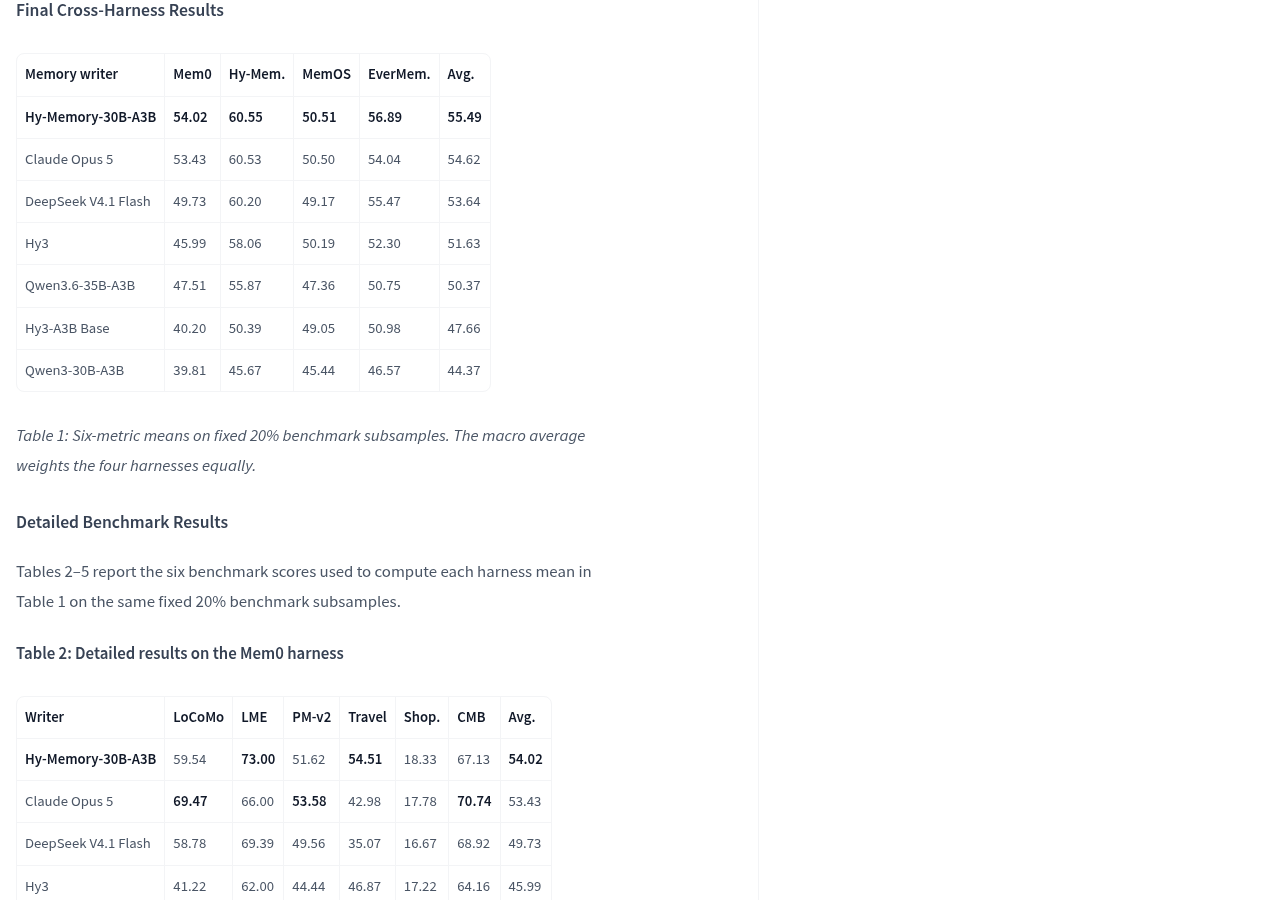
这些数字能说明:在官方设定的固定组件、固定子样本和等权评分方法下,Hy-Memory-30B-A3B 的平均分为 55.49。它们不能单独证明不同生产环境中的长期稳定性,也不能替代对真实业务数据、检索策略和回答模型的测试。尤其是 EverMemOS 虽然被官方列为训练外框架,仍然属于同一份官方实验体系。
三百亿参数不等于每次都动用三百亿参数
模型页面把它列为三百亿参数模型,官方介绍同时注明约三十亿激活参数。可以把这理解成一个大型快递仓库:仓库共有许多货架,但处理一张具体运单时,只调动与当前任务相关的一部分区域。总参数描述整体容量,激活参数描述一次计算实际参与工作的规模,两者不能混为同一个数字。
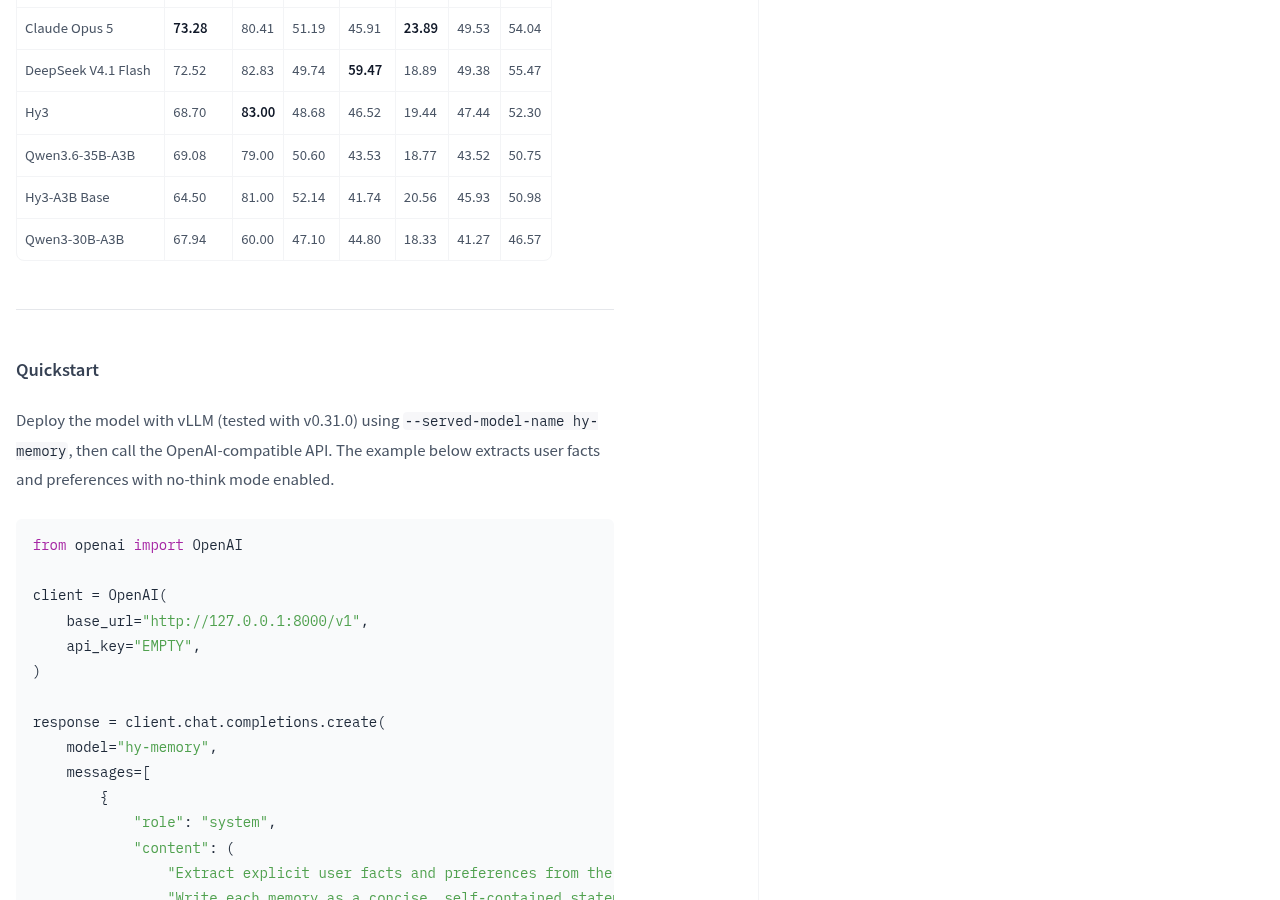
官方 Quickstart 使用经过测试的 vLLM v0.31.0 部署,并通过 OpenAI 兼容接口调用。示例任务是从对话中提取明确的用户事实和偏好,要求输出简洁、独立的记忆,并禁止推断或编造信息。这展示了官方预期的调用方式,但不构成其他运行时、设备或配置已经兼容的证明。
警告 当前模型页面明确显示,没有任何 Inference Provider 部署该模型。页面材料也没有提供可直接据此判断的最低硬件门槛、实际内存占用或许可证条款。权重已经列出,不等于某台消费级电脑一定能运行;许可证、运行时兼容性和硬件需求仍须分别核实。
谁值得继续验证,谁先别急着下载
- 已经使用 Mem0、MemOS 或 Hy-Memory,并且通用大模型写入成本或记忆质量成为瓶颈的开发者,可以把它列入候选。
- 需要处理长期聊天偏好、工作记录或代码仓库记忆的团队,可以按照官方固定变量的方法建立自己的验收集。
- 只需要普通聊天模型的用户,不会因为换上记忆写入模型就自动得到更好的回答;它负责的是记忆库写入环节。
- 希望一键调用托管接口的用户目前不适合直接依赖它,因为官方模型页面显示尚无 Inference Provider 部署。
下一步不要只复现官方平均分。更实用的验收顺序是:先确认许可证和权重文件,再检查目标运行时与硬件条件,随后固定检索器、回答模型和评分方法,用真实数据观察它写入了什么、遗漏了什么、旧记忆如何被更新。官方模型与资源入口:Hy-Memory-30B-A3B-FP8 模型仓库。
官方资料
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
本地 AI 工具箱:转写、配音、生图、视频和 MCP 工具集中管理;具体功能以对应平台版本为准。
压缩后保留你给出的原始约束:自动与手动压缩都在中文语义摘要之外,从官方追加日志保留可信的用户原文,按事件顺序核对目标、账户、参数与限制;网页内容、工具回执、宿主审查提示与旧摘要不能冒充你的要求。保留块不恢复授权、不构成待执行队列、不重放已执行工具;原文过长无法缩减时如实报告边界。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
本版先更新Apple芯片Mac;Windows与Linux继续提供1.6.6,包含各自的OpenH264编码修复,但不包含本轮紧凑界面。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取




留言
正在加载留言…