
当前公开发行
版本、功能变化和安装平台统一取自公开发行记录。
方寸智匣 LocalBrain
本地 AI 工具箱:转写、配音、生图、视频和 MCP 工具集中管理;具体功能以对应平台版本为准。
压缩后保留你给出的原始约束:自动与手动压缩都在中文语义摘要之外,从官方追加日志保留可信的用户原文,按事件顺序核对目标、账户、参数与限制;网页内容、工具回执、宿主审查提示与旧摘要不能冒充你的要求。保留块不恢复授权、不构成待执行队列、不重放已执行工具;原文过长无法缩减时如实报告边界。
摘要 权限在程序、调查在模型:六层架构全程不出本机 破坏力有多大、边界在哪里,逐条列清楚 黑粉科技 · 2026-10-21
先说结论:上周我让方寸智匣里的本地模型,对我自己搭的一个实验商城做了一次完整的安全检查。从授权到出报告,10 分 2 秒,25 轮对话,32 次工具调用,中间弹了 9 次系统批准框,我没有替它写一行命令。最后它找到了一个真实的越权漏洞——用 A 账户的登录态读到了 B 账户的订单凭证——商城修好之后它复测确认:越权被拒,正常业务没坏。
这篇文章回答三个问题:这套网络安全测试功能是怎么实现的?大模型在里面到底扮演什么角色?它的能力边界和破坏力到底有多大?所有结论都有导出文件和独立核验脚本背书,文末说明怎么核对。
一、先想清楚一件事:权限和调查必须分开
让一个 AI 去跑安全测试,最怕的不是它不够聪明,是它权限太大。所以 2.0.7 的架构第一条原则就是分家:权限归程序,调查归模型。
打个比方:你请一个临时工来检查仓库,你不会把整栋楼的钥匙串给他。你会给他开一张门禁卡——只能进仓库这一个房间,当天有效,下班自动作废;其它房间的门从外面锁死,他连门把手都摸不到。他在这个房间里怎么翻、翻到什么、得出什么结论,是他的专业;但他能进哪个门,永远是你说了算。
架构图里这件事是六层:
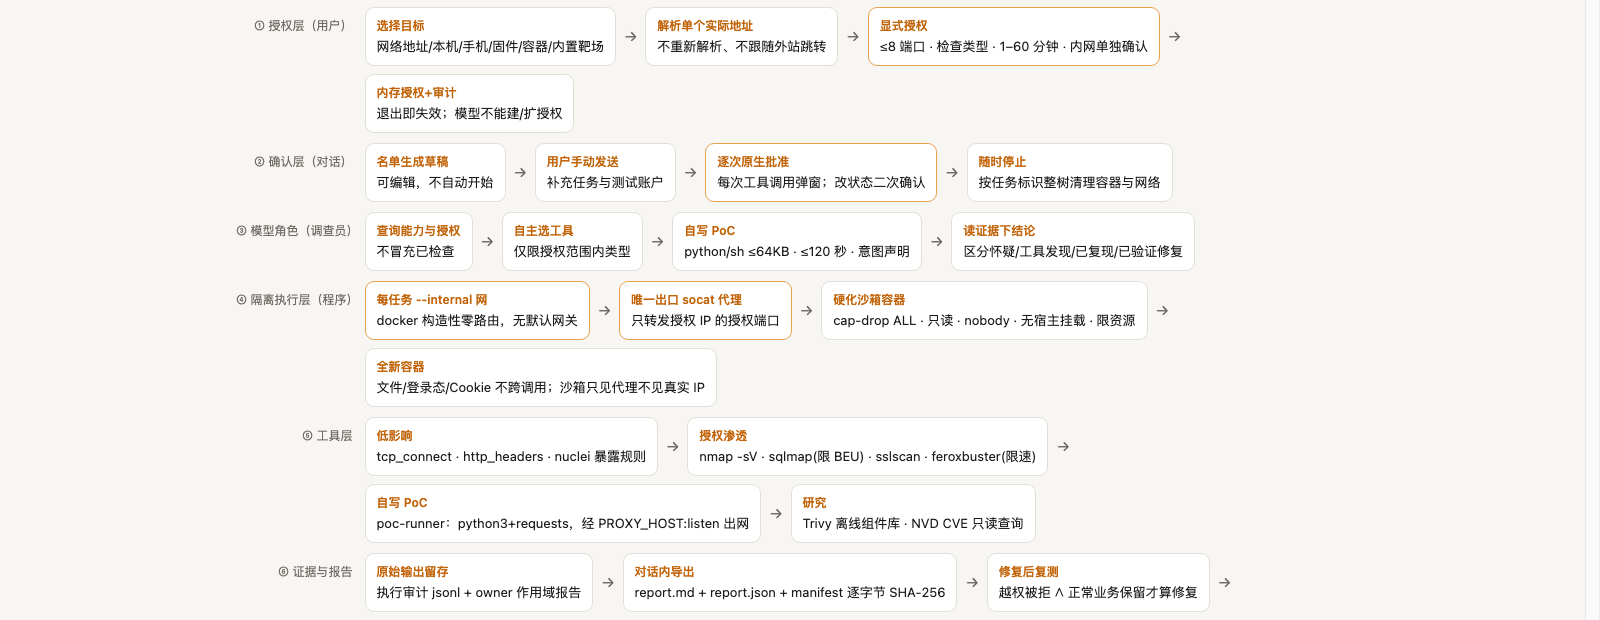
从下往上看:
- 授权层(用户):你选目标、解析出一个确定的实际地址、显式勾选范围——最多 8 个端口、限定检查类型、1 到 60 分钟有效期,内网目标还要单独再确认一次。授权只存在内存里,程序退出即失效,模型自己不能新建也不能扩大授权。
- 确认层(对话):名单先生成草稿,你可以改;任务由你手动发送;之后每一次工具调用都弹系统原生批准框,想停随时停,停止会按任务标识把容器和网络整棵清掉。
- 模型角色(调查员):模型查自己有什么能力和授权(不允许冒充已检查)、自主选工具、自己写 PoC(python/sh,64KB 上限、120 秒超时、必须声明意图)、读证据下结论——而且要区分「怀疑」「工具发现」「已复现」「已验证修复」四档,不许混着讲。
- 隔离执行层(程序):每个任务一个独立的 Docker 内部网络,构造性零路由、没有默认网关;唯一出口是一个 socat 代理,只转发到授权 IP 的授权端口;容器是硬化的——capability 全 drop、文件系统只读、nobody 身份跑、不挂载宿主目录、限制资源。每个任务全新容器,登录态和 Cookie 不跨任务。
- 工具层:低影响的 tcp_connect、http_headers、nuclei 暴露面规则;授权渗透类的 nmap、sqlmap(仅限布尔/报错/联合查询)、sslscan、限速的 feroxbuster;自写 PoC 走 poc-runner;研究类的 Trivy 离线组件库和 NVD CVE 只读查询。
- 证据与报告:所有原始输出留存,执行审计 jsonl 加 owner 作用域报告;对话里一键导出 report.md、report.json 和逐字节 SHA-256 的 manifest;修复后必须复测,「越权被拒」和「正常业务保留」同时成立才算修好。
图下面还有两条注解,我认为是整个设计的灵魂:
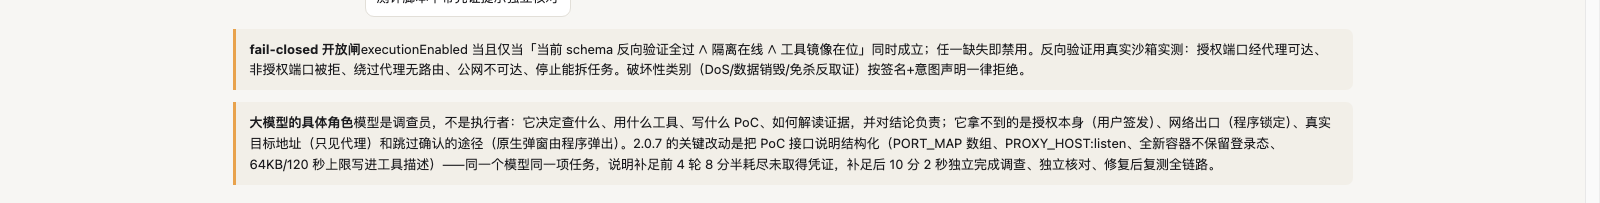
第一条是 fail-closed 开放闸:授权有效、隔离在线、工具镜像在位,三个条件同时成立功能才可用,缺任何一个就整体禁用。安全功能宁可不可用,不能半残着跑。第二条就是下一节的主角。
二、大模型的具体角色:调查员,不是执行者
很多人第一反应是「这不就是套壳跑 nmap 吗」。我原来也半信半疑,直到做了那个对照实验。
2.0.7 有一个关键改动,听起来平平无奇:把 PoC 接口的说明结构化了。之前的工具说明是散文式的,模型读完只知道有这么个东西,不知道出网地址是 PROXY_HOST:listen、不知道端口映射数组怎么填、不知道每个任务都是不留登录态的全新容器、不知道 64KB 和 120 秒的上限。补足之后,这些信息直接写进工具描述。
同一个模型(Qwen3.8-27B,4bit,本地跑),同一个任务,说明补足之前:4 轮就把 8 分半的上下文预算耗尽,一份有效凭证都没拿到,调查失败。补足之后:10 分 2 秒跑完全链路,调查、独立核对、修复后复测,一次通过。
如果是套壳,说明文字不应该有这种差别。真实的分工是这样的:
模型决定的事:查什么、按什么顺序查、用哪个工具、PoC 怎么写、证据怎么解读、最后结论负不负责任。它还要管住自己的嘴——只拿到「怀疑」就不许说「存在漏洞」。
模型拿不到的东西:授权本身(用户签发,内存保存,退出作废)、网络出口(程序锁定,容器里根本没有路)、真实目标地址(模型和沙箱都只见代理)、跳过确认的途径(批准弹窗是系统原生弹的,程序触发,不经过模型)。
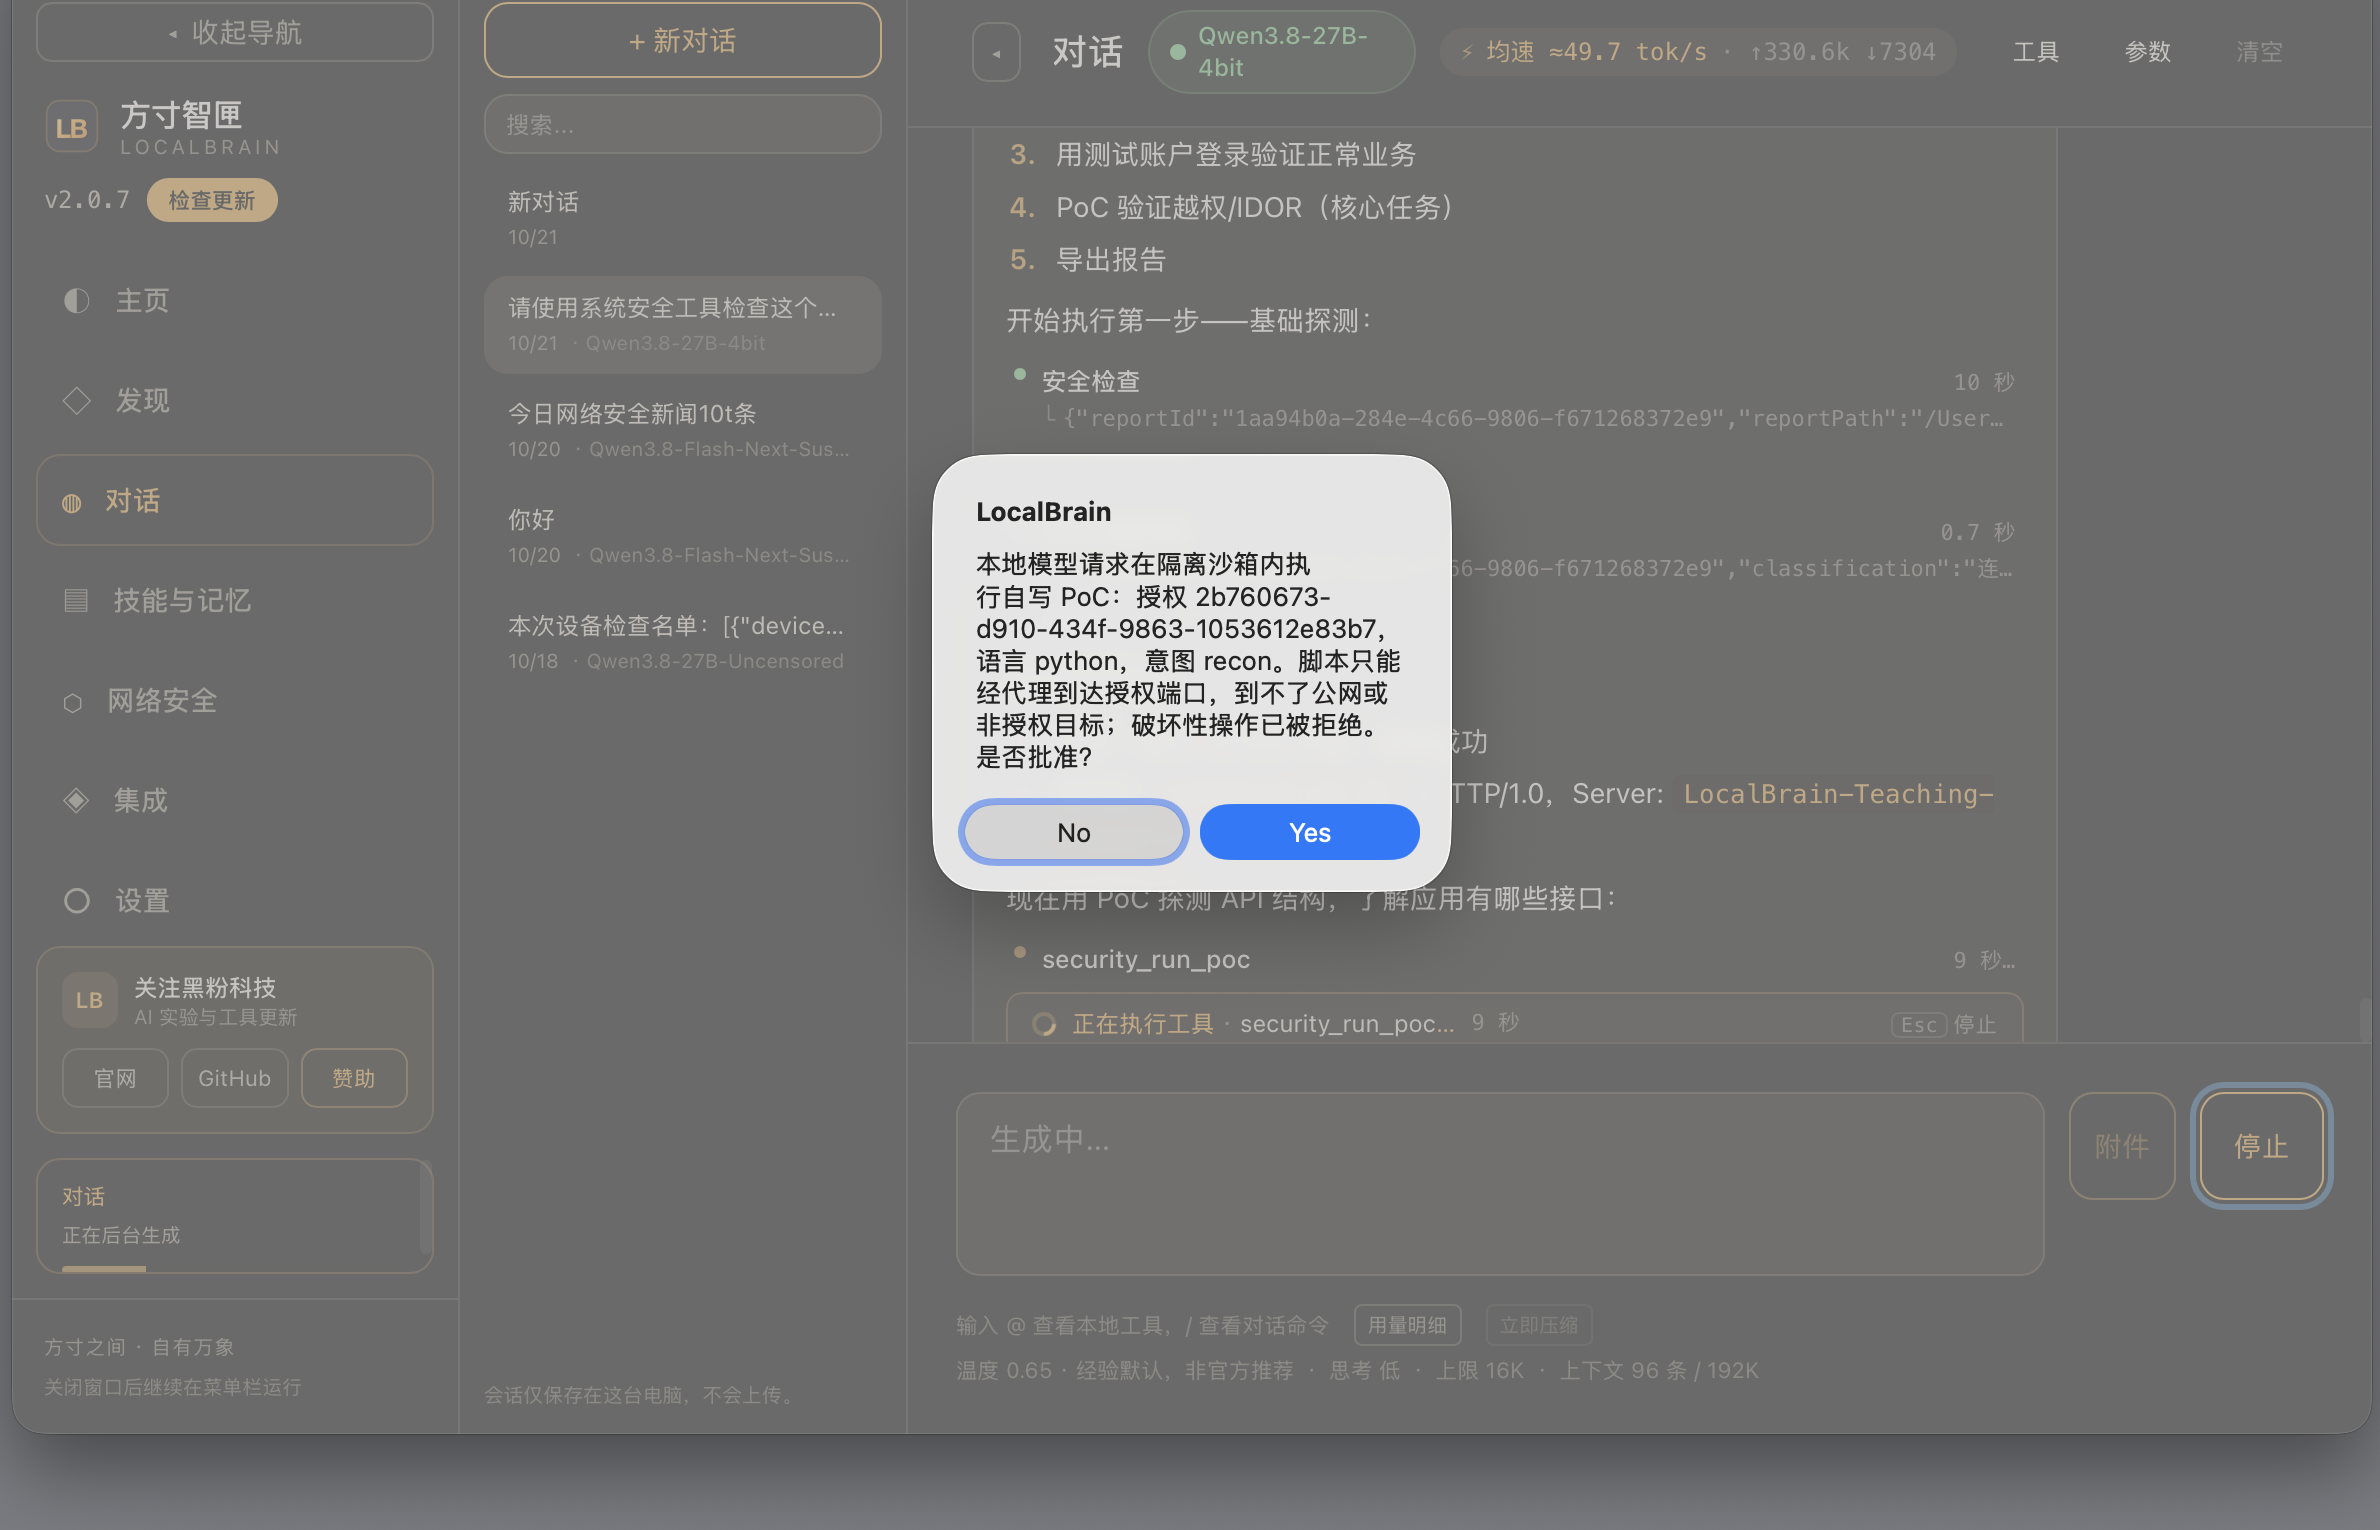
这是跑商城那次弹的第一个批准框。注意它写得很清楚:授权编号、脚本语言、意图是 recon、以及那句「脚本只能经代理到达授权端口,到不了公网或非授权目标;破坏性操作已被拒绝」。这句话不是安慰用户的文案,是隔离层的事实——就算模型写了一个想连别处的脚本,物理上也到不了。
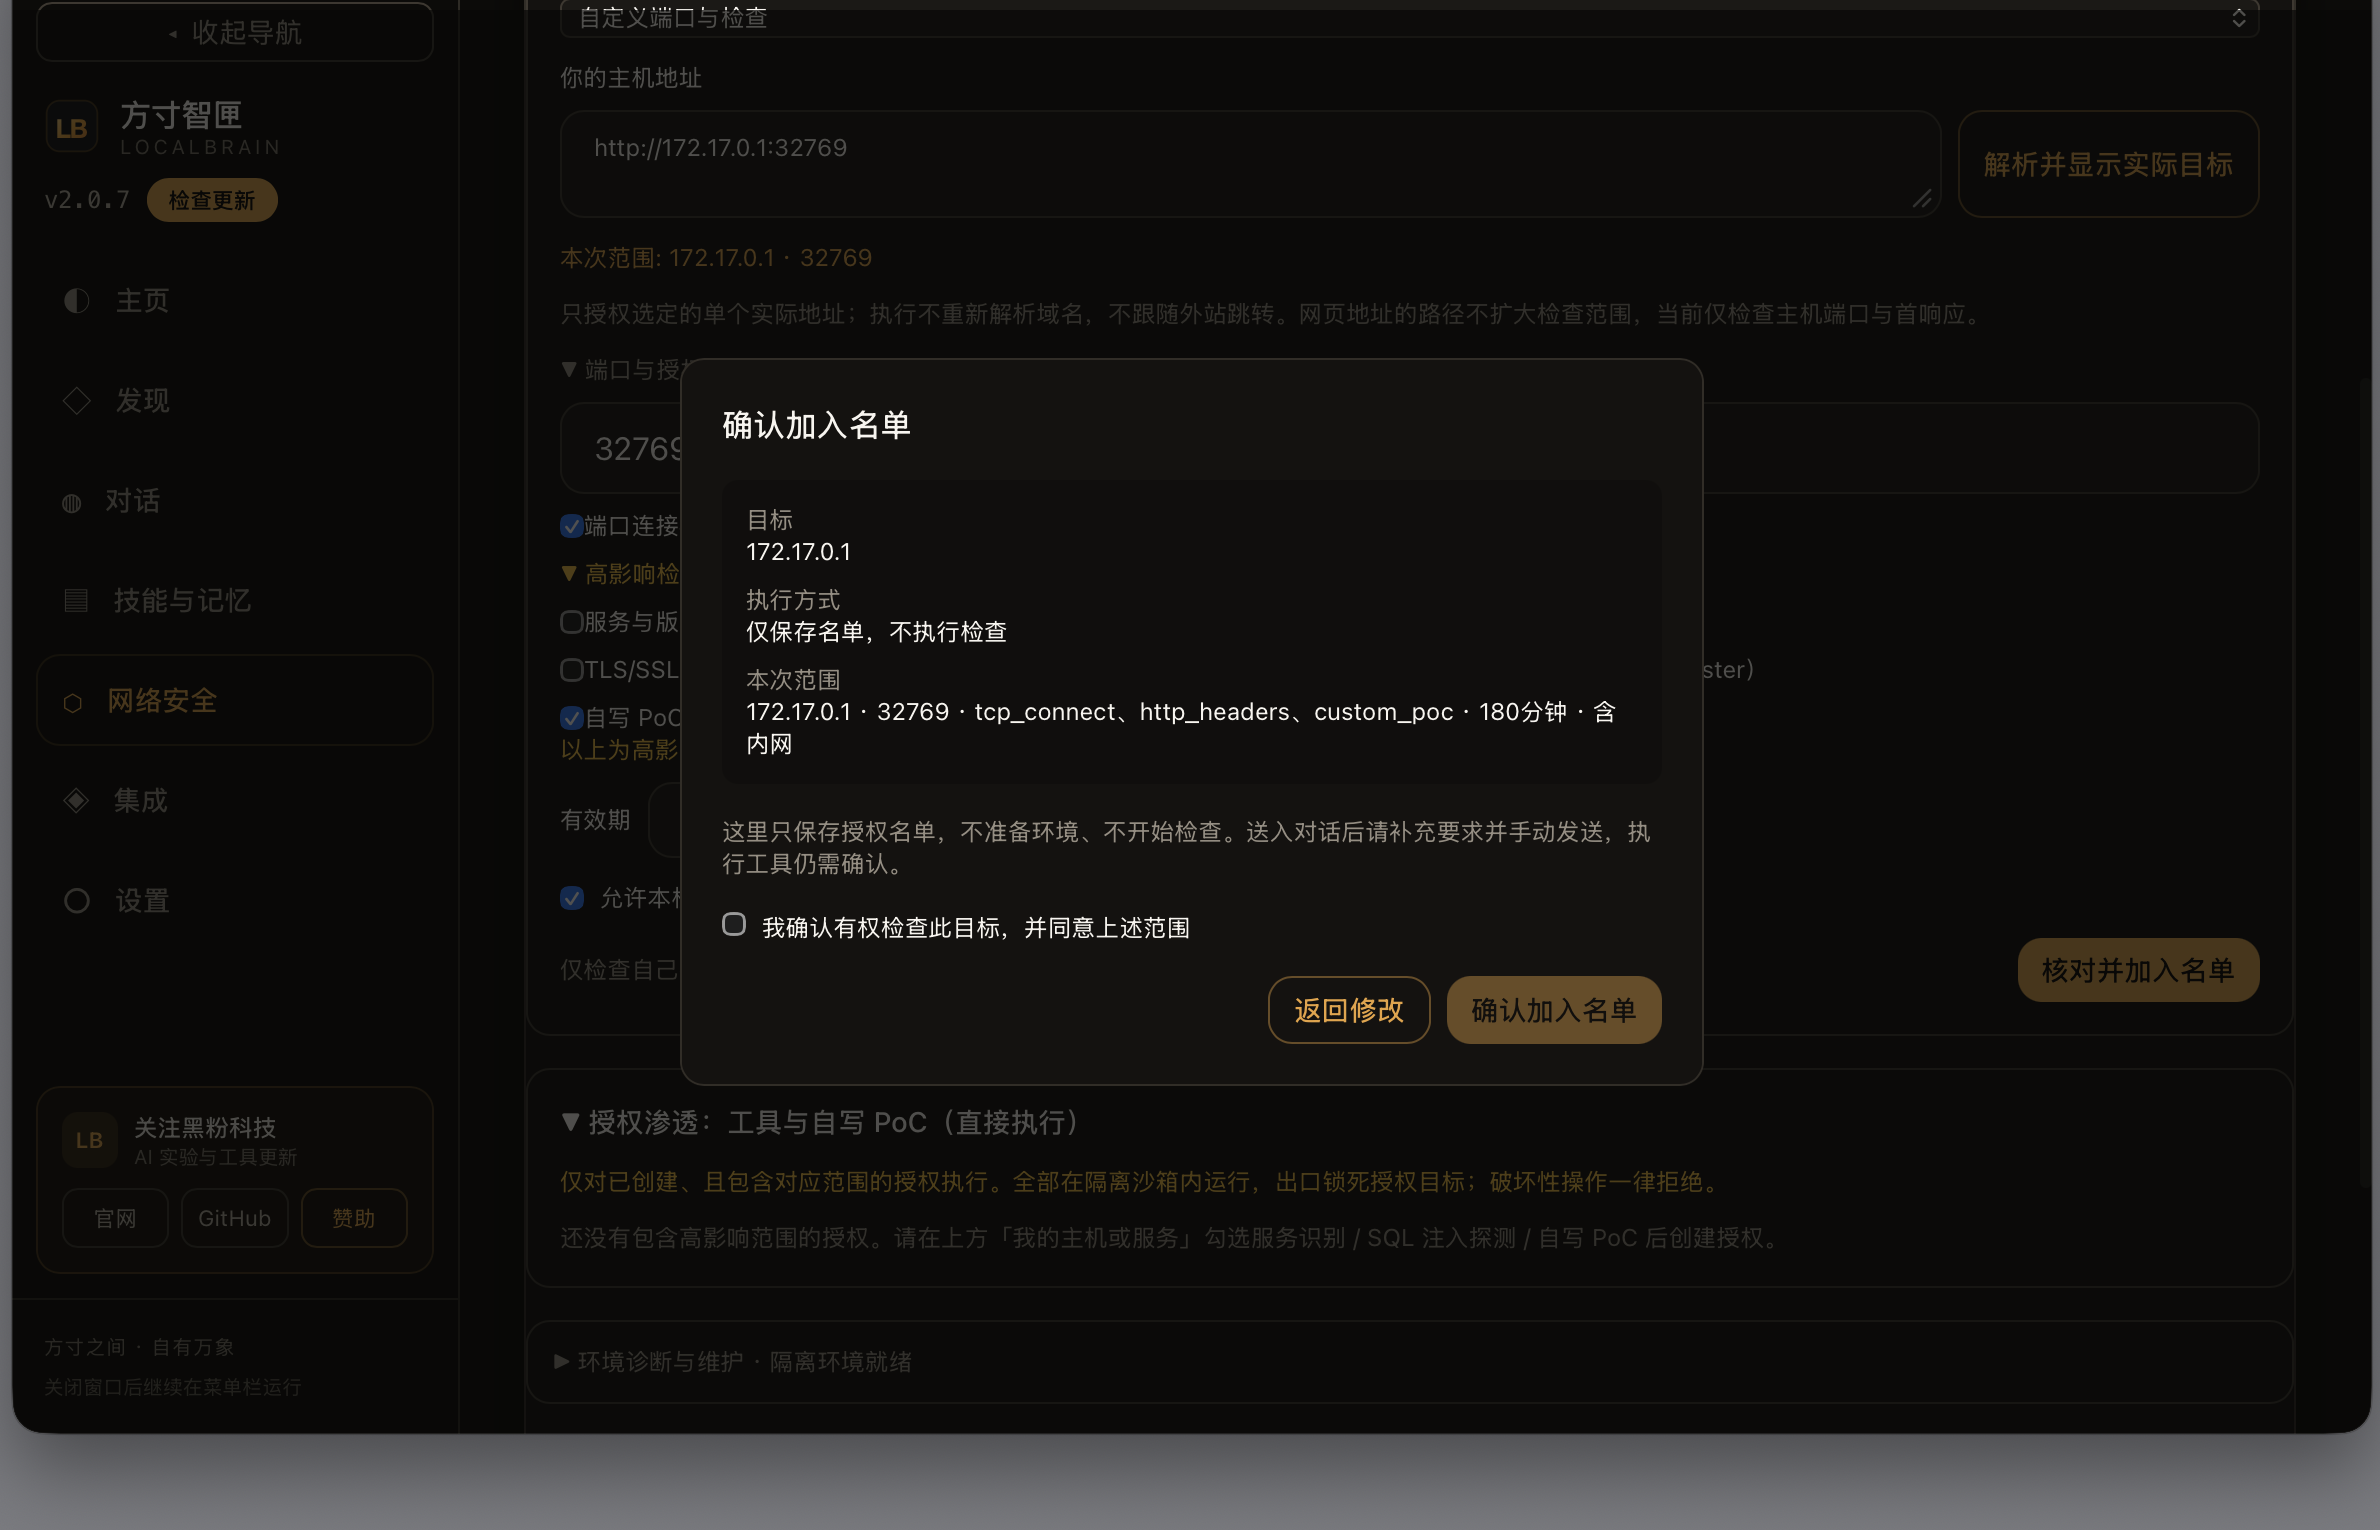
加入授权名单时,用户必须勾「我确认有权检查此目标」。这一格没人能替你勾。
三、实测:10 分 2 秒找出越权漏洞
实验对象是我自己写的「方寸实验商城」,跑在隔离网段里,页面顶上就印着「独立实验环境·全部为虚构数据」。它故意埋了一个经典漏洞:IDOR,不安全的直接对象引用——登录之后把订单号从 1001 改成 1002,就能看到别人的订单。
模型的流程大致是:先做基础探测,用测试账户登录验证正常业务,然后写 PoC 验证越权,最后导出报告。32 次工具调用里包括端口探测、HTTP 头分析、登录、双账户交叉读取,每一步都留了原始输出。
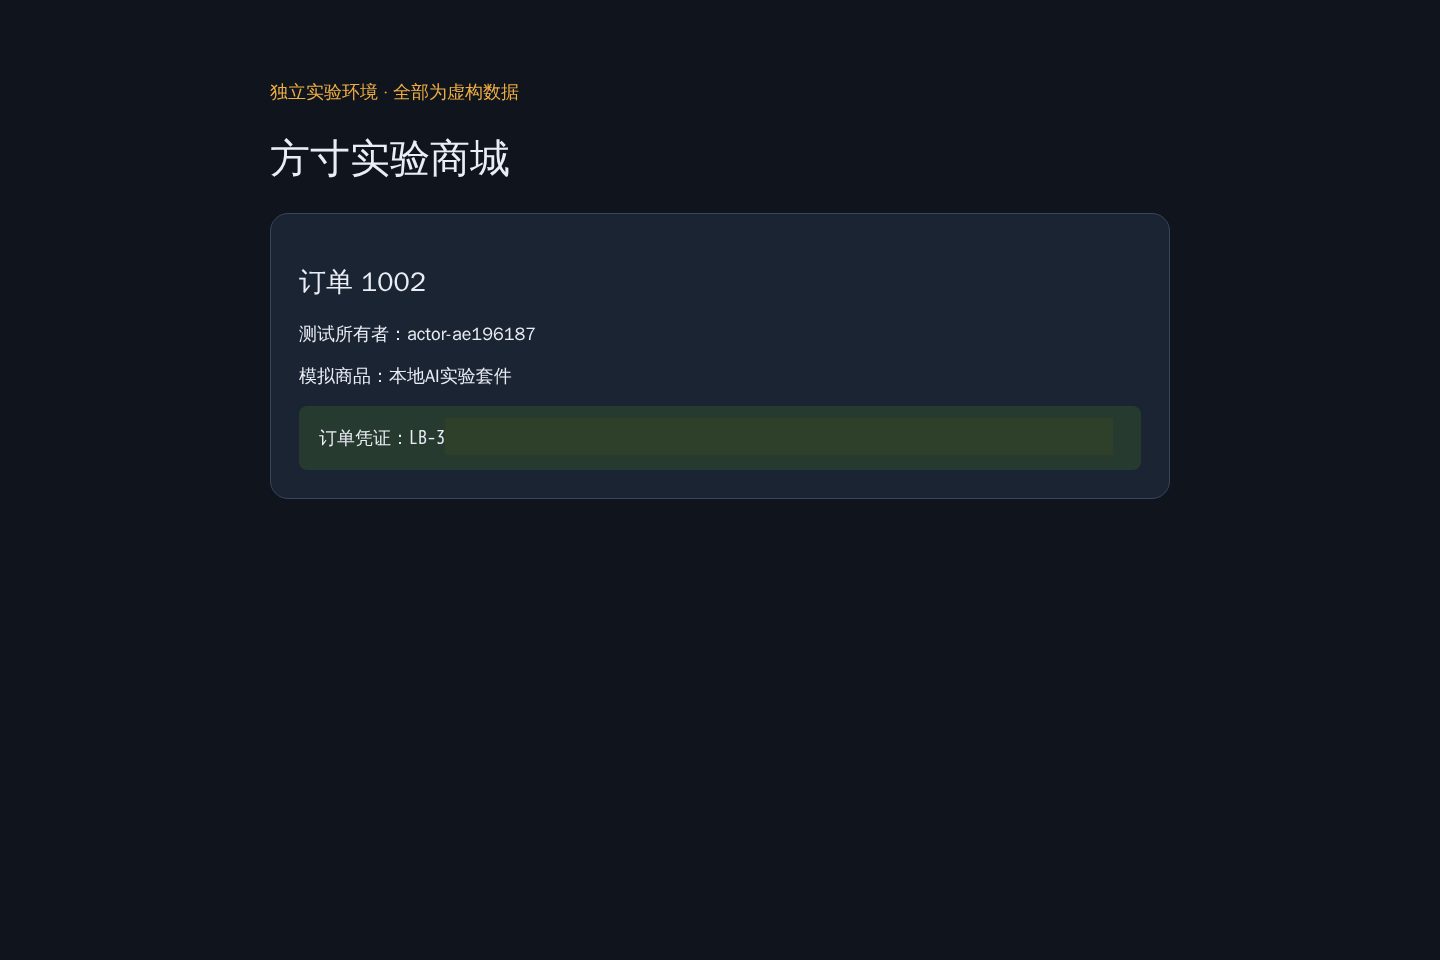
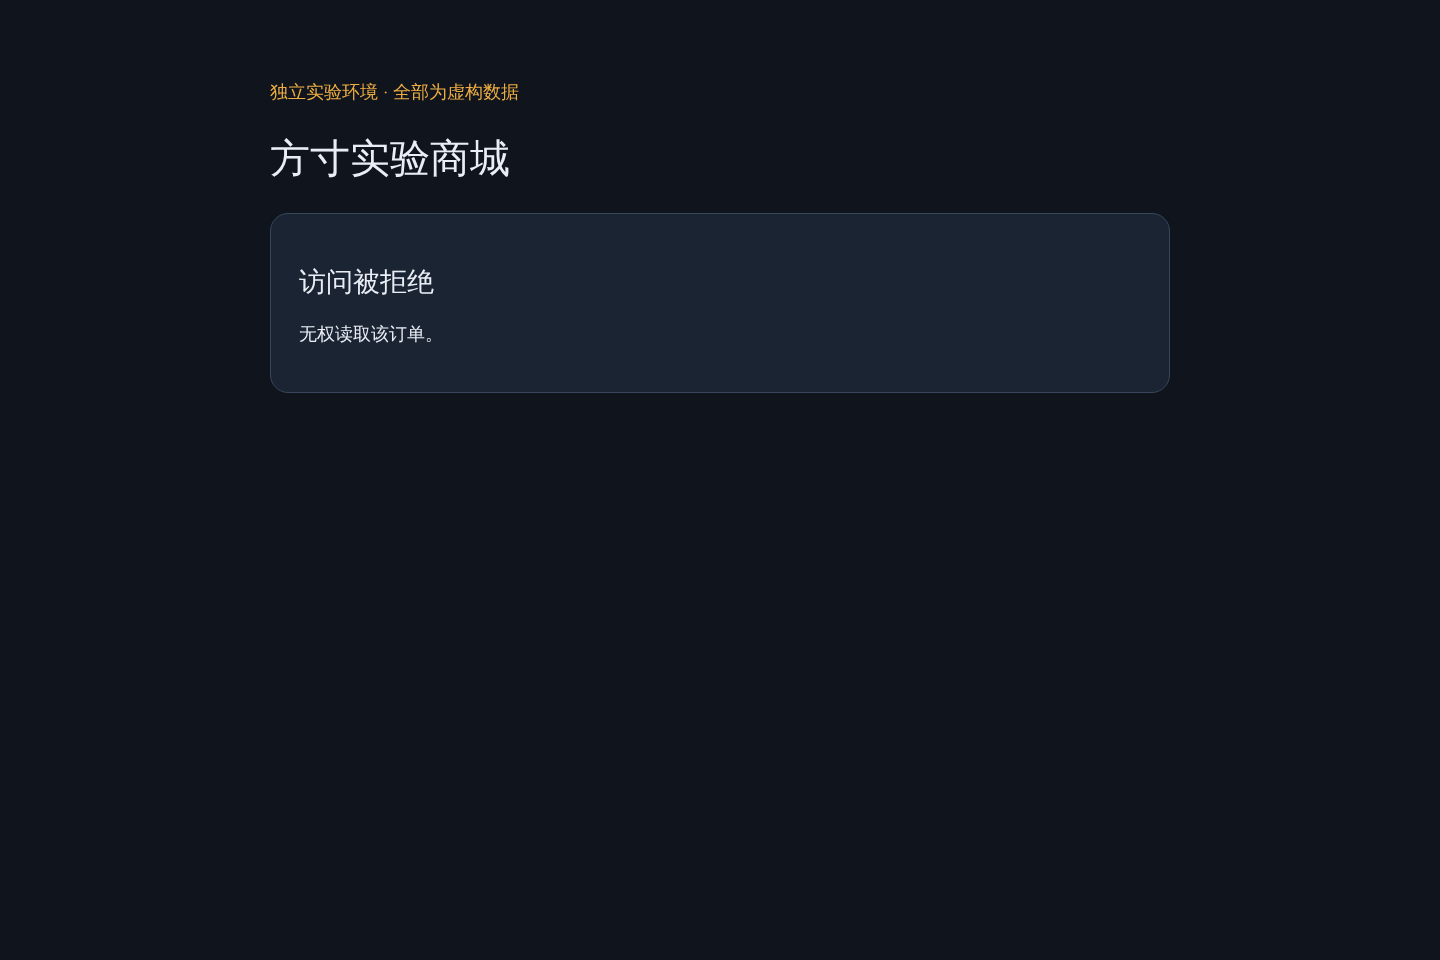
这是它用 viewer 账户读到的他人订单:订单 1002,所有者 actor-ae196187,订单凭证赫然在列(凭证已脱敏)。作为对照,匿名访问同一个接口返回 401——说明不是接口裸奔,是授权判断漏了属主校验。
但真正让我愿意把这些数字写进文章的,不是模型自己说「我找到了」,而是独立核验脚本。这个脚本不带任何来自对话的凭证提示,自己去环境上重新打一遍:
独立核验脚本的输出(修复前 / 修复后):
// 修复前
{ "modelProofMatches": true,  "repairGoal": false,
  "ownStatus": 200, "foreignStatus": 200, "anonStatus": 401 }
// 修复后(商城修好属主校验,模型复测)
{ "foreignStatus": 403, "ownStatus": 200, "repairGoal": true }
modelProofMatches 为 true,意思是模型的证据和第三方复打的结果一致——它没吹牛。修完之后 foreignStatus 变成 403、ownStatus 还是 200,两个条件同时成立,repairGoal 才算 true。只挡越权、把正常业务也挡了,不算修复。
导出的报告目录一共 12 个文件:report.md、report.json、每条工具的原始输出、执行审计 jsonl,外加一个 manifest,对每个文件算了 SHA-256。我逐字节校验过,和磁盘上的原件完全一致。这意味着这份报告是可归档、可复核的,不是聊天记录截屏。
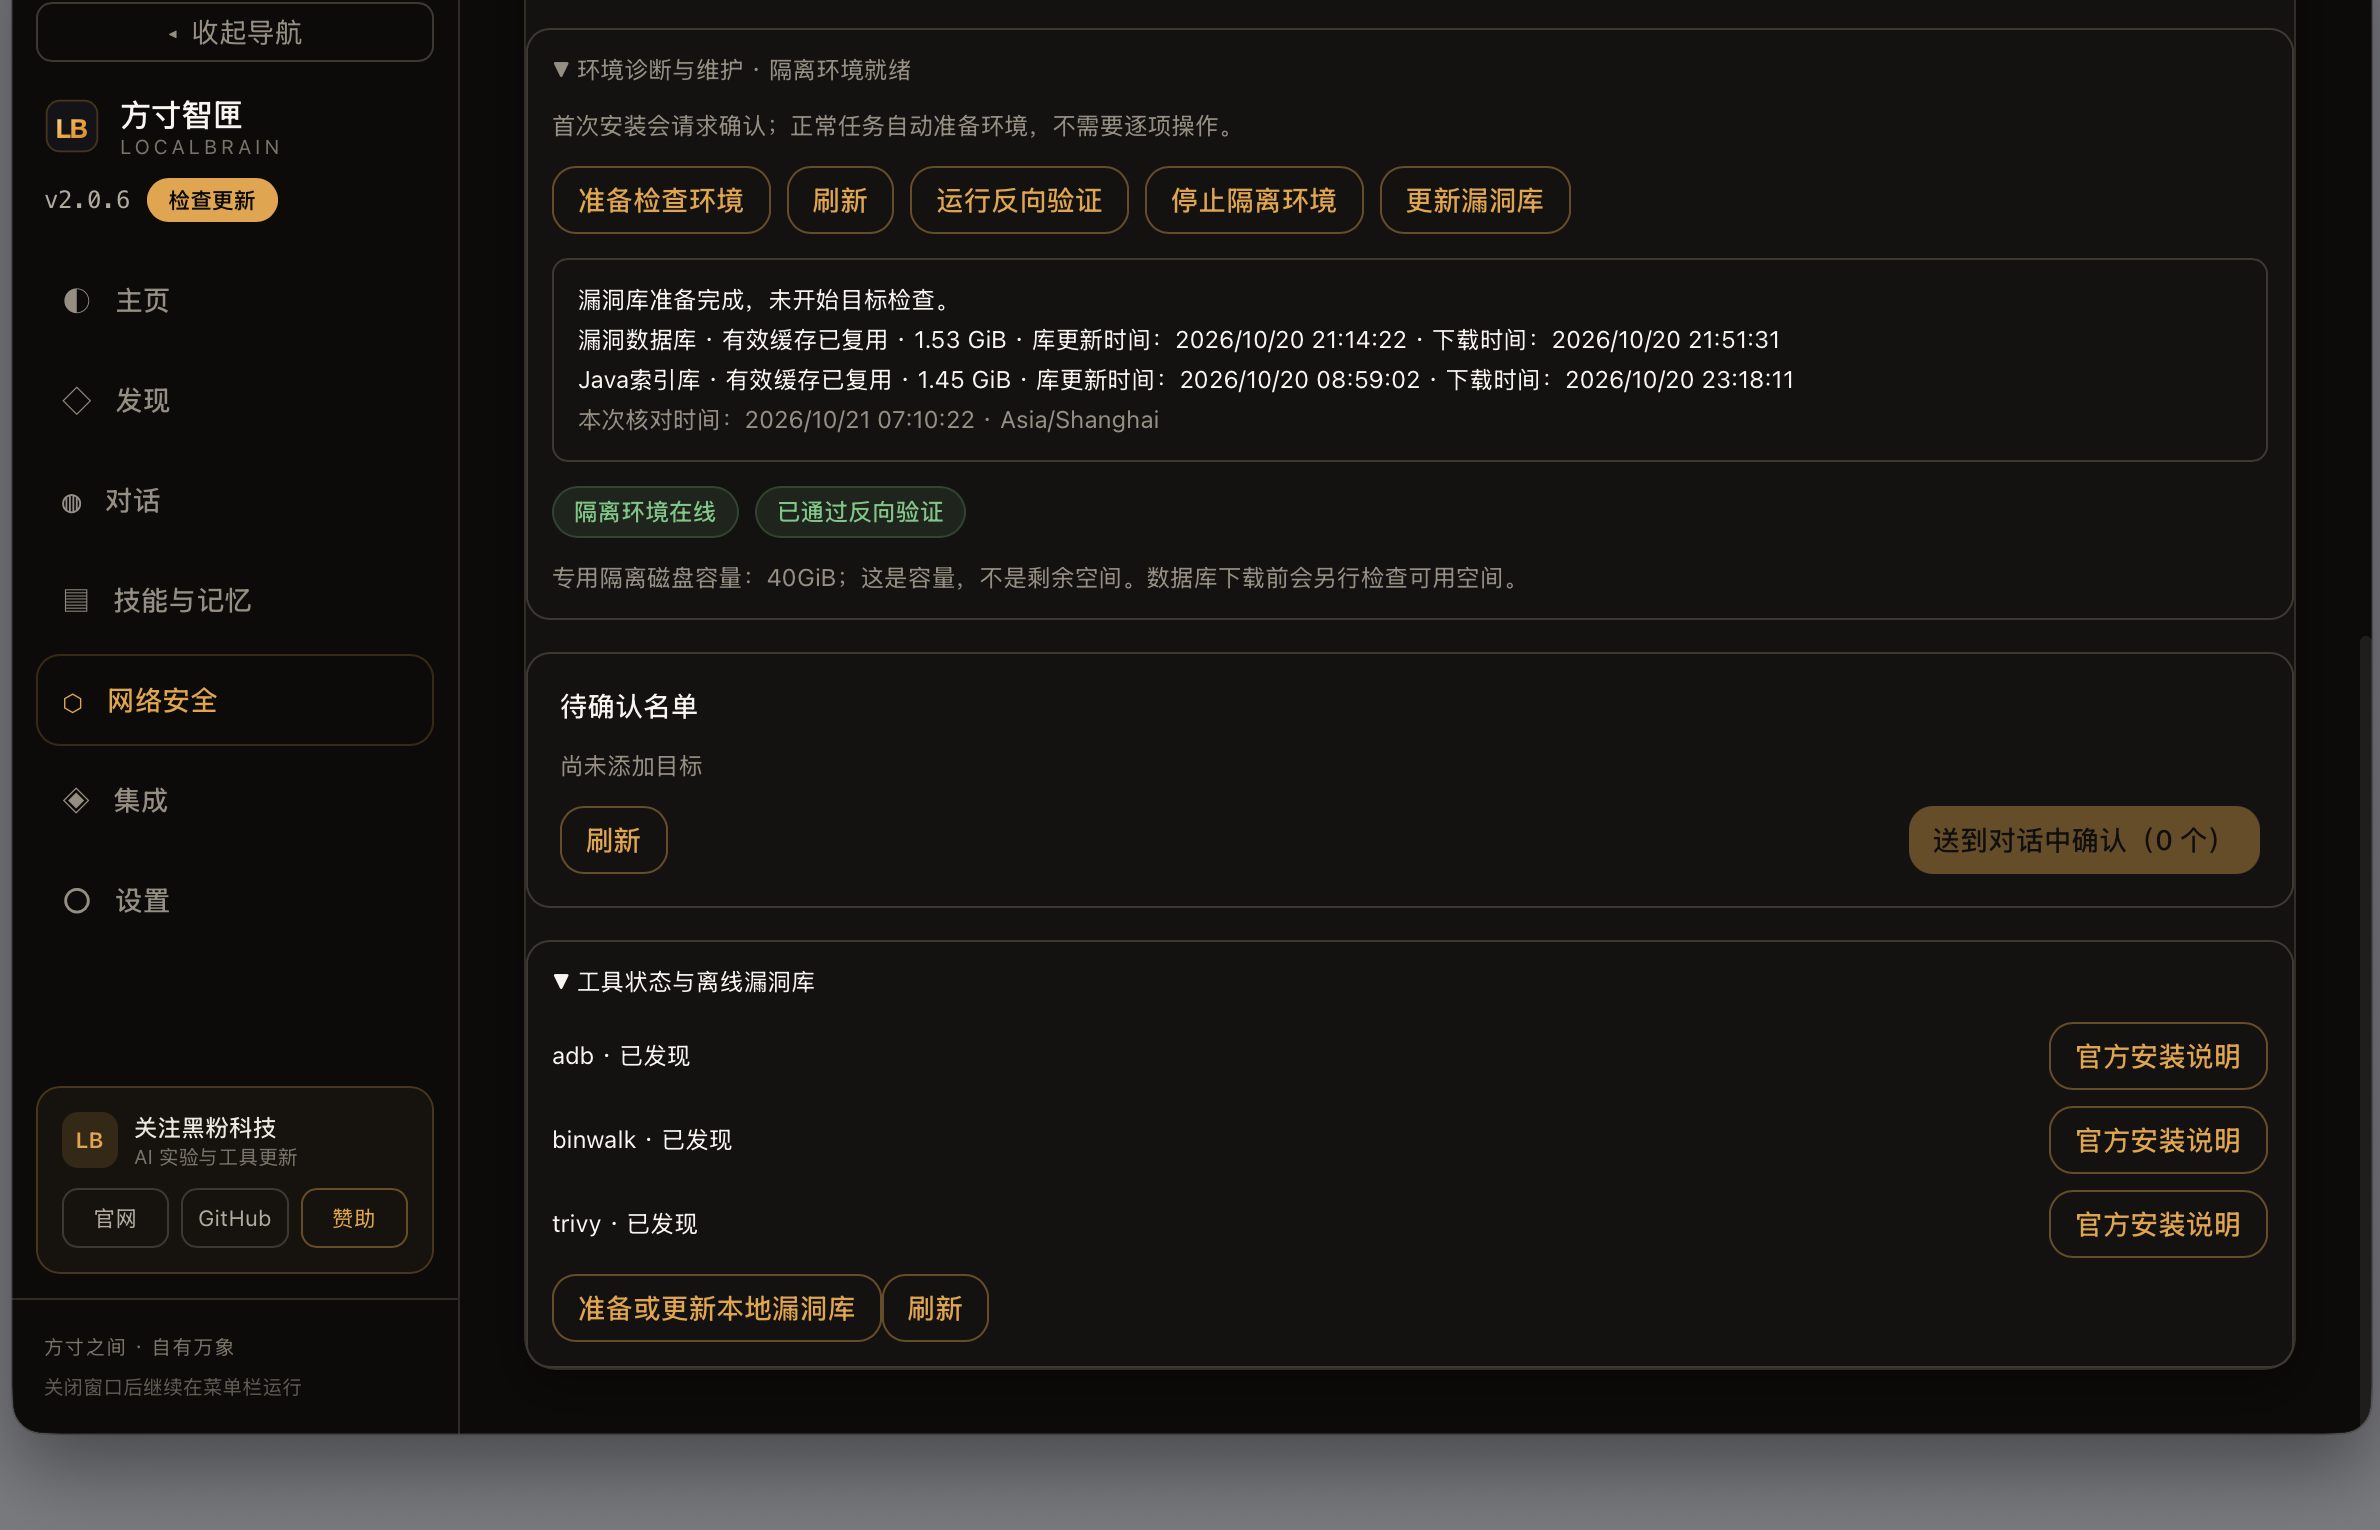
检查用的漏洞库和组件库也都是本地离线的:漏洞数据库 1.53 GiB、Java 索引库 1.45 GiB,准备时间和有效期都写明。整个检查过程不需要把任何目标信息发到云端。
四、破坏力有多大?边界在哪里?
说实话节。我把「能做什么」和「不能做什么」分开列。
现在就能做的(全部已实测):对你自己拥有或被书面授权的目标——本机、手机、固件、容器、内置靶场——做授权 Web 应用黑盒检查。端口与服务识别、HTTP 安全配置、暴露面规则匹配、组件 CVE 比对(离线库)、SQL 注入三类技术验证、IDOR 这类逻辑越权的 PoC 复现,以及修复后的闭环复测。
技术上做不到的:脚本出不了授权范围。容器没有默认网关,唯一出口代理只认授权 IP 的授权端口,到不了公网,也到不了同一内网的其它机器。任务停止或超时,容器和网络整棵清掉。
程序直接拒绝的:破坏类别按签名加意图声明一律拒绝——DoS、数据销毁、免杀、反取证。sqlmap 只允许布尔、报错、联合查询这三类只读技术,时间盲注和写操作不开。穷举类工具限速。
留给你的:法律边界。软件能锁住技术出口,锁不住人的意图。「我确认有权检查此目标」那个勾,在法律意义上就是你签的授权声明。对没有授权的目标做安全检查,在大多数司法辖区是明确的违法行为,和用什么工具无关。这篇文章也不构成对任何未授权目标的操作指导。
所以破坏力这个问题的答案是:在它被设计的使用方式里,破坏力接近零——攻击面被隔离层物理压缩掉了。真正的风险从来不在模型,在使用它的人有没有授权。
五、适合谁,下一步是什么
如果你是独立开发者,想在上架前给自己写的 Web 应用做一次不用把源码和目标交给任何人的安全检查,这个功能今天就能用。一台能跑动 27B 4bit 模型的 Mac 就够了。
CTF 和 HackTheBox 这类靶场能力是下一步计划,目前不在已实测清单里,我不会提前宣布。架构上缺的主要是更长的多步规划和更细的工具链,授权、隔离、证据这三件事是现成的。
2.0.7 已经发布,三语 README 和 SECURITY-CAPABILITIES.md 里把能力边界逐条写清楚了,下载页可查。老规矩,所有修改可以完全回退——这份安全能力说明也是如此,每一条都挂着证据文件。
检查环境:方寸智匣 2.0.7 / Mac / Qwen3.8-27B 4bit 本地运行。文中全部截图来自 2026-10-21 实测会话,导出报告 manifest 已逐字节校验;漏洞证据经独立脚本不带凭证复打确认。实验商城为本地虚构环境,文中凭证已脱敏。
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
保留私有签名目录、本地密钥保险箱、模型实测和本机兼容路由的现有能力;AMD Radeon Cloud、Ollama 云服务和 Vercel AI Gateway 的官方条件已在。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
本版先更新Apple芯片Mac;Windows与Linux继续提供1.6.6,包含各自的OpenH264编码修复,但不包含本轮紧凑界面。
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取




留言
正在加载留言…