把 Mac 变成 私有 AI 盒子
不是再造一个聊天网页,而是把本地模型、多媒体、文档和 Agent 工具收进同一个 Mac 工作台。
提示 黑粉科技 HyphenTech · LocalBrain 1.2.22 · 2026-08-30
我做 LocalBrain,不是因为本地模型已经能打赢云端。同一个复杂任务,顶级云模型通常还是更聪明、更稳。真正让我头大的,是模型在一个目录,MLX 在一个终端,GGUF 又要另一套服务;转写、配音、生图、视频和文档还各有自己的运行方式。
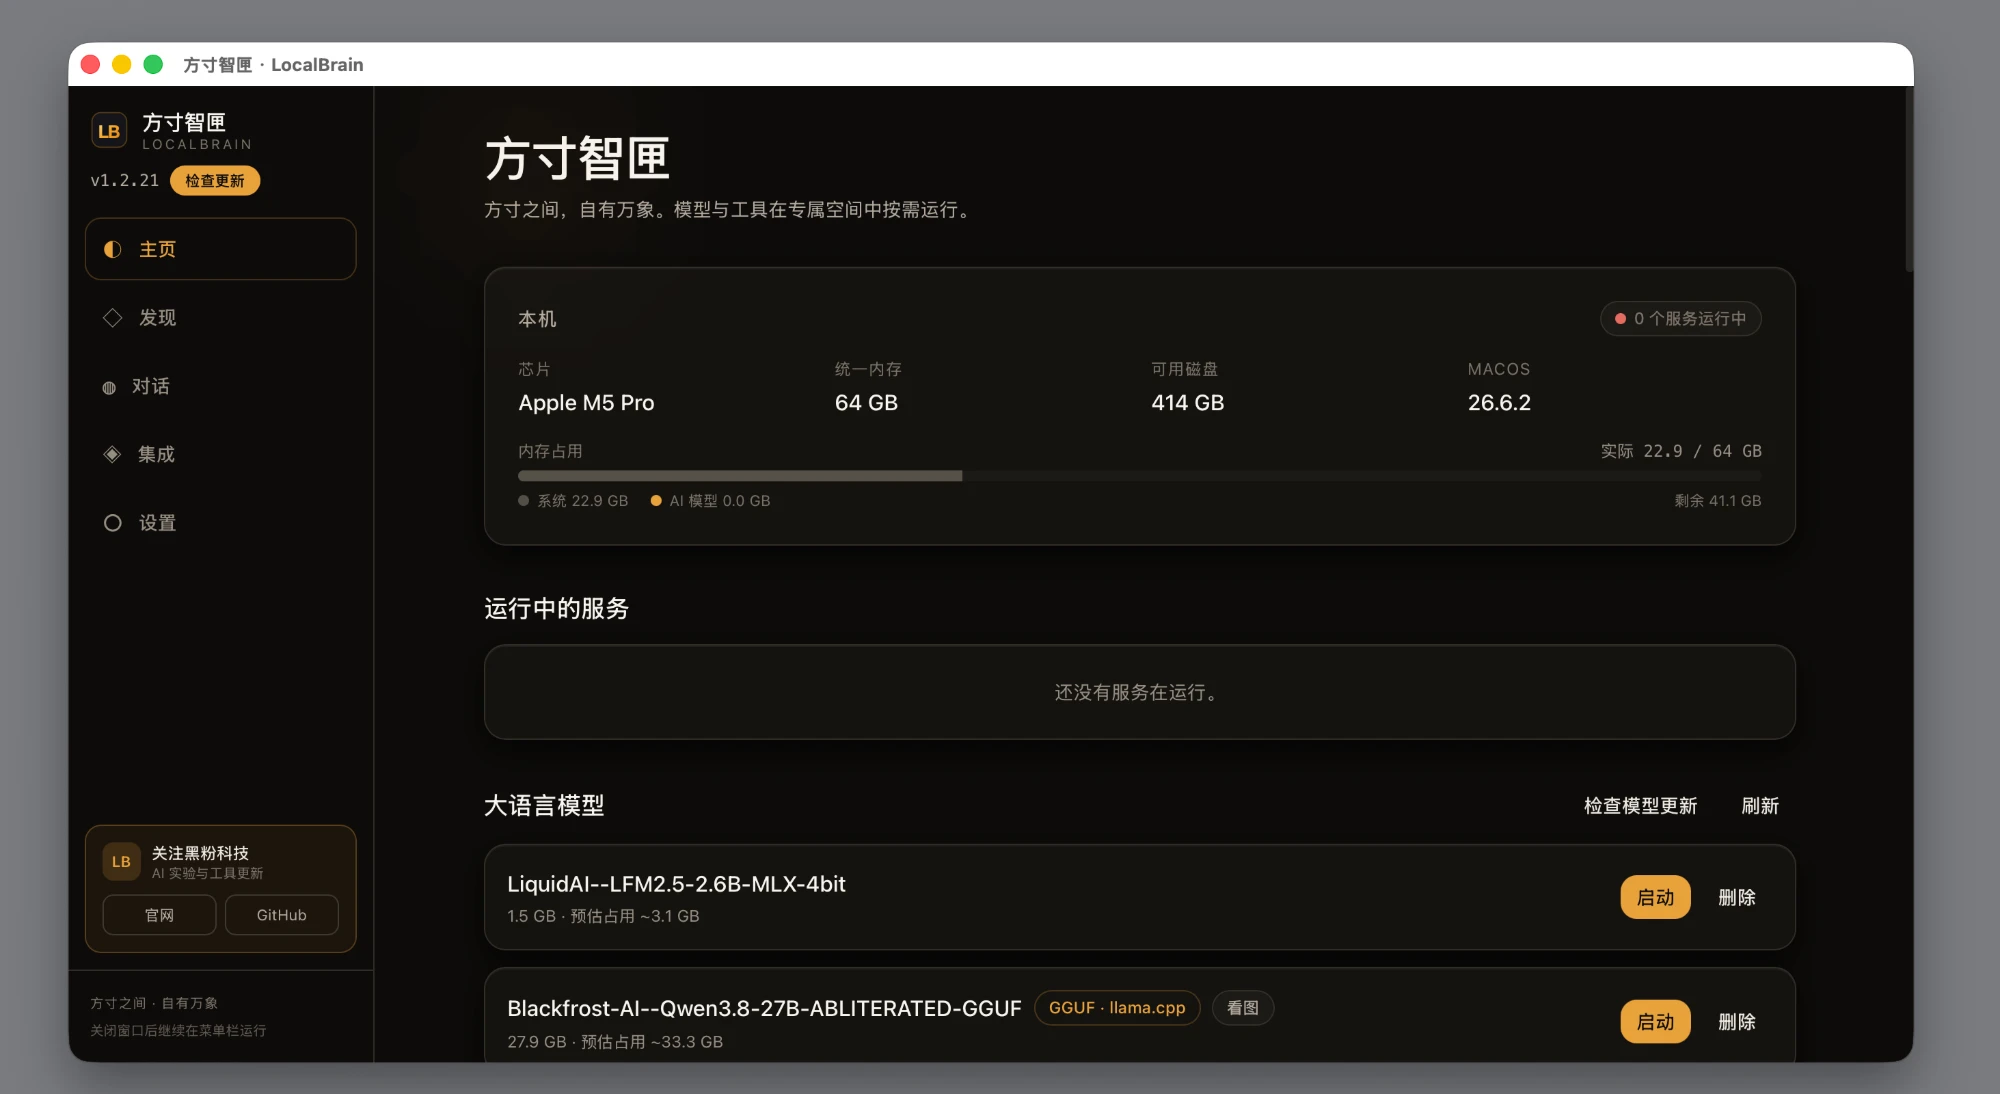
所以我把目标改了:不造一个更聪明的大脑,而是造一个更省心的本地 AI 总开关。 现在的 LocalBrain 1.2.22 已经能在同一个应用里完成硬件检测、模型下载与引用、启停、对话、工具调用和文件交付。
提示 LocalBrain 的定位不是替代 Codex、Claude Code 或 OpenCode,而是给它们和内置对话提供一组可控、按需启动、尽量留在本机的模型与工具。
▍它不是又一个聊天框,而是本地 AI 的调度台
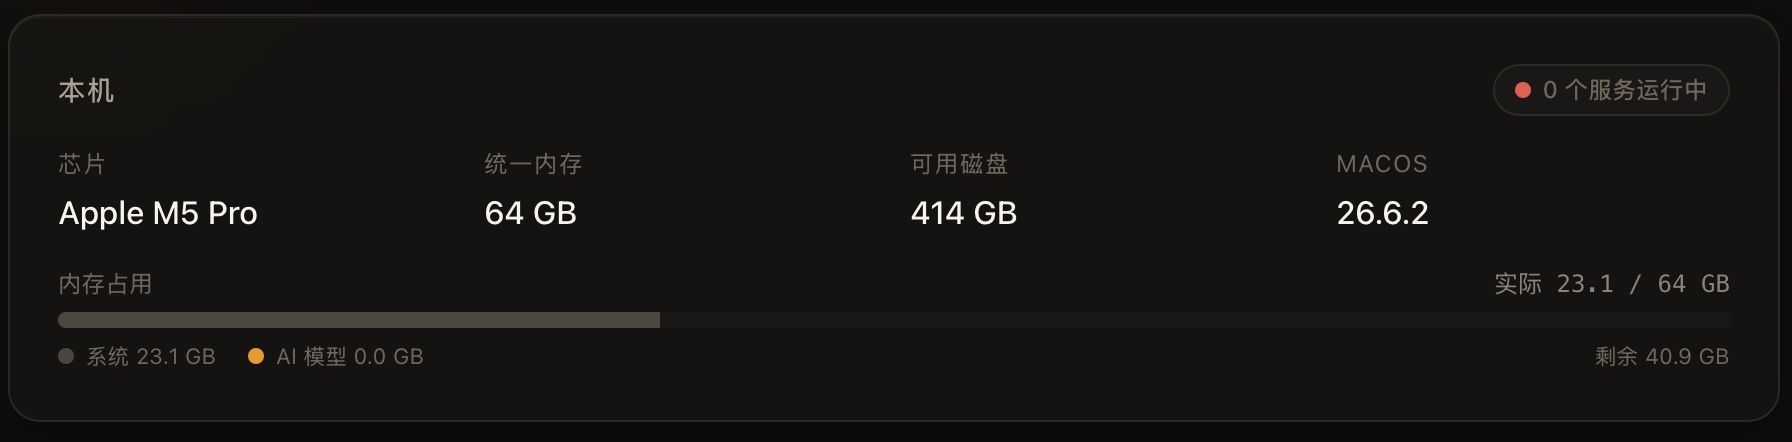
打开软件后,LocalBrain 先读取 Apple Silicon 型号和统一内存,再给出模型、量化、上下文和输出量建议。启动模型前,内存仲裁会把已运行后端和待启动模型放在一起估算,资源不够就明确拒绝,而不是先把系统撑爆再报错。
| 本机条件 | 适合做什么 | 需要注意 |
|---|---|---|
| 8 GB 统一内存 | 小型语言模型、轻量转写 | 不适合并行跑多个大后端 |
| 16 GB 及以上 | 日常聊天、代码、文档与常规多媒体 | 模型大小和上下文仍然要算账 |
| 48 GB 及以上 | 本地 MiniMax H3 视频生成 | 生成时间和散热取决于芯片与参数 |
※ 这是产品边界,不是“内存越大就一定更快”的性能承诺。
▍模型不用搬家,下载也不用押宝单一线路
大模型动辄几十 GB,为了让一个应用“看见”它,再复制一份是最笨也最贵的方法。LocalBrain 可以把任意目录加进外部模型库,只读递归识别,不复制、不移动、不写标记。Ollama 模型清单、LM Studio 的标准 Hugging Face 目录和 GGUF 都有对应的识别路径。
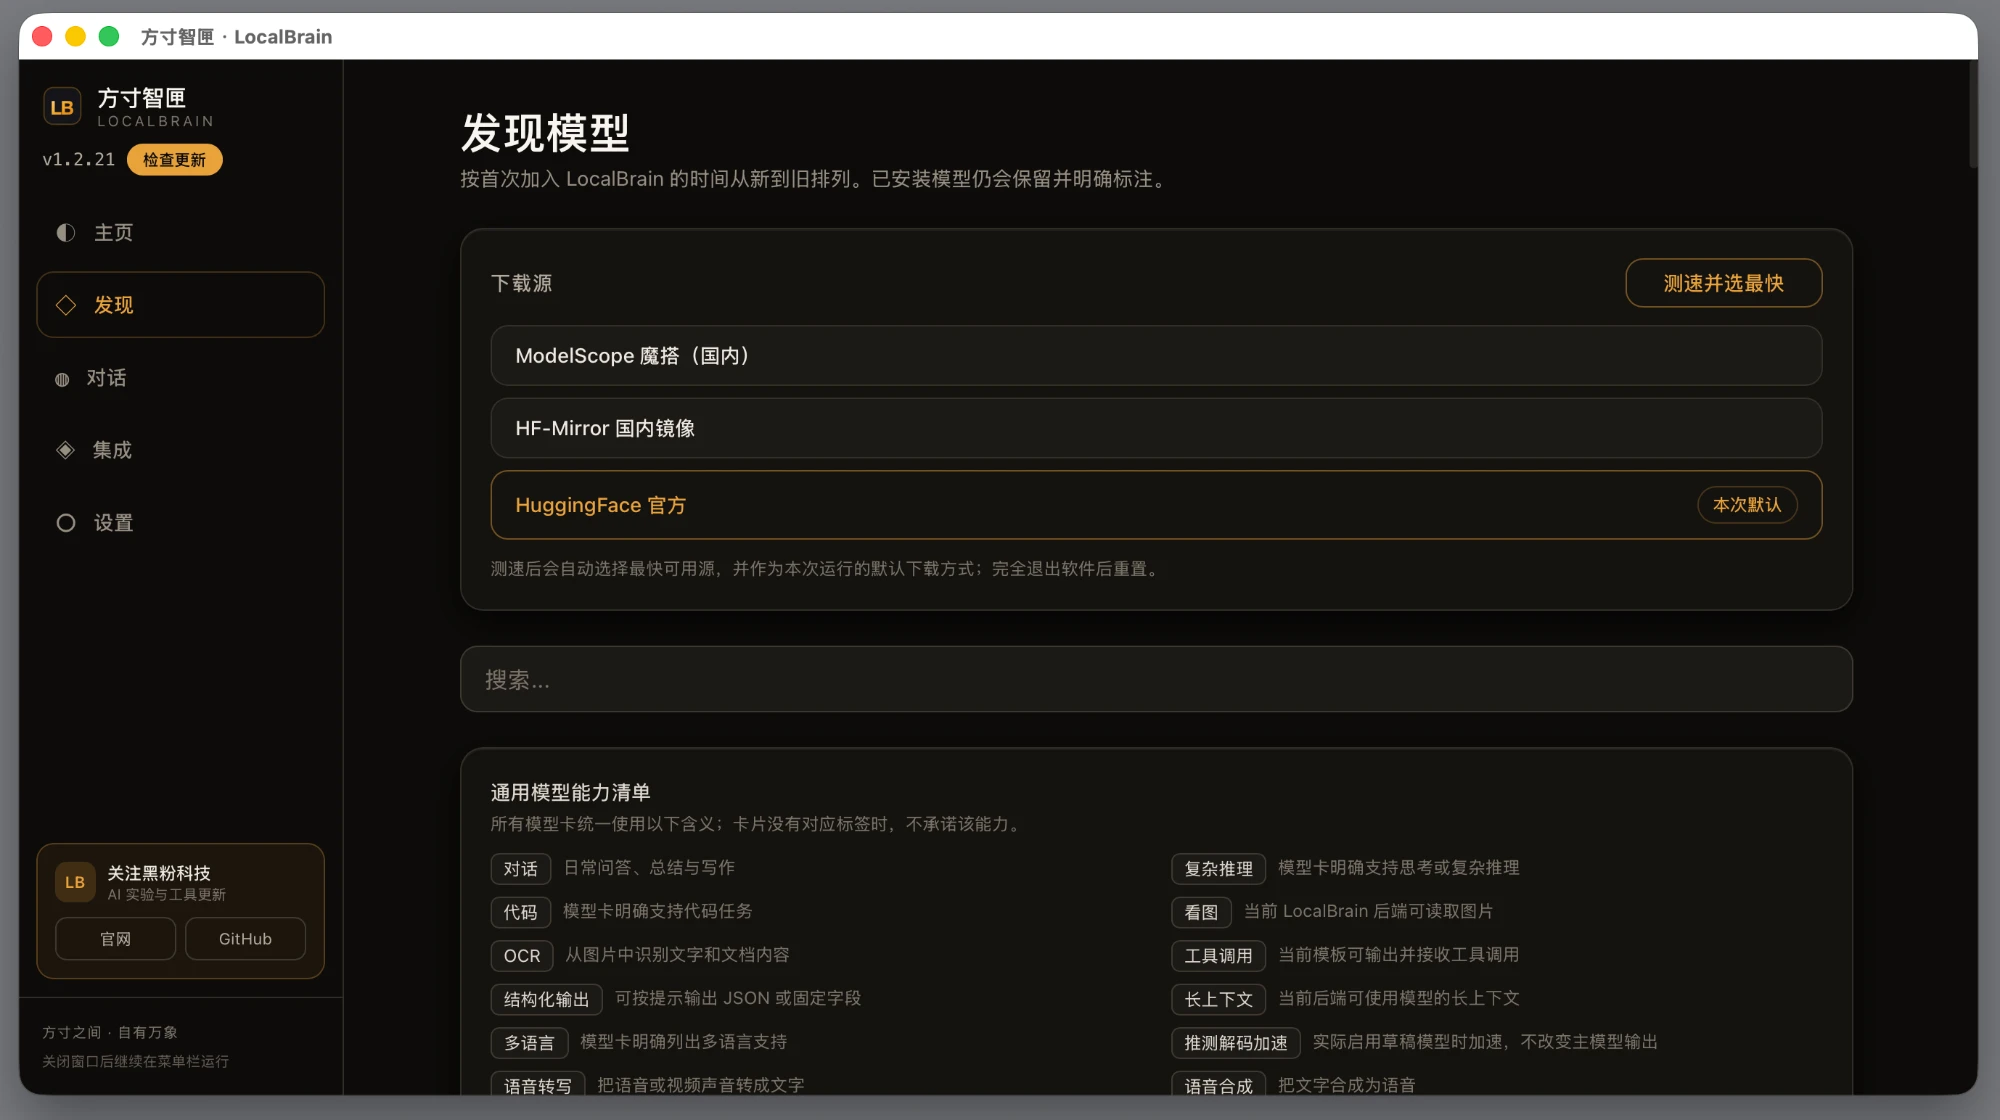
如果需要新下载,发现页会在 ModelScope、HF-Mirror 和 Hugging Face 官方之间测速,选当次可用且更快的来源。大文件断流会尝试续传和重连,下载结束后再做 SHA-256 校验;“体积看着对”但内容损坏的文件不会被当成成功。
提示 识别到不等于一定能启动。 格式、模型架构、视觉投影文件和当前运行时都会影响兼容性;软件会尽量给出具体原因,不把“扫到了”包装成“肯定能跑”。
▍真正的分水岭:从回答一句话,到交付一个文件
内置对话支持流式输出、附件、停止、重试、会话持久化和本地工具。但我更在意的不是这些聊天基础功能,而是你能否直接说“搜索最新资料,整理成表格和 PPT”,然后真的拿到可编辑的 PPTX、DOCX、XLSX 或 PDF。
文档任务使用同一个模型驱动循环,按需执行搜索、阅读、撰写、生成和自检。界面会展示每轮工具调用,完成后回读产物路径。如果没有真实生成文件,零产物闸门会拒绝把任务报成“已完成”。
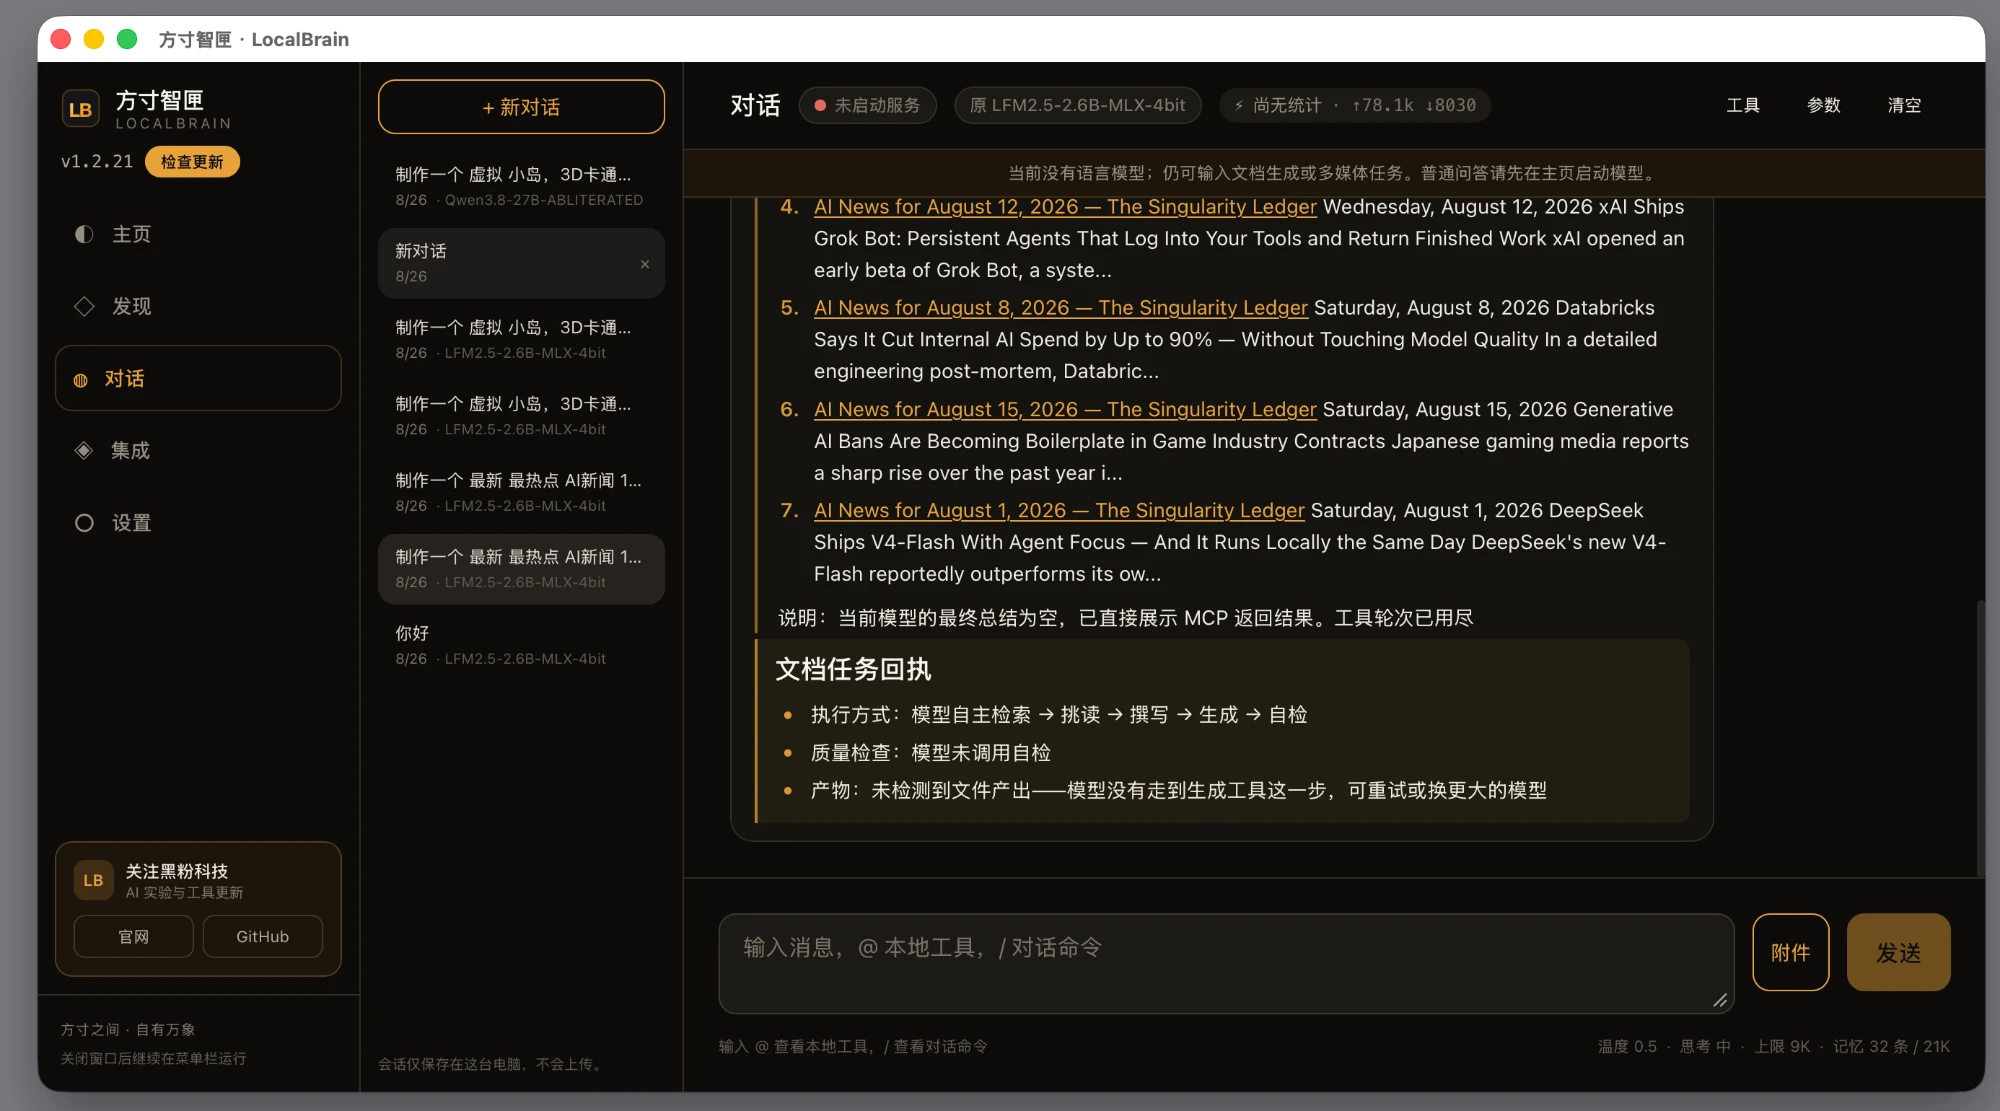
| 你交给它的任务 | 可能调用的本地能力 | 应该看到的结果 |
|---|---|---|
| 搜索资料并做演示 | WebMiner + DocFactory | 来源、PPTX 和质量检查回执 |
| 把录音整理成文稿 | Parakeet / Qwen3-ASR / Whisper | 转写文本或后续文档 |
| 生成配图、配音或视频 | 图像 / TTS / MiniMax H3 | 真实存在的媒体文件 |
▍多模态不是一排图标,而是能被 Agent 调用的本地工具
1.2.22 新增 Parakeet TDT 0.6B v3、Qwen3-ASR 0.6B 和 Devstral Small 2 24B。前两者已接入本地 MLX Audio 语音识别链路,同时保留 Whisper 兼容;Devstral 按纯文本代码代理收录,主要面向工具调用和长上下文任务。
语言模型之外,软件还管理 TTS、Z-Image、图片编辑、音乐和本地 MiniMax H3 视频生成。H3 支持纯文字、首帧、首尾帧与分段拼接,并由本地桥接层把画面和音频封装成视频文件。这条本地路径不依赖托管的 H3-Context-IR 审核调用,但运行速度和可用分辨率仍然受本机硬件限制。
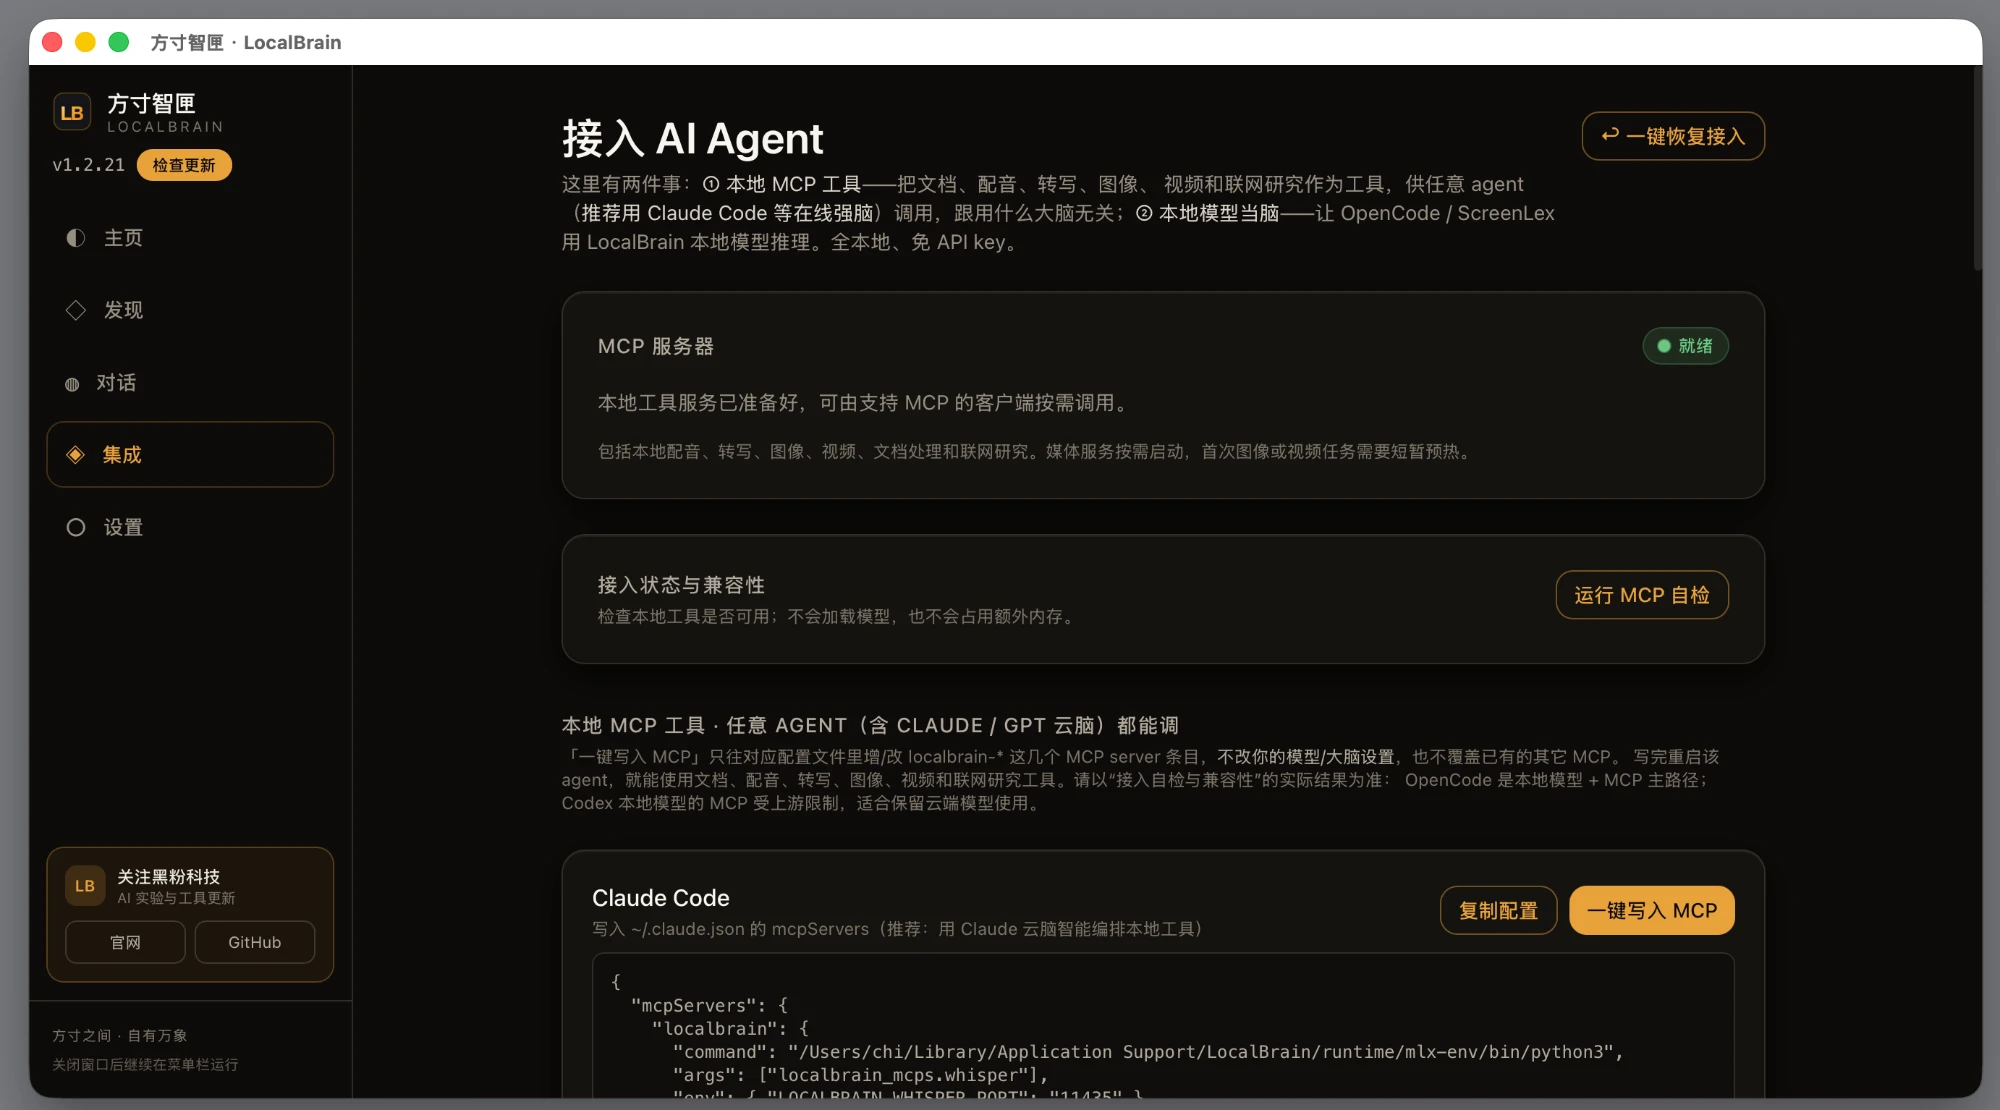
OpenCode 和 ScreenLex 可以直接使用 OpenAI 兼容的 Chat Completions 端点。Codex 和 Claude Code 更稳的用法,是保留它们的云端推理模型,只通过 MCP 调用 LocalBrain 的转写、配音、图像、视频和网页工具。LocalBrain 能提供接口和工具,但不能替第三方客户端解除它自身的模型或工具限制。
▍“私有”的边界:哪些留在 Mac,哪些仍然会联网
本地推理、转写和媒体生成可以留在 Mac 上,并且各后端按需启停。但“本地 AI”不等于“所有操作永远断网”:下载模型会访问模型源,WebMiner 会把查询发到搜索引擎,Codex 或 Claude Code 如果使用云端模型,其推理也不在本机。
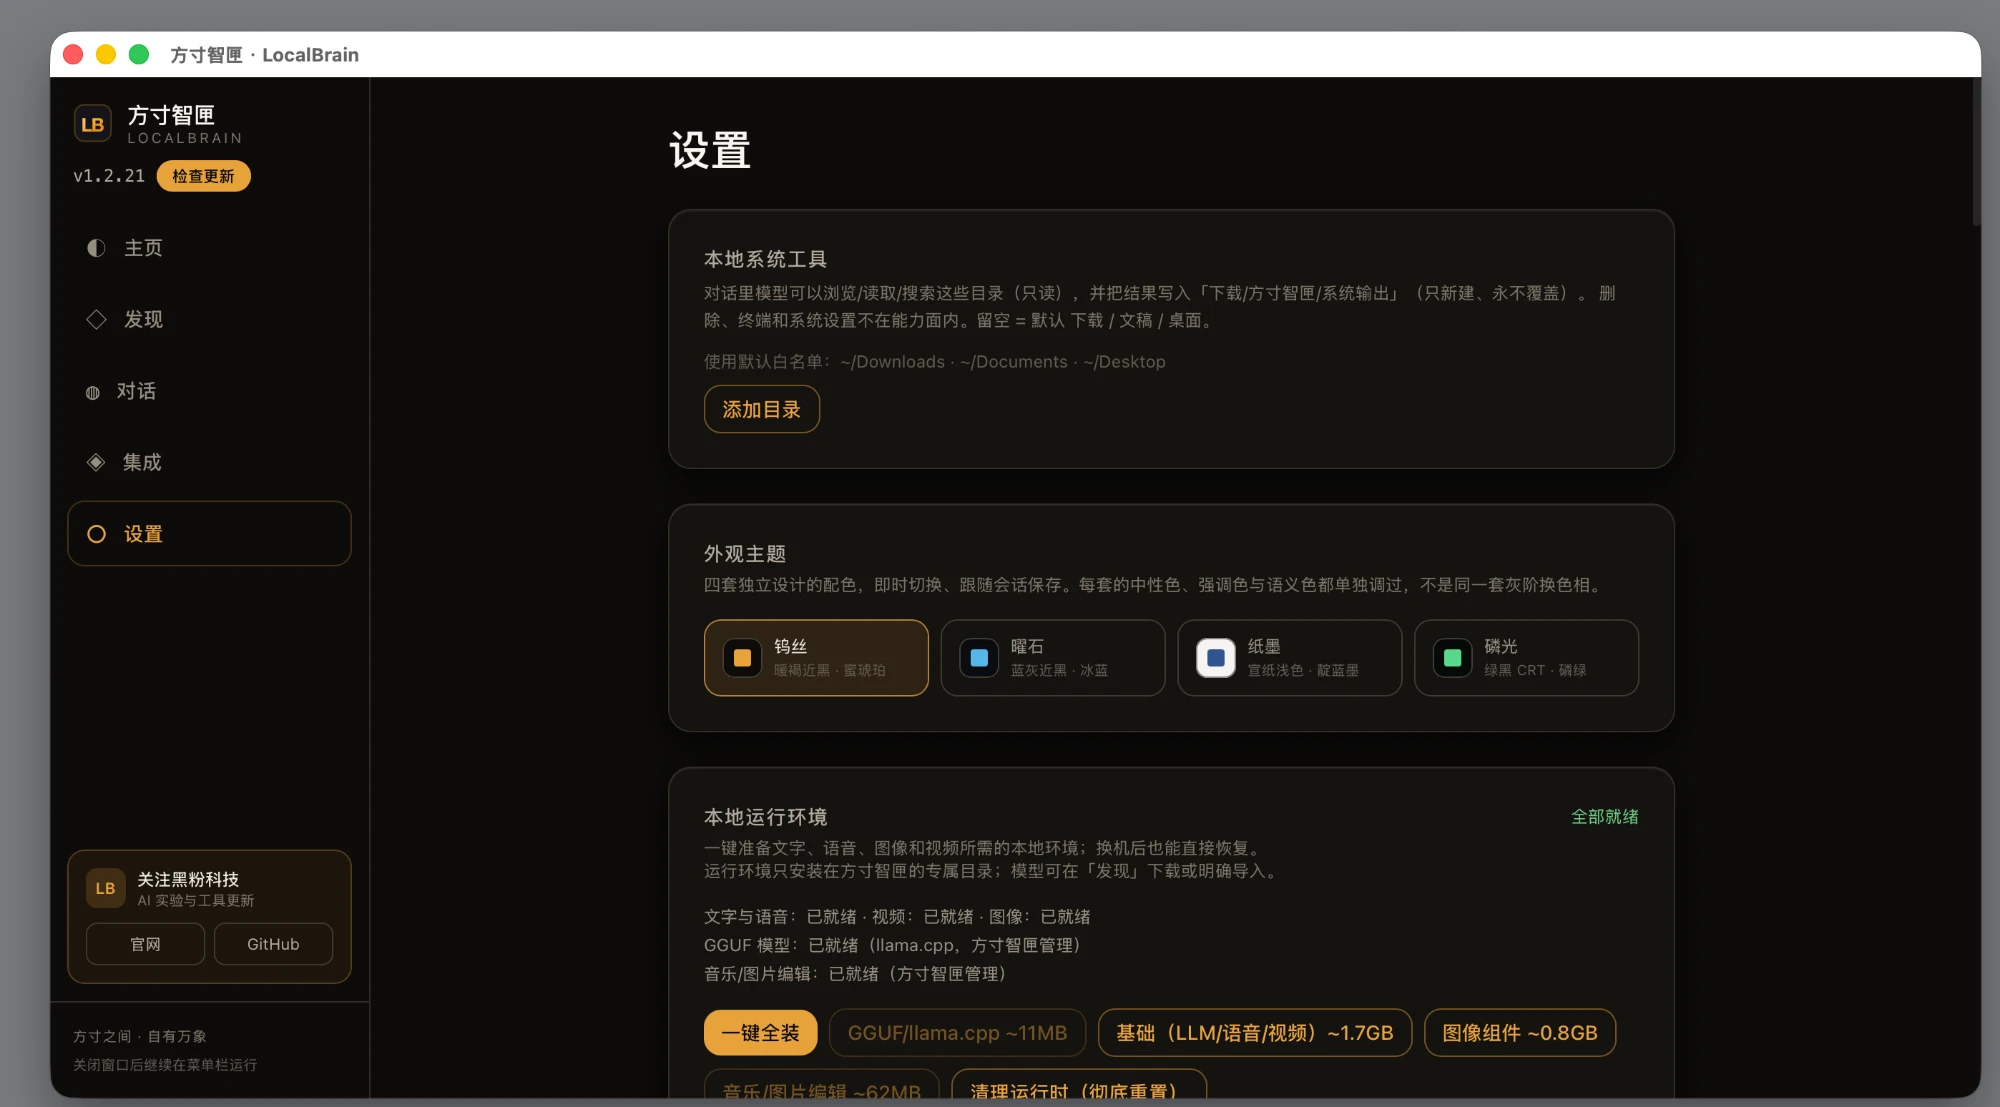
文件工具默认只能读取你允许的目录,并将结果写入专属输出位置;它没有通用终端和删除能力。这些限制不是功能没做完,而是故意把能力面收窄。私有不是一个标签,而是你能看清数据去向、授权目录和后端生命周期。
| 如果你是这种情况 | 我的建议 |
|---|---|
| 本机已散落多套 MLX、GGUF、语音或媒体模型 | 适合,统一目录引用、启停和资源管理 |
| 想让 OpenCode 或云端 Agent 调本地多媒体工具 | 适合,使用集成页的一键写入或复制配置 |
| 只有一两个 Ollama 模型,偶尔问几句 | 未必需要再加一层管理 |
| 期待本地小模型在所有任务上替代顶级云模型 | 不适合,本地的优势是控制、隐私和可复用,不是所有能力都更强 |
▍四步上手,先把安装包和边界核对清楚
-
从 GitHub Releases 下载最新 DMG,把 LocalBrain.app 拖入“应用程序”。
-
打开后先看硬件检测和模型推荐,不要只根据参数量猜内存。
-
在“发现”下载一个适合本机的模型,或先把现有模型目录以只读方式引入。
-
回到主页启动,然后用内置对话测一次;需要外部 Agent 时再去“集成”页写入配置。
LocalBrain 1.2.22
方寸智匣:把 Mac 上的本地模型、多媒体、文档和 MCP 工具收进同一个工作台。
提示 平台 macOS 13.0+ / Apple Silicon · 内存 8 GB 最低,16 GB+ 建议;视频生成 48 GB+ · 安装包 LocalBrain_1.2.22_aarch64.dmg
最新安装包
https://github.com/HackerChi-Hub/localbrain-releases/releases/latest
产品介绍
https://hyphentech.top/localbrain
当前安装包的 SHA-256 是 80d0ab6617ccf0a7ccc639413beaaafe85c52095e32fcf2d4b4b73efc2d83bb6。它使用开发签名,尚未完成 Apple 公证;首次打开被 Gatekeeper 拦截时,先确认下载来源和哈希,再用下面的命令移除隔离属性。
xattr -dr com.apple.quarantine /Applications/LocalBrain.app
只对从官方 Releases 下载且已核对哈希的安装包使用。
// 云端模型负责把复杂问题想明白,本地工具负责把你的文件、模型和工作流握在自己手里。这两件事不冲突。
提示 最后的选择很简单
如果你的本地模型和工具已经多到开始反过来管理你,LocalBrain 能省下的就不只是几条命令,而是每次重启、换模型、换任务时重复折腾的时间。如果你只需要偶尔聊几句,保持现在的简单工具就好。
🧰 我做的工具
这些工具都由我持续维护。预览版会明确标注,下载、更新和已知边界以发行页为准。
信息:黑粉剪辑 HyphenCut 状态: 初步构建 · 预览版
Rust 写的本地专业视频剪辑:达芬奇键位、AI 助理直接改真实工程,免费
信息:黑粉盒子 HyphenBox 状态: 初步构建 · 预览版
免费大模型 API 雷达:持续复测可用性,本地统一接口,Key 只存本机
信息:方寸智匣 LocalBrain 状态: 正式迭代
本地模型的多模态 MCP 工具箱:TTS / Whisper / 视频生成一站接入
信息:ScreenLex 光影词库 状态: 正式迭代
看美剧顺手把生词背了,Mac/Windows 双平台,免费
信息:黑粉录屏 HyphenScreen 状态: 初步构建 · 预览版
录屏 + 智能剪辑一体:达芬奇式时间线、自动打码、导出前成片体检,免费
引用:黑粉科技 让AI成为你的超能力 本地部署 · 免费白嫖 · 自制软件 https://hyphentech.top