先把边界说清:它是求职操作台,不是自动投递机
career-ops 是一个开源 AI 求职项目,运行在 Claude Code、Codex、OpenCode 等 AI 编程客户端所在的本地项目目录里。按照作者说明,它可以读取职位描述和个人简历,检查职位是否仍开放,评估匹配程度,生成针对职位的简历、求职信和面试准备材料,再把申请状态写入跟踪表。
可以把它理解成一张放在自己电脑上的求职工作台:职位描述像新到的快递,career-ops 负责核对收件信息、按重要程度分拣,并把需要处理的材料摆好;但最后要不要收件、材料是否准确、提交按钮什么时候按,仍由求职者决定。
一次完整流程能交付什么
| 环节 | 作者声明的交付物 | 仍需人工确认 |
|---|---|---|
| 职位筛选 | 检查职位状态,按照简历给出1—5分匹配评价,并整理差距与申请建议 | 职位是否值得投入,以及评分是否符合个人实际选择 |
| 申请材料 | 生成针对职位的简历、求职信、申请表答案和PDF文件 | 事实、数字、职位名称和措辞是否准确 |
| 公司与面试准备 | 整理公司信息、联系人线索、面试故事和准备计划 | 信息是否可靠,沟通对象是否合适 |
| 申请管理 | 记录申请状态,分析拒绝模式并提示跟进事项 | 状态是否真实更新,建议是否符合当前求职目标 |
功能范围来自项目README和技能入口文档,尚未进行本机运行验证。
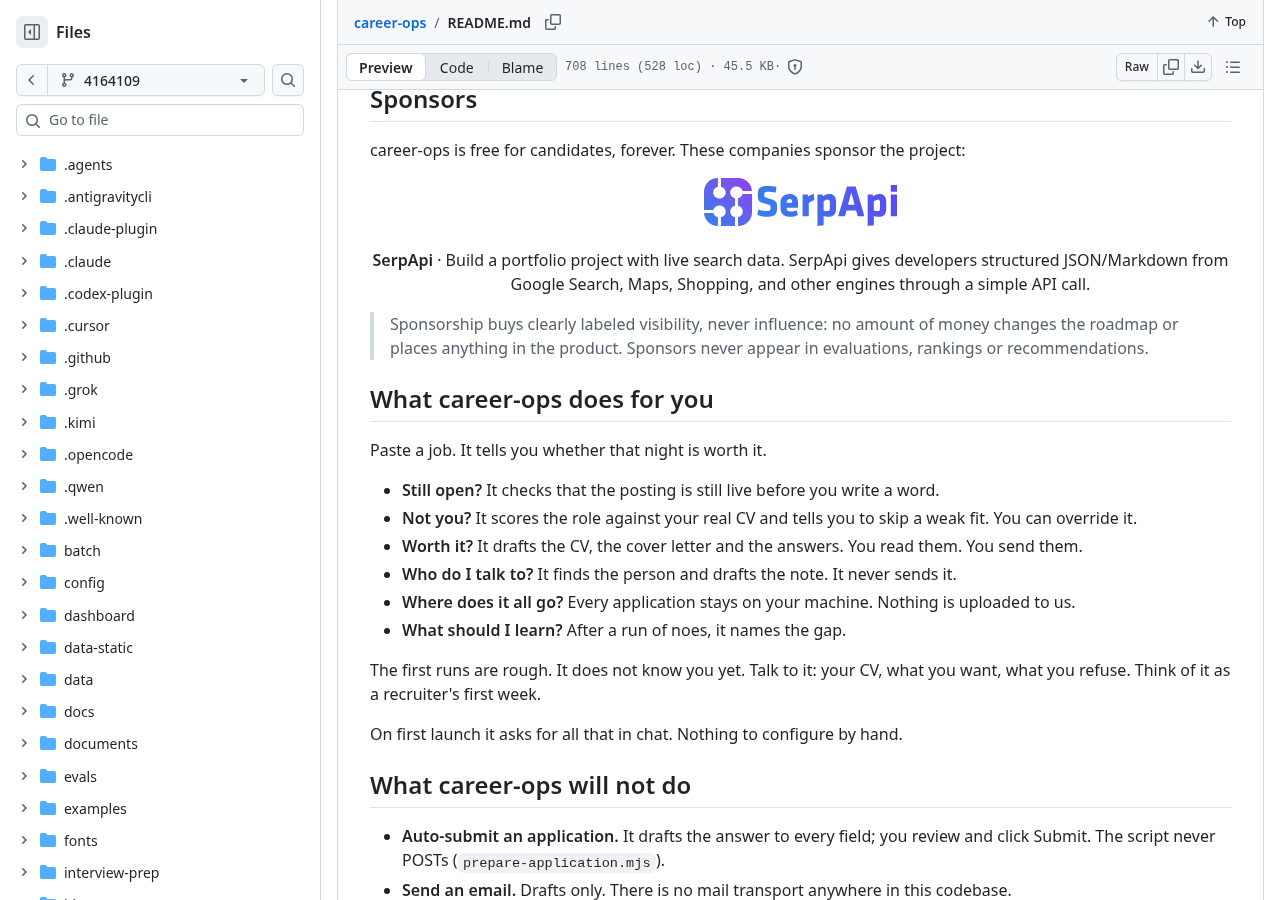
这套流程的重点不是“海投更多”,而是先判断一个职位值不值得投入。项目会给出建议,也允许用户覆盖建议;评分只是辅助筛选,不能把招聘结果变成可以精确计算的答案。
它故意不替你做哪一步
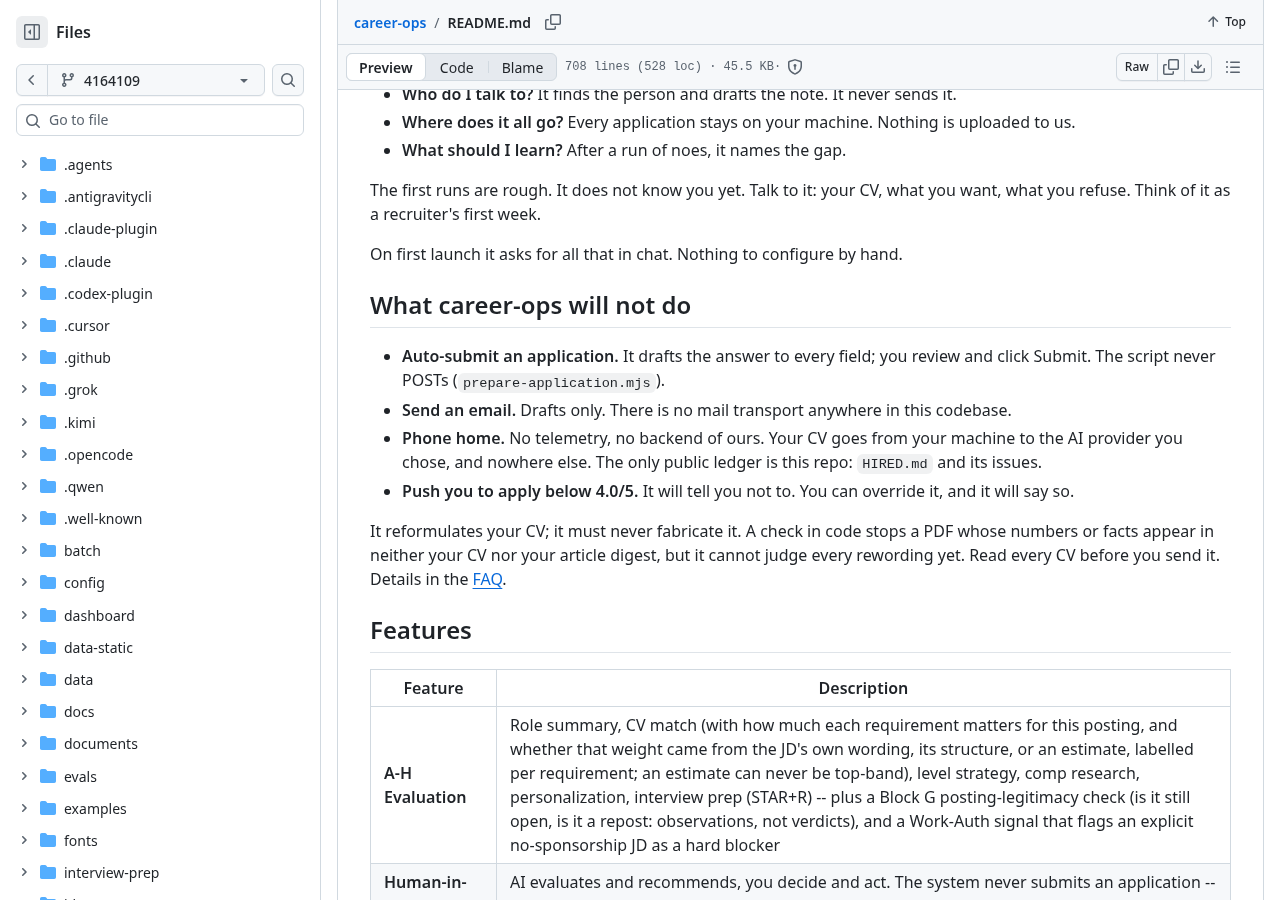
项目明确保留人工确认:它可以起草申请字段和联系邮件,但不会自动提交职位申请,也不会发送邮件。这样的限制会牺牲一点速度,却避免 AI 在无人检查时把错误经历、夸大的能力或不合适的措辞直接送到招聘方手里。
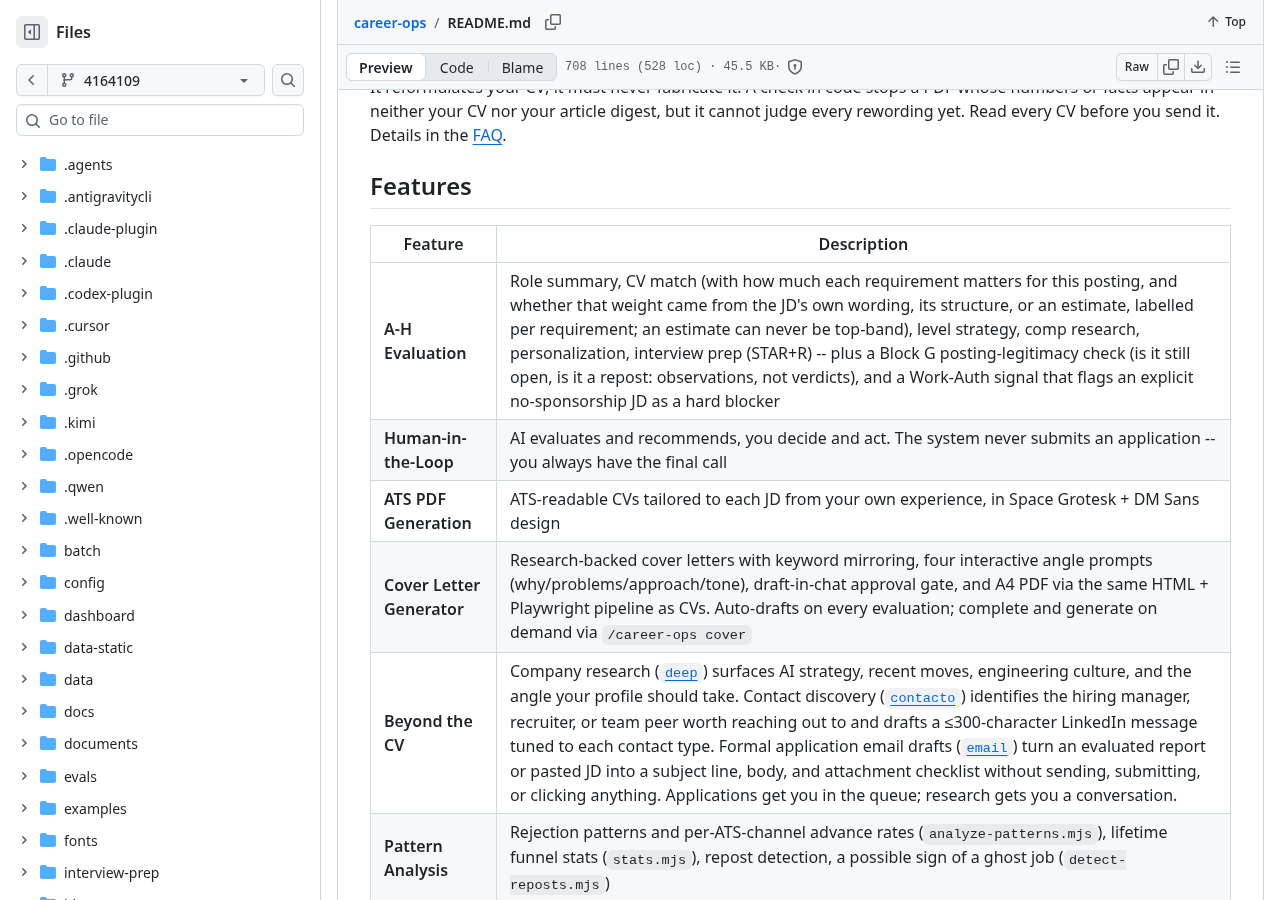
警告 作者说明,程序会阻止部分来源中不存在的数字或事实进入PDF,但目前不能完整判断每一次改写,也尚未覆盖所有职位名称问题。任何生成的简历、求职信和申请答案都应逐项复核,不能把程序检查当成事实担保。
哪些客户端和环境可以使用
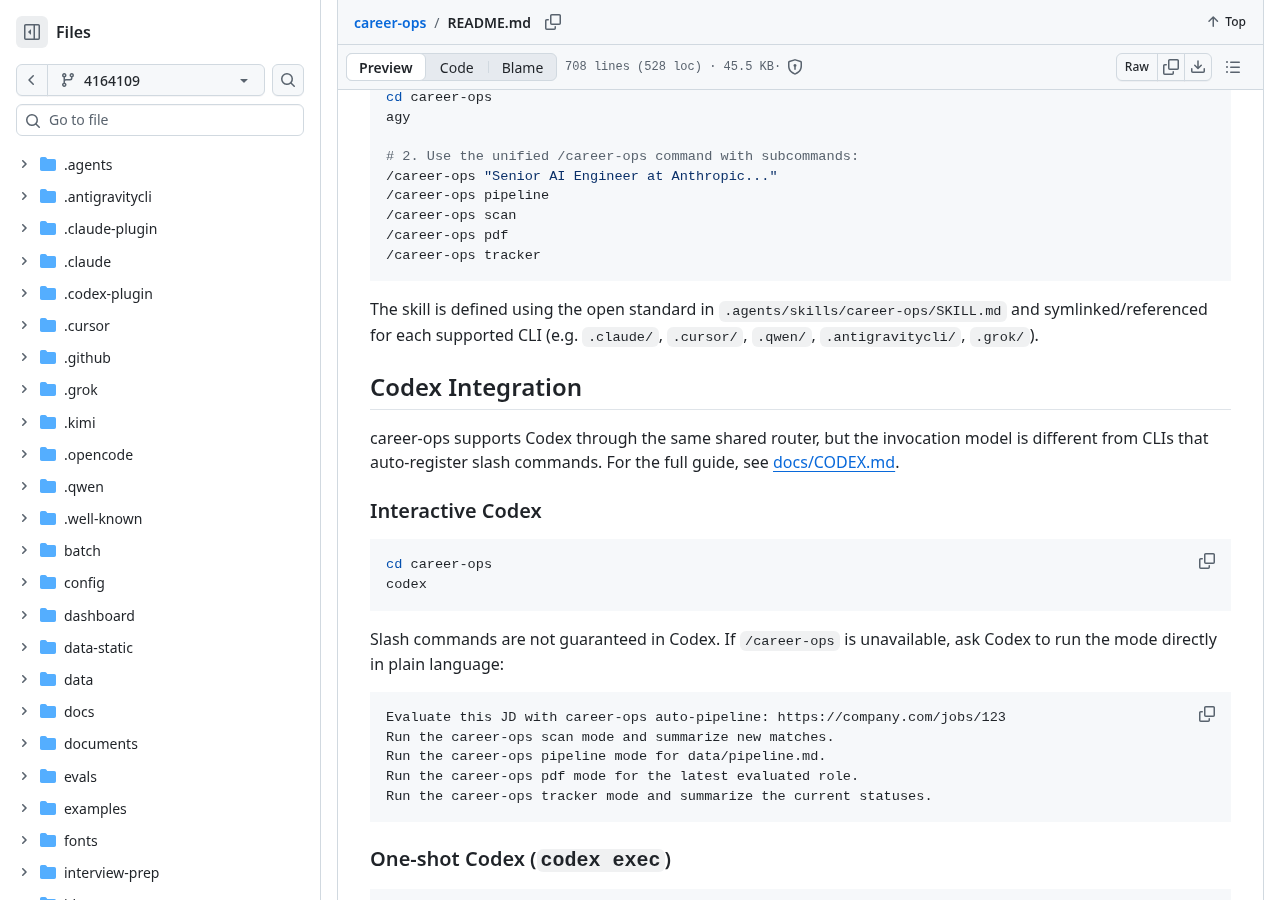
作者声明 career-ops 采用共享的 Agent Skill 入口,可配合 Claude Code、Codex、OpenCode、Qwen、Grok、Pi 等客户端。Codex 的斜杠命令不保证可用,项目建议直接用自然语言指定 scan、pipeline、pdf 或 tracker 等模式。这是项目方给出的兼容范围,不代表所有客户端和系统组合都已经独立跑通。
- 基础安装和多数脚本依赖 Node.js。
- 生成PDF需要 Playwright 和 Chromium;非 Debian、Ubuntu 的 Linux 环境可能还要自行补齐系统库。
- 终端仪表盘采用 Go、Bubble Tea 和 Lipgloss,属于额外界面能力,并非完成单次职位评估的必要条件。
- AI 能力来自用户选择的编程客户端、模型服务或本地模型;项目本身不等于附送一个不限量模型。
- Gmail、Notion、Apify 等插件属于可选集成,默认关闭。
怎样开始,才不会一上来就把流程搞复杂
项目的固定提交版README提供了基于 npx 的初始化入口,也保留手动安装方式。首次尝试更适合从一个真实职位开始:先确认文本评估是否能正确引用简历,再决定是否启用PDF、批量扫描和外部集成。仓库与安装说明可从 career-ops 固定提交版README 查看。
- 准备一份准确的简历,以及目标职位、拒绝条件和工作偏好。
- 先输入一个职位描述或职位链接,检查评分依据有没有对应到简历中的真实内容。
- 文本报告通过后,再检查定制简历和PDF能否被正常打开、复制和检索。
- 确认跟踪表写入的位置和内容,再考虑扫描多个招聘网站或批量处理。
- 涉及个人资料和模型服务时,先确认数据实际会发往哪里。
免费的是代码,不一定是整条求职链
career-ops 的代码采用 MIT 许可证,项目方也表示候选人可以免费使用,并提供免费模型和本地模型的运行说明。但公开代码不等于全流程没有成本:所选 AI 客户端、模型接口、搜索数据服务和可选插件可能存在额度、订阅或调用费用。当前资料没有给出一套适用于所有组合的固定成本,因此不能把“开源”直接翻译成“所有功能永久免费且不限量”。
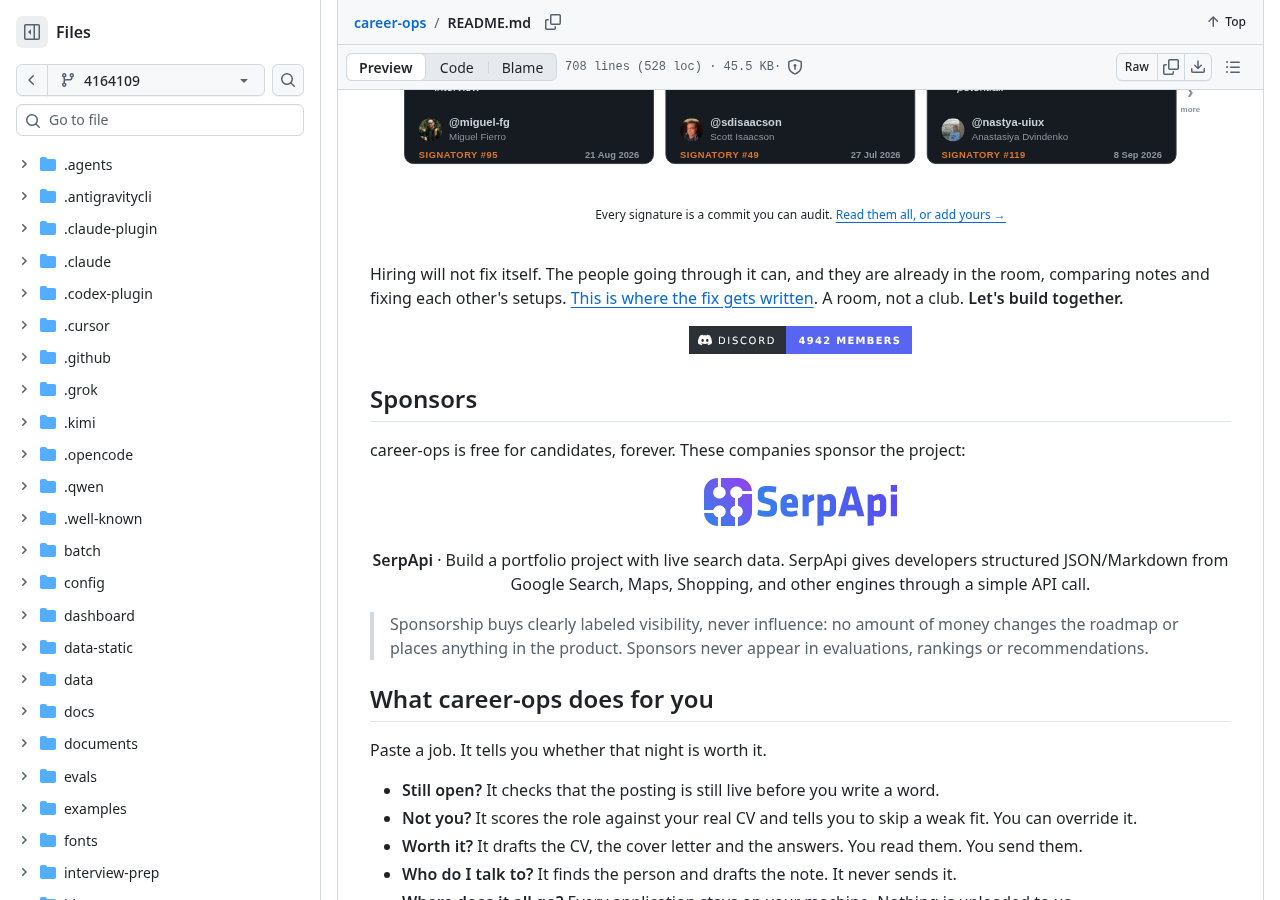
本地运行也不等于数据完全不出电脑
项目没有自己的遥测和托管后端,简历、报告与申请跟踪文件默认保存在本地。不过,README同时说明,简历内容会直接发送给用户选择的 AI 提供商。只有使用经过核实的本地模型和本地流程,才可能进一步减少外发;具体隐私边界仍取决于模型、搜索服务和启用的插件。
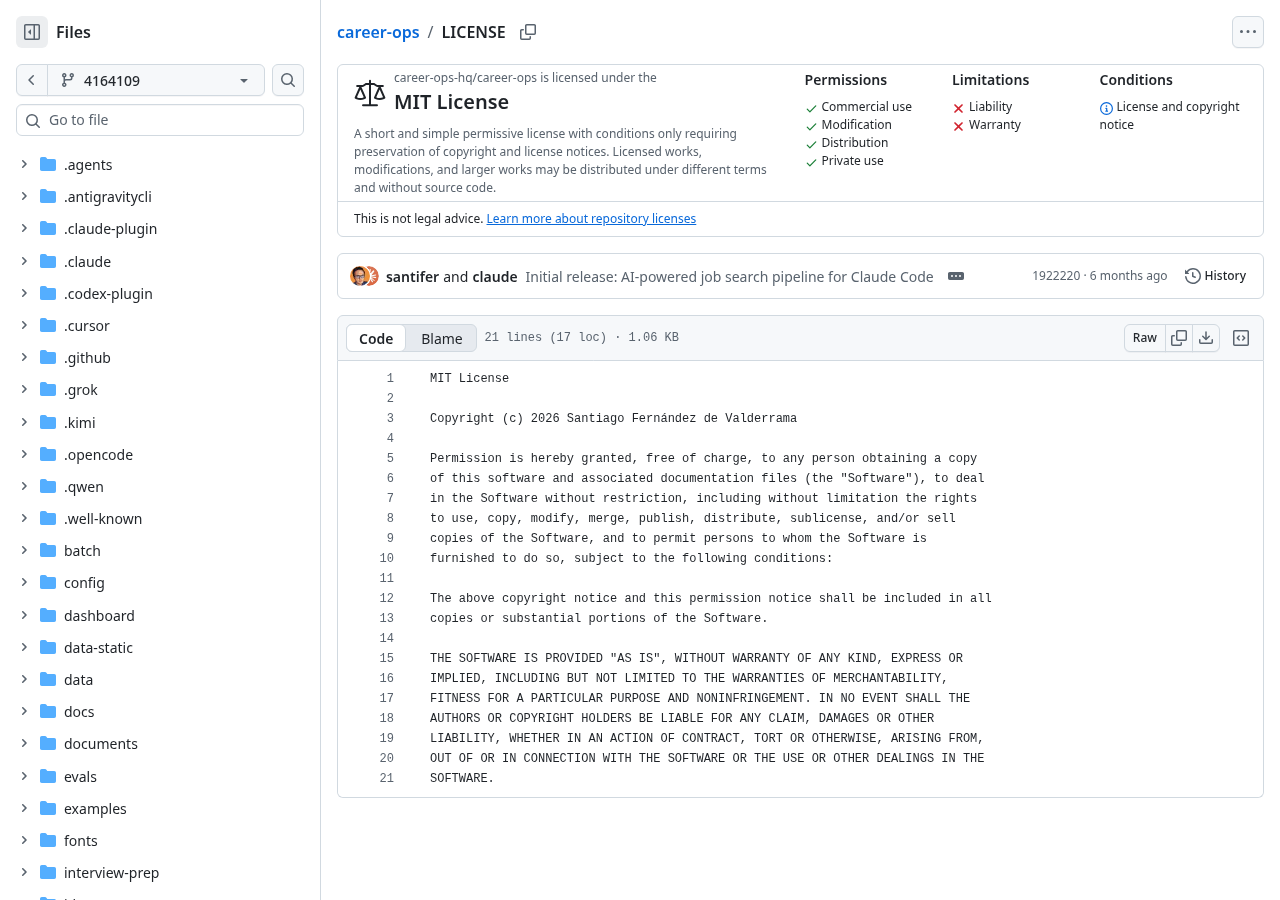
MIT 许可证之外,还有名称和素材边界
MIT 许可证允许使用、复制、修改、合并、发布和再分发代码,但需要保留版权与许可声明,并且软件按“原样”提供、不附带担保。项目还单独声明了 career-ops 名称和品牌的商标政策:代码许可较宽松,不代表可以随意把项目名称用于商业产品命名或制造官方背书。
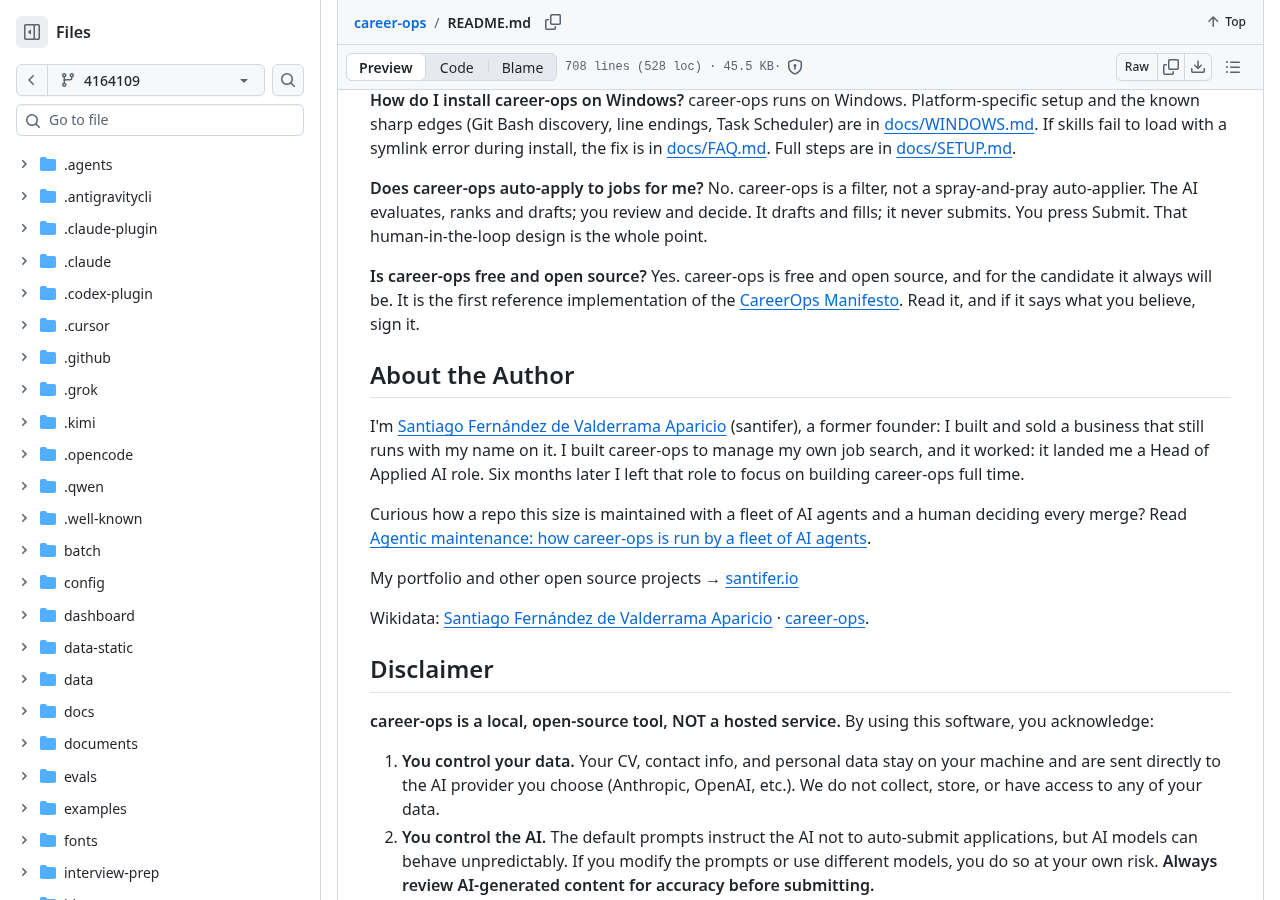
作者样片和仓库热度能证明什么
作者在README中记录了自己的求职过程:评估740个职位、申请68个、获得12次面试和1个录用,并展示了西班牙语界面样片。这能说明作者围绕真实求职流程设计了项目,却不能证明其他行业、地区和简历条件下会得到相同结果;样片也不是独立实测产物。
2026年10月8日的仓库快照记录为73,769个星标、13,858个分叉;基线为73,673个星标,1.02天增加96个,约94.0个星标/天,最近一次推送时间为2026年10月8日07:28:51 UTC,许可证为MIT。它说明项目仍有维护活动和关注度,但不能替代安全审计、跨客户端兼容测试或实际求职效果验证。
什么人值得用
- 适合:已经在使用AI编程客户端,愿意维护本地文件,并且需要反复筛选职位、改写材料和跟踪申请的人。
- 适合:更看重少投、精投,希望每份材料都能回到真实简历证据的人。
- 暂时不适合:只想一键自动海投、不愿检查生成内容,或者不想进行任何本地环境配置的人。
- 需要谨慎:简历不能发送给任何外部模型服务的人。选择前应先核实本地模型路线、插件状态和实际数据流向。
最小验收办法很简单:只给它一个真实职位,检查评分是否引用了正确经历、材料有没有编造事实、PDF是否可读、跟踪状态是否准确,以及个人数据发往了哪里。五项都说得清,再把它扩展成长期求职工作台;其中任何一项含糊,都不该直接进入批量申请。
项目一手资料
🧰 我做的工具
这些工具都由我持续维护。预览版会明确标注,下载、更新和已知边界以发行页为准。
黑粉盒子 HyphenBox
正式迭代。免费大模型 API 雷达:持续复测可用性,本地统一接口,Key 只存本机
方寸智匣 LocalBrain
正式迭代。本地模型的多模态 MCP 工具箱:TTS / Whisper / 视频生成一站接入
ScreenLex 光影词库
正式迭代。看美剧顺手把生词背了,Mac/Windows 双平台,免费
黑粉录屏 HyphenScreen
正式迭代。录屏 + 智能剪辑一体:达芬奇式时间线、自动打码、导出前成片体检,免费
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取
留言
正在加载留言…