和 ChatGPT 聊出一个脚本,离一条精彩的视频还有多远?中间至少隔着配音、字幕、画面、剪辑和成片检查。脚本讲得清楚,只解决了“说什么”;观众能不能看懂,还要看画面是否跟着解释走、字幕是否对得上声音、最终文件是否真的能播放。
岚叔的 lanshu-create-ai-presenter-video 提供了一种把脚本继续做成视频的办法:把制作步骤、检查脚本和模板交给能读文件、执行命令的 AI 助手。作者列出的客户端包括 Codex。这篇介绍的是这套工作流,不是 ChatGPT 网页聊天里已验证的一键成片功能;在具体客户端能否执行,还取决于工具权限和制作环境。本次没有独立跑完项目,因此下面区分作者声明与可以据此作出的判断。
它实际能交付什么
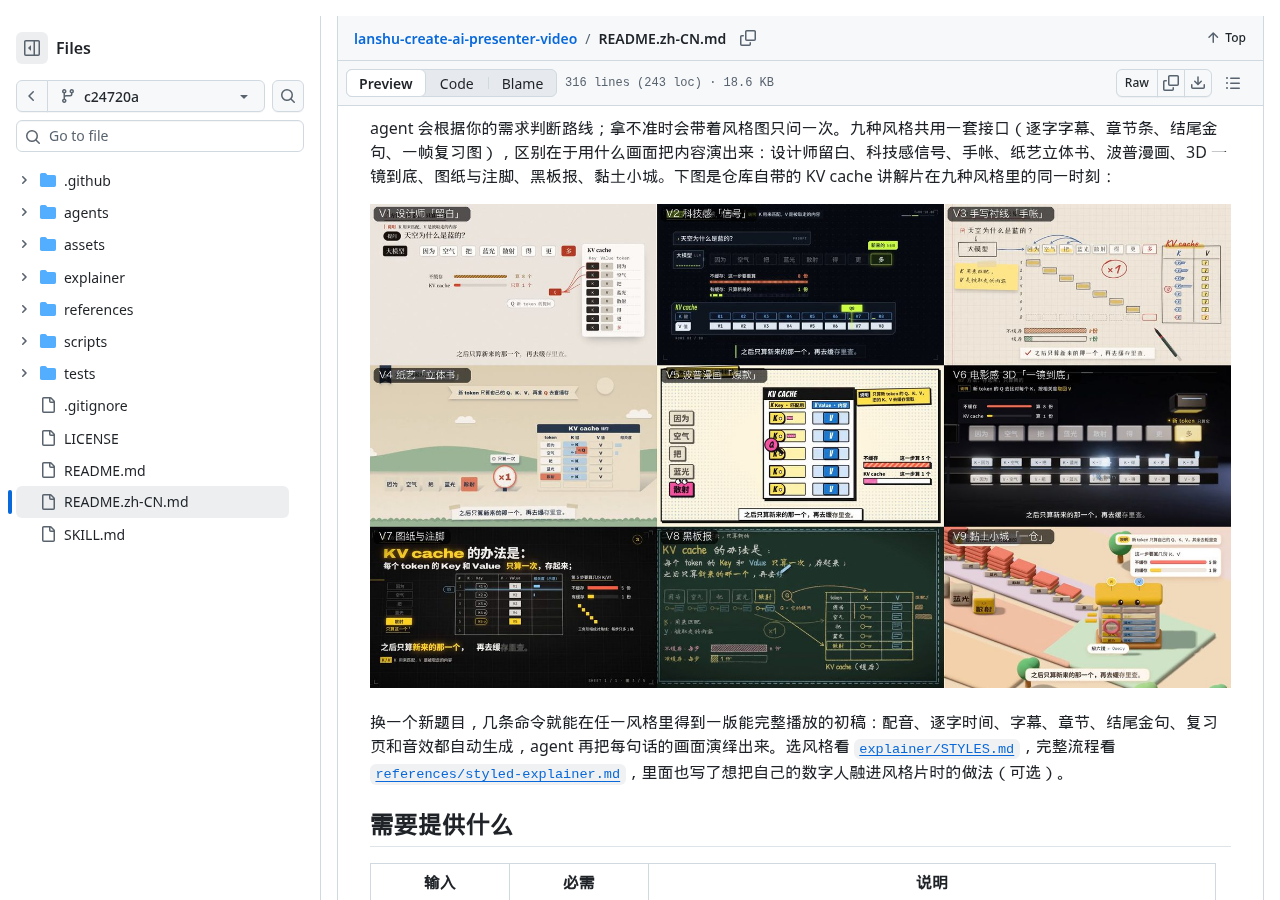
按照作者文档,这个 Skill 提供两条制作路线:数字人讲解和风格化讲解。两条路线都从主题或完整文案出发,但需要的素材、外部服务和最终画幅并不相同。
| 路线 | 主要结果 | 需要提供 | 生成成本边界 | 作者声明的画幅 |
|---|---|---|---|---|
| 数字人讲解 | 授权人物形象出镜,配合字幕和关键词动效 | 主题或文案、已获授权的清晰成年人物图 | 需要配音和数字人视频生成能力,可能产生云服务费用 | 任意画幅,默认 9:16 |
| 风格化讲解 | 不用人物出镜,以九种风格之一逐句演绎内容 | 主题或文案,也可提供自己的配音 | 作者称付费环节主要是配音;自备配音可避开这一项 | 固定 16:9 |
路线与成本描述来自仓库文档,尚未经过独立运行验证。
作者提供了九种画风。比如讲软件步骤时,可以研究图纸与注脚路线;想让抽象关系容易记住,可以看纸艺立体书或黏土小城。选画风的依据应是它能不能把这一句讲清楚,而不是哪种装饰最多。仓库样片展示了作者的设计方向,换成自己的题目后,仍需要重新检查画面与口播是否对应。
Skill 在这里更像一张视频制作工单
可以把它理解成寄快递时的分拣流程:包裹没有称重,就不能进入装车环节;地址没有确认,也不能因为工作人员手动勾选“已完成”就直接发走。这个 Skill 同样要求每个阶段留下对应产物,再由检查脚本计算任务状态。
作者把流程分成八个阶段,从收集输入到验收交付。文案和逐段节奏表检查通过后才锁定内容;配音文件能正常读取、有识别报告后才锁定声音;分镜批准后才继续生成画面。最后检查高质量母版和适合分享的版本能否完整播放、声音是否忽大忽小、有没有黑屏或画面异常停住。这样每一次“完成”,都得对应能检查的文件。
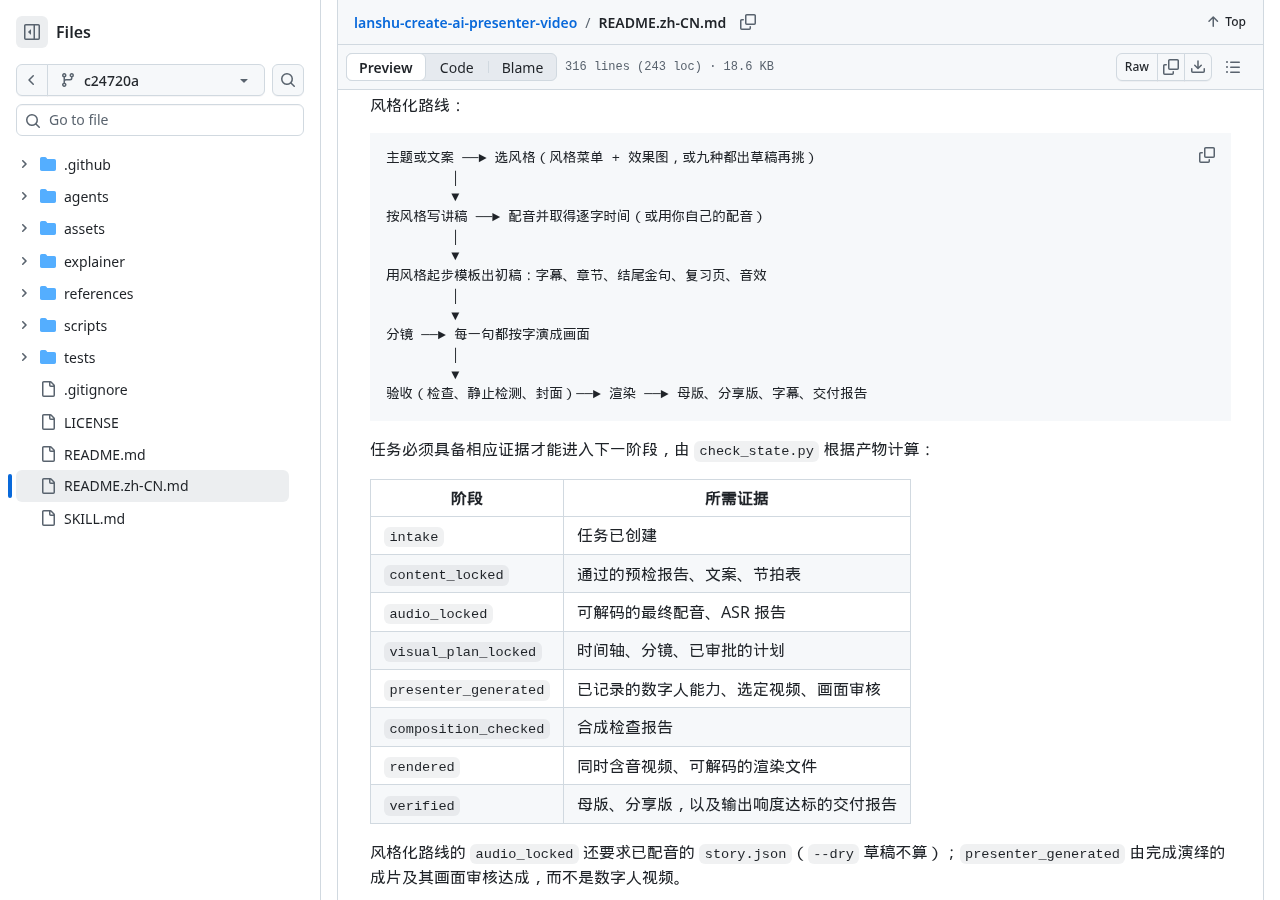
这套设计的价值不在于替代创作判断,而在于减少“页面显示成功,交付文件却打不开”一类低级事故。限制也很明确:脚本能够检查文件和技术指标,却不能自动证明人物一致性、口型、手势和画面表达已经令人满意。仓库仍要求正常速度观看成片,并记录人工画面审核。
开始之前要准备哪些环境
- 客户端方面,作者声明它采用标准 SKILL.md,可用于 Claude Code、Codex、Gemini CLI、Cursor、OpenCode、GitHub Copilot 等支持 Agent Skills 的工具;能读取文件并执行 shell 命令的 coding agent 也可参照流程执行。这是兼容性声明,不是所有客户端均已独立跑通的证明。
- 基础环境需要 Python 3.9+、FFmpeg 与 ffprobe、Bash、jq、awk 和 sed。
- 风格化路线还需要 Node.js、rsync,以及装有 numpy 的 Python。默认配音流程需要 MiniMax API Key;也可以改用自己录好的配音。
- 数字人路线至少需要一种可调用的配音、数字人视频生成和口型同步能力,可以是云服务 CLI、API 或本地模型。仓库没有保证这些能力随代码免费附送。
最稳妥的起点不是直接复制一长串命令,而是先决定路线。需要个人品牌形象、已有授权人物图,并接受远程生成成本,可以研究数字人路线;不想上传人物图,或者主题更依赖图形解释,可以先看风格化路线。选定以后,再把仓库放入对应客户端的 skills 目录,通过 Skill 名称明确调用。安装和目录说明可查看已核验的仓库文档:https://github.com/cclank/lanshu-create-ai-presenter-video/blob/c24720a85d63b1bd494f6447e48a59384733647b/README.zh-CN.md
免费的是代码,不是整条生成链
仓库的软件与文档采用 MIT 许可证,允许使用、修改和分发,但必须保留版权与许可声明,而且软件按“原样”提供、不附带担保。字体、第三方库和外部生成服务还有各自的条款,不能因为主仓库是 MIT,就把所有依赖和生成素材都当成同一种授权。许可证原文位于:https://github.com/cclank/lanshu-create-ai-presenter-video/blob/c24720a85d63b1bd494f6447e48a59384733647b/LICENSE
数字人路线还多一层素材权利问题。人物图需要确认使用权并确认人物成年;声音克隆需要单独获得明确授权,不能从照片推断或复制真人声音。作者设计了首次付费调用前的报价、试片规模和重试上限确认,但具体价格取决于实际选择的服务商,现有资料不足以给出统一成本。
警告 风格化路线会从 Google Fonts 和 jsDelivr 下载字体子集,云端配音也需要网络和凭据。对素材不能外传、网络受限或要求完全离线的项目,需要先逐项替换依赖,不能直接把这套流程视为纯本地方案。
它现在成熟到可以直接推荐吗
10 月 7 日抓取时,仓库有 2,372 个星标,使用说明、依赖、示例、测试和限制说明都已具备。资料比较完整,值得研究它怎样安排制作与验收;但星标数量不是成片质量,也没有连续快照证明它正在快速增长,不能据此把它包装成已验证的成熟推荐。
更关键的是,本次没有运行仓库代码,没有在 Claude Code、Codex 或其他客户端里完成端到端任务,也没有独立验证云服务组合、失败恢复和最终成片质量。因此,它目前更适合作为一套结构完整的待测工作流观察,而不是已经通过实测的成熟推荐。
什么人值得试
- 适合已经会使用 coding agent、能安装 Python 与 FFmpeg,并愿意处理 Node.js、云服务凭据和任务目录的人。
- 适合经常制作讲解视频,希望把授权、成本确认、分镜审批、技术验收和交付记录固定成流程的人。
- 适合有自己的配音或授权人物素材,能够人工审查画面、口型和版权边界的人。
- 暂时不适合只想输入一句话就免费得到成片,或者不能使用任何云端配音、数字人生成与网络字体资源的人。
回到标题:想让 ChatGPT 参与做出精彩的视频,先把题目收窄,让脚本逐段回答一个真实问题;再把每段该展示的操作、结果或关系写进分镜,最后交给具备执行环境的助手和制作工具完成。岚叔这套技能提供的是后半程的工单与检查办法。第一次可以只做一小段,记录服务、费用和失败点,再核对声音、字幕与画面是否讲同一件事。视频的精彩不来自一句“已完成”,而来自观众确实看懂,以及交付文件经得起播放检查。项目运行效果仍待独立验证。仓库入口:https://github.com/cclank/lanshu-create-ai-presenter-video
项目一手资料
🧰 我做的工具
这些工具都由我持续维护。预览版会明确标注,下载、更新和已知边界以发行页为准。
信息:黑粉盒子 HyphenBox 状态: 正式迭代
免费大模型 API 雷达:持续复测可用性,本地统一接口,Key 只存本机
信息:方寸智匣 LocalBrain 状态: 正式迭代
本地模型的多模态 MCP 工具箱:TTS / Whisper / 视频生成一站接入
信息:ScreenLex 光影词库 状态: 正式迭代
看美剧顺手把生词背了,Mac/Windows 双平台,免费
信息:黑粉录屏 HyphenScreen 状态: 正式迭代
录屏 + 智能剪辑一体:达芬奇式时间线、自动打码、导出前成片体检,免费
引用:黑粉科技 让AI成为你的超能力 本地部署 · 免费白嫖 · 自制软件 https://hyphentech.top
熬夜烧钱三千字扫码随心一杯茶
微信扫码长按保存图片,用微信「扫一扫」从相册选取
留言
正在加载留言…