AI Agent 实战对照
Claude Code · OpenClaw · Hermes Agent · DeepSeek Harness · 方寸智匣 —— 架构、记忆、Skill、Token,以及本机跑出来的真实成绩
复核日期 2026-10-21 · 全部结论标注来源 · 验不了的一律写「未核实」
🔍 为什么重做这一页 01
这一页 2026-04 写的,2026-08 改过一次版式,内容一直没动。现在我把这五家的源码和官方文档都翻了一遍——旧页里有一半的结论已经站不住了,而且大多是"三家纸面对比"里最容易出错的那类:架构层级、Skill 数量、注入体积。
| 旧页的结论(2026-04) | 2026-10-21 复核结果 | 依据 |
|---|---|---|
| OpenClaw 记忆是四层金字塔 | 不成立 | 官方文档写的是五层:Instructions / Curated core / Episodic / Prospective / Review |
| OpenClaw 无自动压缩、记忆持续膨胀 | 不成立 | 有 Dreaming 后台整合(light→REM→deep,默认开启),还有内置 auto-compaction 与 /compact |
| OpenClaw 用户建模:无 | 不成立 | 有 Honcho 插件:用户画像 + Agent 画像 + 跨会话语义检索 |
| OpenClaw 只有向量索引 | 不成立 | 内置引擎是 FTS5 关键词 + 向量 + 混合检索,BM25 排序、MMR 去重、CJK trigram 分词 |
| OpenClaw Skill 优先级:Built-in > ClawHub > User | 顺序反了 | 官方 6 级:Workspace 最高,Bundled/Custodian 是第 5 级 |
| OpenClaw Skill 始终注入正文 | 不准确 | 注入的是紧凑 XML 索引(只含名称/描述/位置),正文按需加载 |
| Hermes 内置 Skill 60 个 | 偏低 | 源码里 89 个内置 + 81 个可选,合计 170 |
| Hermes 平台 7 个 | 严重偏低 | 23 个(gateway 18 + plugins 5) |
Hermes 会话库 sessions.db | 路径错 | 实际是 ~/.hermes/state.db,记忆在 ~/.hermes/memories/ |
| Hermes 有 Atropos RL 训练子系统 | 证据薄弱 | 0.14.0 全树只有 3 处顺带提及,没有 RL 子系统 |
| Claude Code MEMORY.md 200 行硬上限 | 张冠李戴 | 本机规范是300 行 / 80 条 / 每条 ≤200 字符,200 是字符数不是行数 |
| Claude Code 100 内置 Skill | 无法核实 | 本机是自建 43 个,官方 marketplace 缓存 35 个 plugin / 28 个 SKILL.md |
| Claude Code 固定开销 11K / OpenClaw 29K / Hermes 11K | 无从复核 | 本机没有任何一处测过这三个数;旧页也没写测量方法 |
| OpenClaw 固定税 40% | 无从复核 | 分子分母都不存在 |
这一页现在的原则:能从我本机源码、官方文档和实测记录里复核的,写数字;不能的,写"未核实"或者干脆删。不再有"大约 40%"这种没有分母的数字。
🗺️ 五家速览 02
三个开源项目加两个本机在跑的东西。注意其中两个我没有安装——OpenClaw 和 Hermes Agent 我只有源码 checkout,所以关于它们的一切说法都来自代码和官方文档,而不是使用体验。
| Agent | 形态 | 本机状态 | 版本 | 一句话 |
|---|---|---|---|---|
| ⚡ Claude Code | 终端 / 桌面 | 已安装并日常使用 | 2.1.144 | 工具集最稳,记忆是最朴素的文本卡片 |
| 🦞 OpenClaw | 消息平台网关 | 只有源码 checkout | 2026.8.1(HEAD 2026-09-04) | 渠道最多、记忆层最全,生态也最需要审 |
| 🧠 Hermes Agent | 消息平台 + CLI | 只有私有 fork 源码 | 0.14.0(fork HEAD 2026-07-20) | 唯一有"自己会长技能"闭环的一家 |
| 🛠️ DeepSeek Harness | 可换工具层的 Agent 内核 | 本会话就跑在上面 | 0.2.1-rc.2 | 32 个工具包,工具层、权限、计量都可替换 |
| 📦 方寸智匣 | 本地 AI 工作台(自制) | 已安装并逐版验收 | 本机 2.0.9 / 已发布 2.0.8 | 用 DSH 内核,把本地模型和六类媒体能力接起来 |
Skill 规模(本机可数出来的)
来源:各自源码目录里的 SKILL.md 计数(2026-10-21 实扫)。OpenClaw 另有 4 个 custodian-skills。
平台接入数
OpenClaw 来自 docs/channels/index.md 列出的 32 个 channel(仓库里 docs/channels/ 共 48 篇);Hermes 是 gateway 18 个适配器加 plugins 5 个。
💾 记忆系统架构 03
记忆是 Agent 差异最大的地方。也是旧页错得最多的地方。
Claude Code — 文件型笔记卡
OpenClaw — 五层 + Dreaming
Hermes — 闭环自学习
| 维度 | ⚡ Claude Code | 🦞 OpenClaw | 🧠 Hermes Agent |
|---|---|---|---|
| 架构模式 | 文件型笔记卡 | 五层 + Dreaming 整合 | 闭环学习 + FTS5 |
| 存储位置 | ~/.claude/memory/ | Markdown + 向量库 | ~/.hermes/memories/ + state.db |
| 检索方式 | 索引浏览(无搜索) | FTS5 + 向量混合 | FTS5 + trigram |
| 用户建模 | 无 | Honcho 插件(可选) | 8 个 provider 任选其一 |
| 自动持久化 | 否(Agent 主动判断) | 是(+ Dreaming) | 是 |
| 自动压缩 | 会话级自动压缩 | 内置 auto-compaction + /compact,默认 safeguard 模式 | 手动 /compress |
| 增长控制 | 300 行 / 80 条硬线 | 超预算只截注入副本,磁盘文件保持完整 | LLM 摘要压缩 |
| 透明度 | 高 全部可读可编辑 | 中 Markdown + 库 | 低 自动学习黑盒 |
一句话:Claude Code 的记忆像一本自己维护的笔记本——你随时能翻、能改,但它不会自己变聪明;OpenClaw 像一个会做梦的档案室——后台自动整合、检索最全,但你得接受它偶尔黑箱;Hermes 在这两头之间,加了一条"做完能自己长出新技能"的闭环。
🧩 Skill 系统 04
旧页在这里犯了一个特别贵的错:把"Skill 数量"和"Skill 注入成本"混成一件事。
| 维度 | ⚡ Claude Code | 🦞 OpenClaw | 🧠 Hermes Agent |
|---|---|---|---|
| Skill 是什么 | 结构化提示词(SKILL.md) | 带插件市场的技能包 | 兼容 agentskills.io 的技能 |
| 数量(本机可数) | 自建 43 · 市场缓存 28 | 内置 51 · .agents 49 · custodian 4 | 内置 89 · 可选 81 |
| 加载优先级 | 项目 → 用户 | 6 级:Workspace > Project > Personal > Managed > Bundled > ExtraDirs | 内置同步 + Hub 安装锁 |
| 注入什么 | 调用时才注入正文 | 只注入紧凑 XML 索引(名称/描述/位置),正文按需加载 | 调用时才注入;skills_list() 层级约 3k tokens |
| 自改进 | 否 | 否 | 是(解决问题后自动生成新 Skill) |
| 安全审核 | 无 | ClawHub 安全裁决(批量 100/批,并发 6) | 工具沙箱 + provider 单一启用 |
| 开放标准 | 自有格式 | 自有格式 + ClawHub | agentskills.io |
装 3 / 5 / 10 个 Skill 的额外注入量
OpenClaw 的注入来自紧凑 XML 索引(源码估算约 24 tokens/技能),正文不常驻;Claude Code 与 Hermes 都是按需加载,用不调用都不花。
会话开始时冻结注入的体积
来源:Hermes 官方文档给的构件体积(MEMORY.md 2,200 字符、USER.md 1,375 字符)。这三项在会话开始时以冻结快照注入。
Skill 数量的意义要打折看。Hermes 有 170 个技能、OpenClaw 有 104 个目录、Claude Code 我自己写了 43 个——但真正决定每次请求贵不贵的,是有多少被塞进 system prompt。OpenClaw 是唯一会常驻注入索引的(还受 DEFAULT_BOOTSTRAP_MAX_CHARS = 20,000 每文件的预算约束),另外两家都是按需加载。
💰 Token 与成本 05
这一节我删掉了旧页的 11K / 29K / 11K 和「40% 固定税」。原因很简单:本机没有任何一处测过这三个数,旧页也没写测量方法。留着它们,读者只会照着做决策。
总 Token 的构成公式(这个是确定的)
公式没错,错的是旧页把"固定开销"直接填了三个拍脑袋的数。真正要算固定开销,得先确定每个 Agent 在你的配置下会注入多少——这是配置相关的量,不是产品的常量。
能确证的三个成本事实
| 事实 | 数字 | 来源 |
|---|---|---|
| Anthropic 全系 Prompt Caching 折扣 | cache_read = 0.1 × input(缓存读取只要输入价的 10%) |
本机模型定价目录:带 cache_read 的 4503 个模型中,比例恰为 0.1 的有 1827 个,是最常见档;Anthropic 全系命中这一档 |
| 缓存写入有溢价 | Anthropic cache_write 约 1.25 × input |
同一份定价目录 |
| OpenClaw 的 Skill 索引成本 | 约 24 tokens / skill(约 97 字符 ÷ 4 字符/token) | OpenClaw 源码的 skills 文档「Token impact」一节;每个文件另有 20,000 字符的 bootstrap 预算 |
想把「固定开销」测出来,该用什么
DeepSeek Harness 里有一个 token-meter 子系统,记录每次调用的 TokenMeasurement(baseline、surfaceDeltaTokens、totalTokens、surfaceTokens、nodes[]),按路由给不同模型定价。想做固定开销对照,就用同一套任务、同一个模型、只换 Agent,然后读同一个计量口径——这比拍三个数靠谱得多。
方寸智匣已经用上了这套:它的上下文压缩有四种路径,每一种都单独测过耗时和压缩后的 token 数(见下一节)。
成本控制手段(按能不能确证分两栏)
| 手段 | ⚡ Claude Code | 🦞 OpenClaw | 🧠 Hermes Agent |
|---|---|---|---|
| 预算上限 | 上下文窗口天然限制 | 每文件 20,000 字符 bootstrap 预算 | 记忆文件按固定字符数冻结 |
| 模型降级 | 不可选(绑定 Anthropic) | 可配 fallback 链 | 随时切换模型 |
| Prompt Caching | 原生 0.1× 读取价 | 取决于模型提供商 | 取决于模型提供商 |
| 记忆瘦身 | 手动删条目 | 超预算自动截注入副本 | LLM 摘要压缩 |
| Skill 减负 | 不调用就不耗 | 需要卸载不用的 Skill | 按需加载 |
| 上下文压缩 | 会话级自动压缩 | 内置 auto-compaction + /compact | 手动 /compress |
🎯 真实任务成绩 06
前面五节全是架构和机制。这一节是真正干活的部分——而且全部来自我自己机器上的运行记录,别人抄不走也复核不了。
25 轮对话 · 32 次工具调用
18 轮 · 36 次工具调用
0 失败
345 → 83 token
| 任务 | 引擎 / 模型 | 耗时 | 轮次 / 工具调用 | 结果 |
|---|---|---|---|---|
| 授权渗透测试 | 方寸智匣 2.0.7 · 本地模型 | 10 分 2 秒 | 25 轮 / 32 次 / 9 个批准框 | 找到真实越权漏洞(A 账户登录态读到 B 账户订单凭证),修复后复测通过 |
| 同一模型,工具说明不补足 | 同上 | 8 分半(耗尽预算) | 前 4 轮 | 调查失败 |
| 写一篇论文并交付双格式 | 方寸智匣 · 本地 27B | 22 分 9 秒 | 18 轮 / 36 次 / 2 次失败 | 交出可编辑 Word + 7 页 PDF;最终状态标「任务已停止」(没通过的部分不圆) |
| 双格式文档交付 | 方寸智匣 1.7.9 | 21 分 34 秒 | — | 6 页 PDF + 可编辑 Word,两格式提取 3546 汉字顺序一致 |
| 同一任务,上一版 1.7.8 | 方寸智匣 1.7.8 | 55 分 12 秒 | 第 18 次请求失败 | 未交付 |
| 操作 Blender 做一台售货机 | 本地 27B + blender-mcp | 5 轮共 174 分钟 | ~9.5 tok/s | 没做完:渲染全黑、饮料被封在没开窗洞的实心机身里 |
看这张表最重要的一列是最后一列。同一个模型,工具说明补足与否,10 分 2 秒能挖出漏洞,8 分半连调查都完不成;同一个软件的两个版本,一个 21 分钟交付,一个 55 分钟后第 18 次请求崩掉。Agent 的能力不取决于模型多大,取决于你把工具说明、上下文预算和失败恢复配到什么程度。
上下文压缩:四种路径的实测耗时
| 路径 | 耗时 | 压缩效果 |
|---|---|---|
| 普通语义摘要(首轮) | 12.034 秒 | 2021 → 121 token(估算) |
| 原生中文摘要 | 11.440 秒 | 1716 → 233 token,复用 4032 个缓存 token |
| 安装版自动压缩 | 2.965 秒 | 345 → 83 token,覆盖 2 → 7 条 |
| 手动「立即压缩」 | 2.477 秒 | 132 → 83 token |
测的是方寸智匣 1.9.1(2026-10-16)。前端回归 1571 项 / 1569 通过 / 2 跳过。长任务可恢复性另测:230 次额外读取后来源引用仍在,210 份文件状态可恢复。
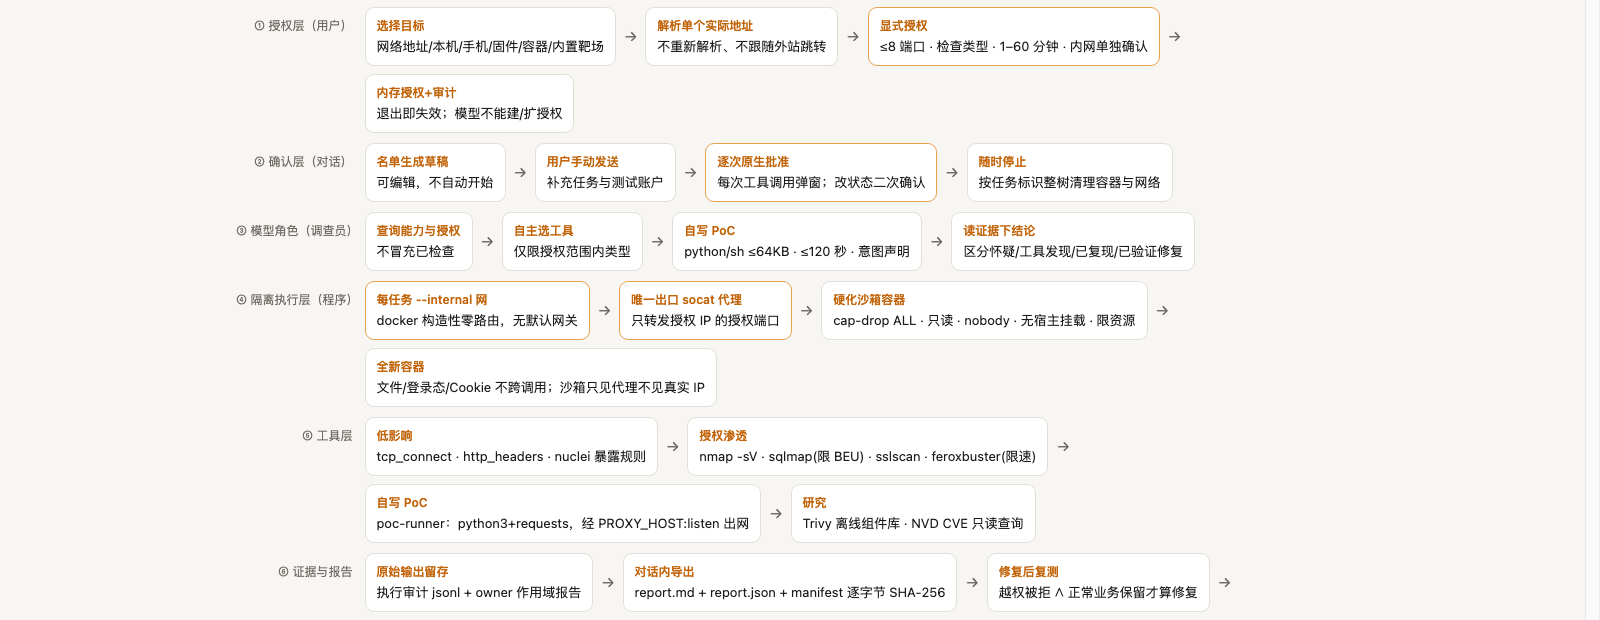
完整过程在这几篇里:方寸智匣 2.0.7 能自己做安全测试了、本地 27B 把「狗熊哆嗦毛」写成论文、方寸智匣写论文升级、本地 27B 能操作 Blender 吗。还有一篇讲方法论的:AI 为什么老是半路下班——AI 提前收工不是懒,是没定义「完成」的证据。
⚙️ 执行循环 07
架构决定上限,循环决定日常体感。
Claude Code
OpenClaw
Hermes Agent
DeepSeek Harness
方寸智匣
实测里的循环特征
🎯 选型建议 08
按你手上要解决的事选,而不是按功能表选。
| 你的处境 | 推荐 | 理由 |
|---|---|---|
| 纯写代码、调试、重构 | Claude Code | 工具集最稳,出错时你知道问题在哪一层 |
| 要接很多聊天平台、想 7×24 小时在 | OpenClaw | 32 个渠道 + 心跳 + 子代理,是这五家里最像"常驻助理"的 |
| 想让 AI 越用越懂你的工作方式 | Hermes Agent | 唯一有"自己长出新技能"闭环的 |
| 要跑在本地模型上、且要可复现 | 方寸智匣 | 每一步都有回执和 SHA-256,能离线复跑 |
| 想自己搭一套 Agent 内核 | DeepSeek Harness | 工具层、审批、沙箱、计量都是可替换部件 |
| 数据敏感、完全离线 | 方寸智匣 | 本地模型 + 本地回执,不出网 |
| 成本敏感 | Claude Code | 缓存读取价 0.1× + 按需加载,两头都省 |
一句话总结:Claude Code 是最稳的编码刀,OpenClaw 是最广的连接网,Hermes 是唯一会自己长大的那个,DeepSeek Harness 是可以自己拼装的骨架,方寸智匣是把本地模型真跑出结果的那个。记忆和 Skill 从"静态笔记"到"五层自动整合"再到"自学习闭环",正好是一条进化线。
⚠️ 未核实项与复核说明 09
这一页删掉的比留下的多。删掉的理由写在这儿,你自己判断要不要自己核。
| 旧页的说法 | 为什么这一页不写 |
|---|---|
| 三家的 GitHub stars | 本机没有 GitHub API 快照。要写就得联网取当天数并标日期,我这次没取 |
| ClawHub 社区技能总数(13K+) | 本机没有 ClawHub 注册表缓存,源码里只有客户端地址 |
| 「约 20% 社区技能被标记恶意」 | 源码里有安全裁决逻辑,但没有任何统计数字。要写就得联网查 |
| 11K / 29K / 11K 固定开销、40% 固定税 | 本机零测量,旧页也没写测量方法 |
| Claude Code「100 内置 Skill」「3 个平台」 | 安装的是编译后二进制,没法枚举内置 Skill;接口数也从磁盘数不出来 |
| Hermes「Atropos RL」 | 0.14.0 源码树里只有 3 处顺带提及,没有 RL 子系统 |
| 旧页脚「数据更新于 2026 年 4 月」 | 文件实际最后修改是 2026-08-07,那个日期本来就不准 |
这一页的数据从哪来
上一轮我把这些全部摊开写成五列对比表,每一列都标了来源路径——那是比数字本身更值钱的东西。数字会过期,能复核的方法不会。