
提示 本文首发于黑粉科技公众号
老黄又来掀桌子了
中国台湾2026全拆解:Agent时代真·到货,三张桌子一次掀完
2026-06-01 · 黑粉科技 · AI热点追踪
一、「有用的AI」真的到货了
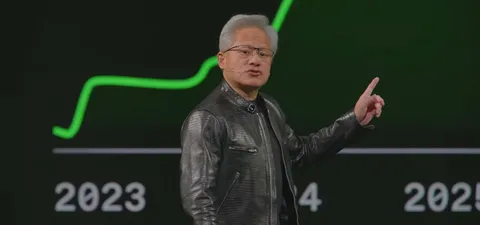
2026年6月1日,黄仁勋站在中国台湾台北的GTC舞台上,开口第一句就给整个行业定了调:折腾了两年的Agentic AI(智能体AI),今天正式「到货」了。注意,他用的词是「有用的AI」——不是能聊天的玩具,是能干活、能赚钱的生产力。
他甩出的第一张证据是GitHub。代码提交量2023年3亿次、2024年4亿次、2025年5亿次,到了2026年才头几个月,直接翻了将近3倍。老黄顺势算了笔账:全球3000万到4000万职业程序员,一年大约3万亿美元工资,如今产出相当于9万亿美元的生产力,往外辐射影响着全球大约100万亿美元的产业。
所以那句「AI抢饭碗」的老调,被他当场怼回去:程序员不但没变少,反而越招越多。逻辑很朴素——一个工程师能撬动9万亿的产出,你说老板是想多招还是少招?这就是他反复强调的:token现在是「利润单位」,能赚钱,大家就拼命建AI工厂、拼命买算力。这也是为什么中国台湾的算力需求直接起飞,今年中国台湾GDP预计增长接近10%。
二、Agent到底是个啥?老黄给你画了张图
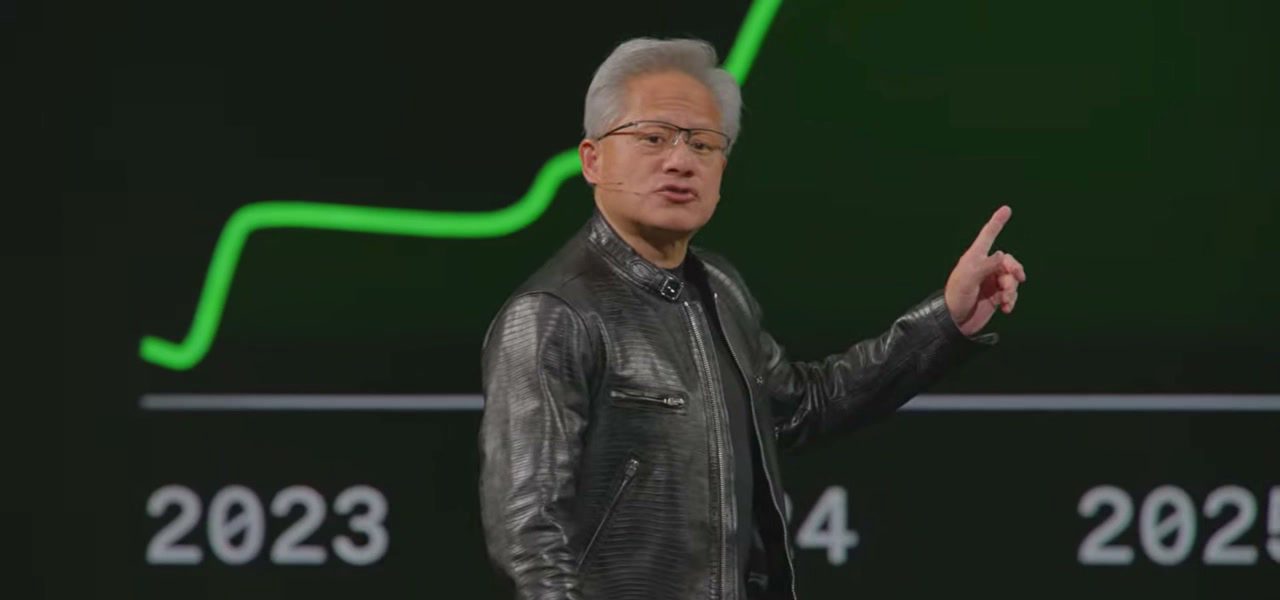
很多人嘴上说Agent,其实没搞清它和「聊天机器人」的区别。老黄干脆画了张图:过去的应用是「应用 + 代码 + 操作系统」,现在变成了「大模型 + harness(调度框架)」。大模型负责思考,harness像操作系统一样把一切串起来。
一个Agent要干嘛?观察、推理、规划、行动、调用工具,还得管两种记忆:短期的「工作记忆」(也就是KV缓存)和长期记忆——跟人脑一个套路。它会自己拆任务、开子智能体、调数据库、跑浏览器。老黄现场演示直接掏出了Claude Code和Codex,一句提示词生成动图、生成可3D打印的CAD文件,全程它自己调工具。
更妙的是老黄的「反常识」判断:都说Agent来了软件公司要完蛋,他说完全相反——因为Agent比人多得多,会比人类用更多的工具,所以这是软件公司最好的时代。前提是:你的软件得「翻译」成Agent能调用的样子。NVIDIA把自家一千多个CUDA-X库全部包装成带「使用说明书」的工具,让AI读一眼就会用。这步棋,藏得很深。
三、第一张桌子:Vera Rubin,不是一颗芯片,是一座工厂
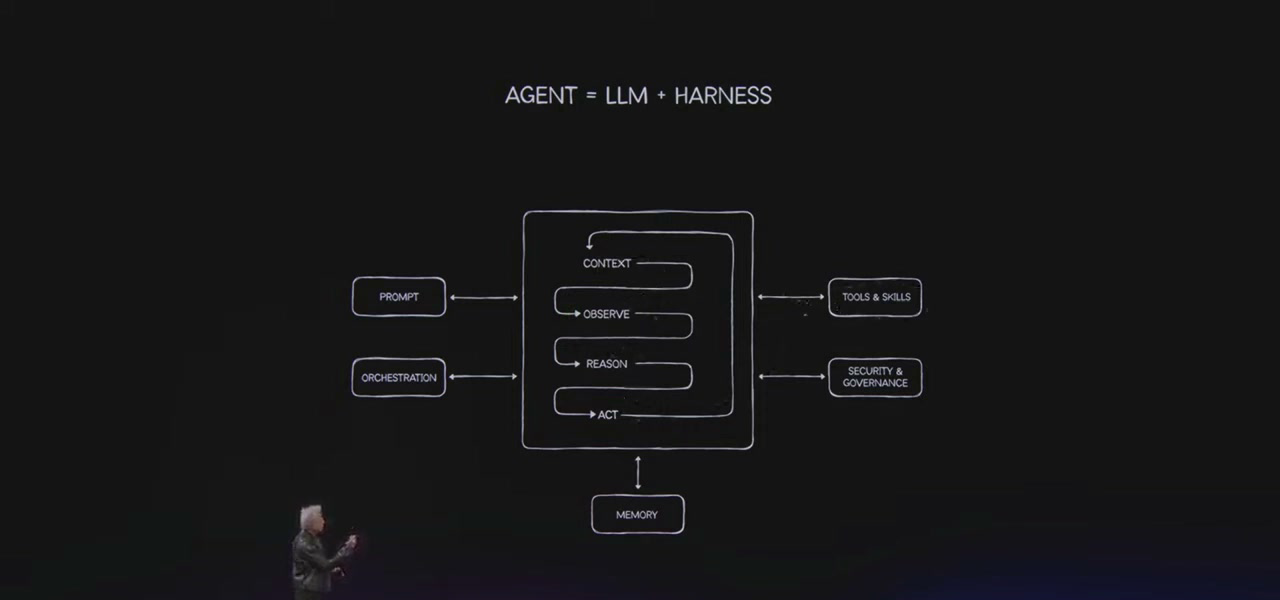
重头戏来了——新一代Vera Rubin正式量产。老黄一再强调:它不是一颗GPU,而是「五机柜连体」的Pod级超级计算机,GPU、Vera CPU、存储、网络全部打包。7颗新芯片、台积电3nm、HBM4内存;单块计算板塞了6万亿颗晶体管、超过18000个元件;整机柜130万个零件、液冷母线扛5000安培——相当于20辆电动车同时全力加速。
为造它,NVIDIA动用了4万名工程师,拉上150家中国台湾供应链伙伴。供应链规模是上一代Grace Blackwell的2倍,而单机柜组装时间,从过去的2小时压缩到了5分钟。微软、戴尔、CoreWeave都已经在搭工程样机。老黄那句「NVIDIA已经不只是GPU公司、系统公司,而是一家AI基础设施公司」,听着像口号,其实是商业模式的整体上移。
他还顺手掀了CPU的桌子:过去的CPU是为「人」造的,按核数出租、按秒计费;可Agent没耐性,活在纳秒世界,等一下都嫌慢。于是有了Vera CPU——全新Olympus核心、88核单片网格、每时钟能跑10条指令;对比x86,内存延迟低40%、核间通信快50%、片内带宽3.6TB/s。实测更狠:SQL快3倍、纽交所实时流处理快6倍、Agent沙箱性能是x86的1.8倍。配套还开源了模型NemoTron 3 Ultra(SSM+MoE混合架构,快5倍、便宜30%),以及和Cadence合作的芯片设计智能体,验证速度快40倍,几周的活几小时干完。
四、第二张桌子:40年来第一次,PC被重新发明
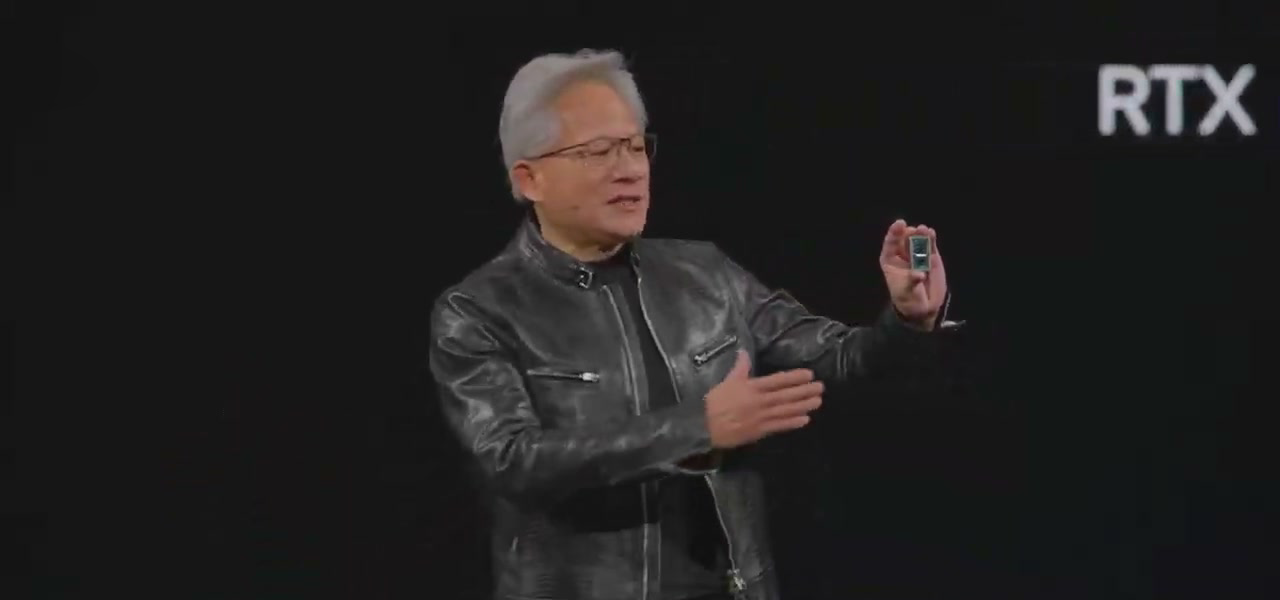
这部分最炸。老黄和微软联手,40年来第一次重新发明个人电脑。打头阵的是RTX Spark芯片:Blackwell RTX GPU带6144个CUDA核心、1 petaflop的AI算力,搭配和联发科合作的20核Grace CPU、128GB统一内存、台积电3nm、700亿颗晶体管。他还举起了一颗N1X芯片,说这玩意「要花33年才造得出来」——因为100%的NVIDIA软件栈都能在上面跑。
再往上是桌面级的DGX Station:768GB内存,能在桌子上直接跑万亿参数模型,20 petaflops算力、8TB/s内存带宽。老黄给了个很「科幻」的预言:未来的PC会像当年从功能机进化到智能手机一样彻底变样,你家里会摆一台7×24小时跑Agent的AI超算,越用越聪明,「更像R2-D2,而不是PC」。连Adobe都已经为RTX Spark重做了Photoshop和Premiere,快2倍,还能通过MCP直接被Agent调用。
为什么这事重要?因为它把「Agent」这个计算模式,从云端、企业,一路铺到了你的桌面。同一套「模型+harness+工具+运行时」,云上能跑、公司能跑、家里也能跑。老黄等于在你家门口插了根桩。
五、第三张桌子:物理AI和机器人,下一个十年的入口
最后老黄把视线投向了「物理AI」。他说语言模型的数据是「我们写、我们读」的第一人称,可机器人需要的是它自己视角的数据,而世界上的视频几乎都是第三人称——数据,才是物理AI最难的坎。NVIDIA的解法是一整条阶梯:从遥操作(约等于RLHF)、到仿真(Omniverse,约等于可验证奖励的强化学习),最后训练出能从任意视角理解物理世界的「世界基础模型」。
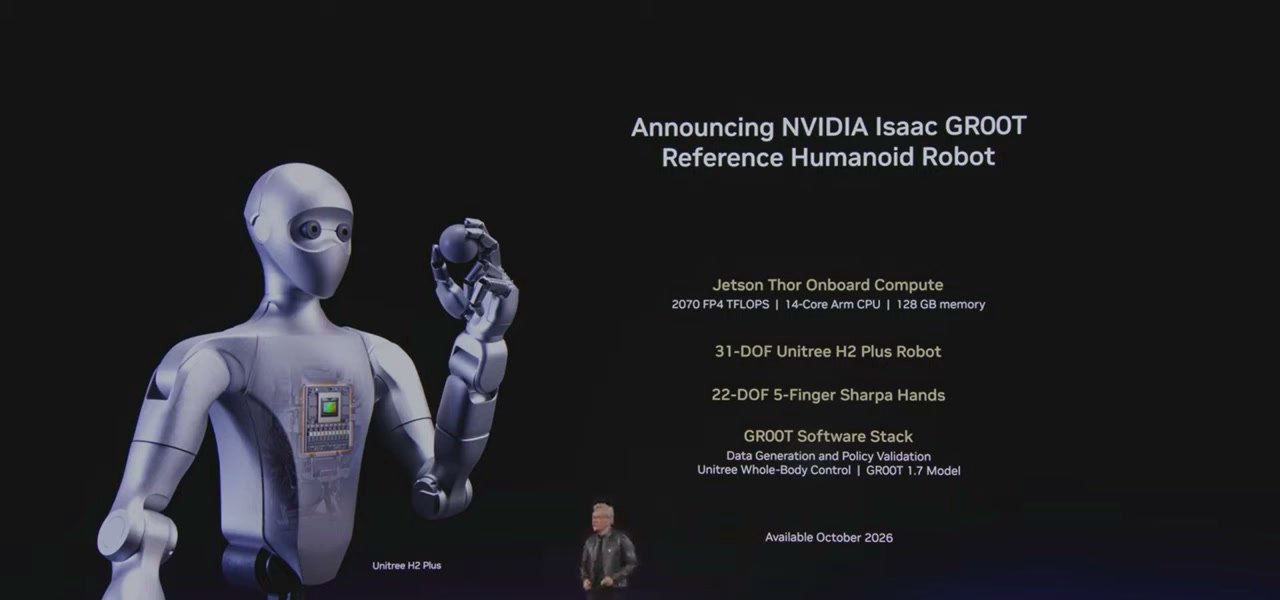
于是有了三连发:开源世界模型Cosmos 3、自动驾驶开源模型Alpamayo 2(号称全球首个会「推理」的自动驾驶,NVIDIA Hyperion平台覆盖全球约80%车厂、约97%的出行服务),还有人形机器人参考平台Isaac Groot——每只手25个自由度、整机31个自由度、6英尺高、150磅重(老黄自嘲「跟我差不多,就是矮一点、胖一点」),跑全新的Thor芯片。
过去6个月,一切都变了。因为Agent落地、撞上了前沿模型,AI第一次能干真活。
六、我的几点判断和预测
判断一:这是一次商业模式的「整体上移」。 NVIDIA从卖芯片、卖系统,变成卖「AI工厂」。当老黄反复念叨「算力即营收、性能功耗比即利润」,他其实是在重写客户的采购逻辑:别只看芯片单价,要算每一瓦能产出多少token、资产能用多少年。这套话术一旦被接受,价格战就打不动它了。
判断二:CPU这条新战线,杀伤力被低估了。 「为Agent造CPU」听着是补充,实则是直接对着x86的腹地开枪。如果Vera真能在真实负载上做到3到6倍,并且跟着Vera Rubin一起被全行业「预先认证」,那它会成为NVIDIA增长最快的新引擎——老黄自己都说,订单已经让它成为公司史上最成功的产品发布之一。
判断三:家用AI超算,比你想象得近。 「家里摆台AI超算」现在听着像科幻,但回想十年前你也不信手机能取代相机、钱包和电视。当DGX Station能在桌上跑万亿参数模型、当微软把PC底层重做一遍,这条赛道一旦被验证,跟进速度会非常快。真正的悬念不是「会不会发生」,而是「谁来定义那台家用AI主机的操作系统」。
提示 一句话总结
老黄这场两小时演讲,本质上把未来十年的计算范式钉死成了一个词——Agent。Vera Rubin负责算、Vera CPU负责调度、RTX Spark负责铺到每个人桌面、机器人负责走进物理世界。当「算力即营收」成为共识,这场牌局基本已经定调。剩下的悬念只有一个:在「家里摆台AI超算」这件事上,几年内能成?评论区聊聊你的判断。
自制软件
版本、功能变化和安装平台统一取自公开发行记录。
黑粉助手 HyphenAssistant
用手机浏览器接着操作电脑上的 DeepSeek Harness 会话;需原服务、电脑和网络保持在线,模型费用沿用原配置。
黑粉助手0.1.5精简侧栏底部:移除重复的“支持开发”和赞助提醒,首页保留明确的赞助入口。侧栏的本机保存提示、版本和官网链接通过统一间距与细分隔线整理层级。
方寸智匣 LocalBrain
本地 AI 工具箱:转写、配音、生图、视频和 MCP 工具集中管理;具体功能以对应平台版本为准。
压缩后保留你给出的原始约束:自动与手动压缩都在中文语义摘要之外,从官方追加日志保留可信的用户原文,按事件顺序核对目标、账户、参数与限制;网页内容、工具回执、宿主审查提示与旧摘要不能冒充你的要求。保留块不恢复授权、不构成待执行队列、不重放已执行工具;原文过长无法缩减时如实报告边界。
黑粉盒子 HyphenBox
免费大模型 API 雷达与本地统一路由:持续复测可用性,Key 只存本机。
一键连接改为 DeepSeek Harness,使用其官方原生 OpenAI 兼容适配连接本地接口;删除旧 OpenCode 配置写入、缓存清理、迁移及客户端验收运行入口,不再检测、创建或刷新旧客户端配置。
光影词库 ScreenLex
把本地电影与剧集字幕变成可复习的英语词库,全程离线。
侧边栏新增赞助入口,点开是一张二维码,不打扰、不弹窗、不影响任何功能。
黑粉录屏 HyphenScreen
录屏与剪辑一体:达芬奇式时间线、自动打码、导出前做成片体检。
本版先发布Apple芯片Mac;Windows与Linux继续提供1.6.6,未包含本轮功能。不自动替换本机安装版。

微信赞赏 · 金额随意



留言
正在加载留言…