本地模型实测报告
9 个 GGUF 小模型 × 4 个工具场景 × 两种上下文窗口,再加看图、27B、长任务、常驻与 SSD 四组对照
01 · 测试口径:什么算通过
先说口径,不然下面的数字没法比。
这批测试跑在我自己的机器上——MacBook Pro(Mac17,9),Apple M5 Pro 18 核(6 性能 + 12 能效),64GB 统一内存,Metal 下 GPU 可用内存上限 55.66GB。引擎是 llama.cpp b10705,投机解码那组用 Splash 1.0,看图那组用 MLX(mlx-lm 0.31.3 / mlx-vlm 0.6.12)。
统一变量:温度 0、关闭思考、整模型上 GPU(-ngl 99)、-c 32768 或 8192、-np 1、--jinja、标准档输出上限 512 token。每个模型跑四类任务,判定方式写死:
| 场景 | 做什么 | 怎么算通过 |
|---|---|---|
| A 多轮对话 | 连着聊 3 轮,含冷启动与缓存加速 | 三轮都有内容返回,且轮次之间不崩 |
| B 列目录 | 工具调用 list_dir /tmp | 工具真的执行,返回结构化结果 |
| C 执行命令 | 工具调用 run_bash uname -a | 命令在白名单内跑出真实输出;管道、重定向、命令串联一律拒绝 |
| D 写文件并读回 | write_file 后 read_file | 直接检查沙箱里的文件,不看模型自己怎么说 |
D 这一条是关键。以前看模型评测,模型说"我已经写好了"就算数;这里读的是沙箱里的真实文件内容,写错了就是写错了。三个模型在 D 上失手,原因也各不相同,我会在第 03 节写清楚。
MTL0_Mapped model 已经覆盖整个权重文件,CPU_Mapped 又单列一次,是同一批文件页——Gemma 4 E4B 因此被多算 2730 MiB。所以这页所有内存数一律按文件 + 上下文缓存 + 计算缓冲三项相加,不直接抄日志里的分项表。
02 · 速度与内存:9 个模型,两个窗口
这批是 2026-09-13 跑的,同一批权重、同一条命令,只换模型。32K 窗口每个模型跑 6 遍,8K 跑 3 遍,表里是干净轮次的中位数。
| 模型(Q4_K_M / QAT Q4_0) | 窗口 | 生成 tok/s | 预填充 tok/s | 合计 GB | 文件 | 上下文 | 计算 |
|---|---|---|---|---|---|---|---|
| MiniCPM5-2B | 32K | 133.6 | 3218.7 | 3.10 | 1.56 | 1.41 | 0.13 |
| Ling-3.0-tiny | 32K | 131.4 | 2873.0 | 5.38 | 4.92 | 0.25 | 0.21 |
| Granite 4.2 3B | 32K | 94.8 | 2086.5 | 5.10 | 2.24 | 2.68 | 0.17 |
| Gemma 4 E4B | 32K | 70.2 | 1233.9 | 6.05 | 5.15 | 0.58 | 0.31 |
| Qwen3.5-4B | 32K | 68.7 | 1026.8 | 4.15 | 2.74 | 1.13 | 0.28 |
| Qwen3-8B | 32K | 51.2 | 1180.7 | 10.12 | 5.03 | 4.83 | 0.26 |
| Granite 4.2 8B | 32K | 46.1 | 929.2 | 10.98 | 5.35 | 5.37 | 0.26 |
| Qwen3.5-9B | 32K | 43.1 | 677.6 | 7.08 | 5.68 | 1.13 | 0.28 |
| Gemma 4 12B | 32K | 33.3 | 532.3 | 8.27 | 6.98 | 1.04 | 0.25 |
生成速度(32K 窗口,中位 tok/s)
估算合计内存(32K 窗口,GB)
这里最反直觉的一行是 Qwen3-8B:文件只有 5.03GB,比 Granite 4.2 8B 的 5.35GB 还小,但 32K 窗口下合计要 10.12GB——上下文缓存吃掉了 4.83GB。模型文件和它实际要占的内存是两件事,买硬件按前者算会翻车。
窗口从 32K 降到 8K,生成速度几乎不动(Qwen3-8B 51.2 → 50.4,MiniCPM5-2B 133.6 → 131.3),但合计内存明显下降(Qwen3-8B 10.12 → 6.36GB)。所以要省内存,砍窗口比换模型划算。
这批数据最早的完整记录在 8GB 设备能跑哪些本地模型 那篇里,内存账本和看图对照也放在一起。
03 · 工具调用:谁真的把活干完了
32K 窗口每个模型跑 6 遍、8K 跑 3 遍,四个场景各自统计通过次数。表格里 6/6、6/6 表示六遍全过。
| 模型 | A 多轮对话 | B 列目录 | C 执行命令 | D 写文件读回 |
|---|---|---|---|---|
| MiniCPM5-2B | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 |
| Ling-3.0-tiny | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 |
| Granite 4.2 3B | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 1/6 · 0/3 |
| Gemma 4 E4B | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 |
| Qwen3.5-4B | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 |
| Qwen3-8B | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 |
| Granite 4.2 8B | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 |
| Qwen3.5-9B | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 |
| Gemma 4 12B | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 | 6/6 · 3/3 |
唯一失手的是 Granite 4.2 3B 的 D 场景:六遍只成一遍,8K 下三遍全没成。查日志发现不是工具坏了——它每次都成功调用了 write_file,只是把文件名写成沙箱目录名加 ".txt",而我核验的目标是 hello.txt。文件确实写了,名字不对,所以判失败。
04 · 看图:9B 打赢 30B
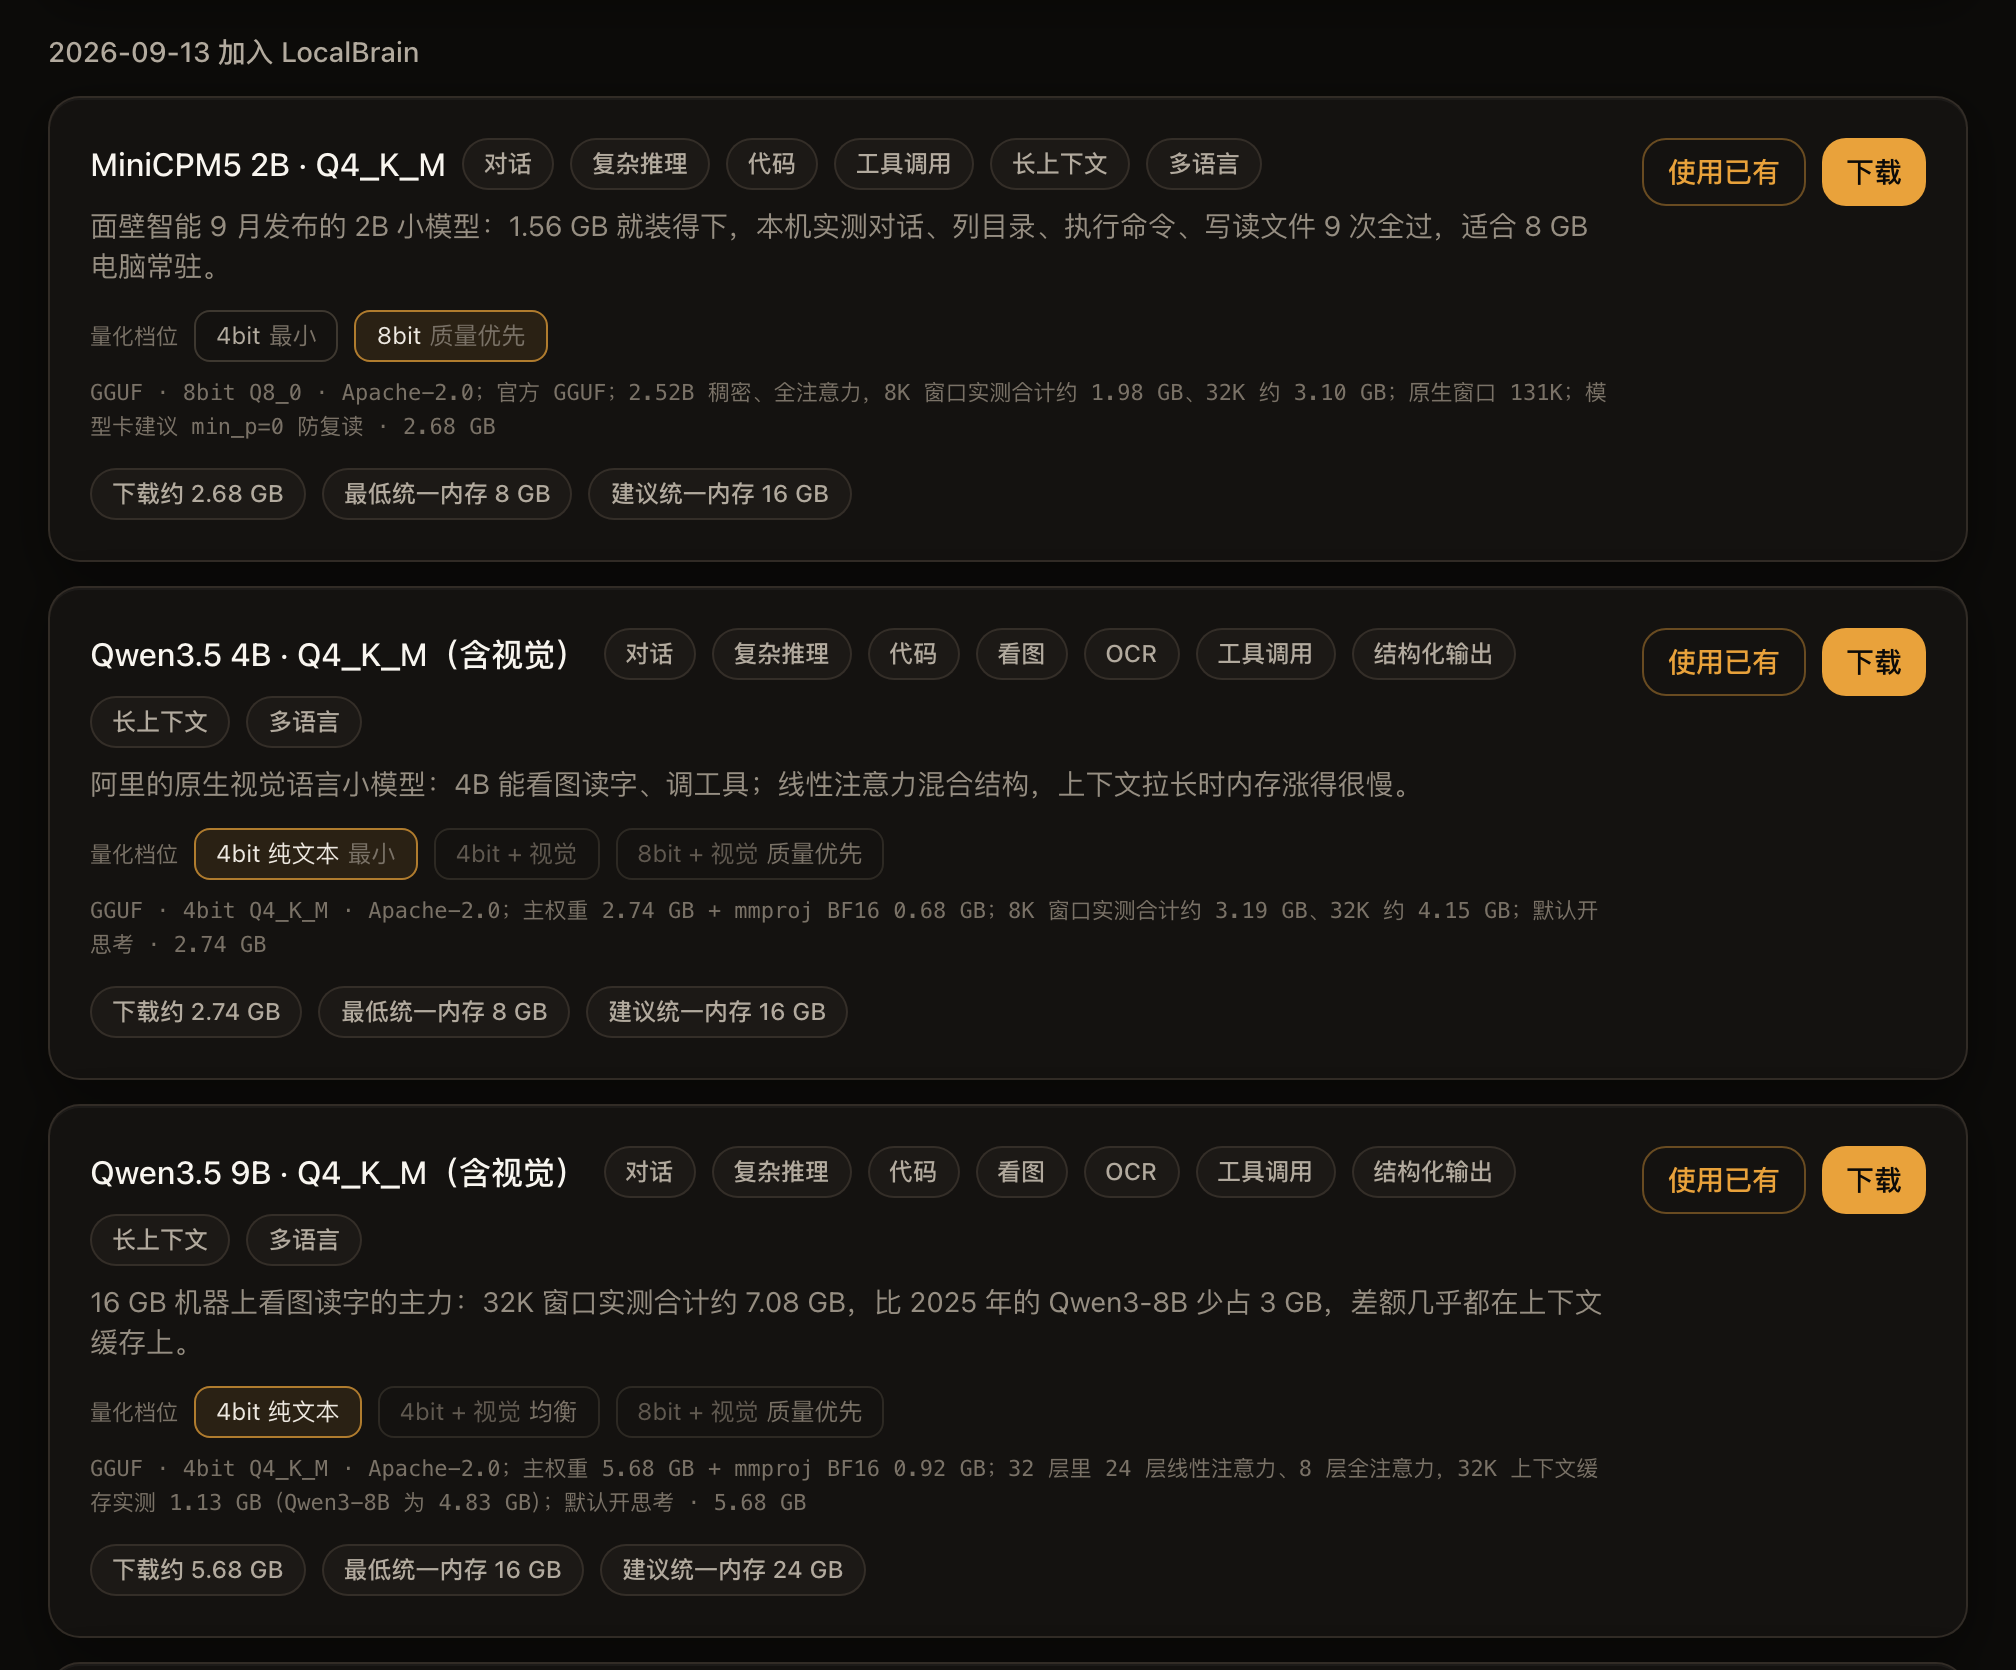
视觉模型单独测。同一条链路(最长边 1280)、同一批题图、同一套判分,满分 71 分。
| 模型 | 得分 | 六题耗时 | 启动 | 内存峰值 |
|---|---|---|---|---|
| Qwen3.5-9B-MLX-4bit | 71 / 71 | 74.9 秒 | 6.1 秒 | 8750 MiB(9.2 GB) |
| Qwen3-VL-30B-A3B-Instruct-8bit | 68 / 71 | 152.2 秒 | 23.3 秒 | 34816 MiB(36.5 GB) |
分项上 9B 全满分,30B 在"读柱状图"那题扣了 3 分。换算下来:9B 快 2.0 倍、内存只有四分之一、分数还更高。这是个 2026-09-13 的单次对照,题量只有六道,我不把它当通用结论,但至少说明"看图就得上大模型"在这套题上不成立。
05 · 27B 怎么跑:投机解码和它的中文代价
小模型再快也不是终点。27B 这一档我用了三种跑法,都是同一台机器。
| 跑法 | 权重 | 生成 tok/s | 说明 |
|---|---|---|---|
| Splash 投机解码 | Qwen3.8-27B 4bit 主模型 + DFlash2 草稿 | 53.4(110 次请求中位,最低 31.6 / 最高 90.3) | 草稿模型 5 层 1.18 GiB,猜 7 个 token 验证一次 |
| llama.cpp | 同参数量 Q8_0 | 9.11 | README 里记录的同参数量对照口径 |
| llama.cpp | Qwen3.8-27B-ABLITERATED-Q8_0 | 7.4 | 长任务探针里的实测,全库最慢的一组 |
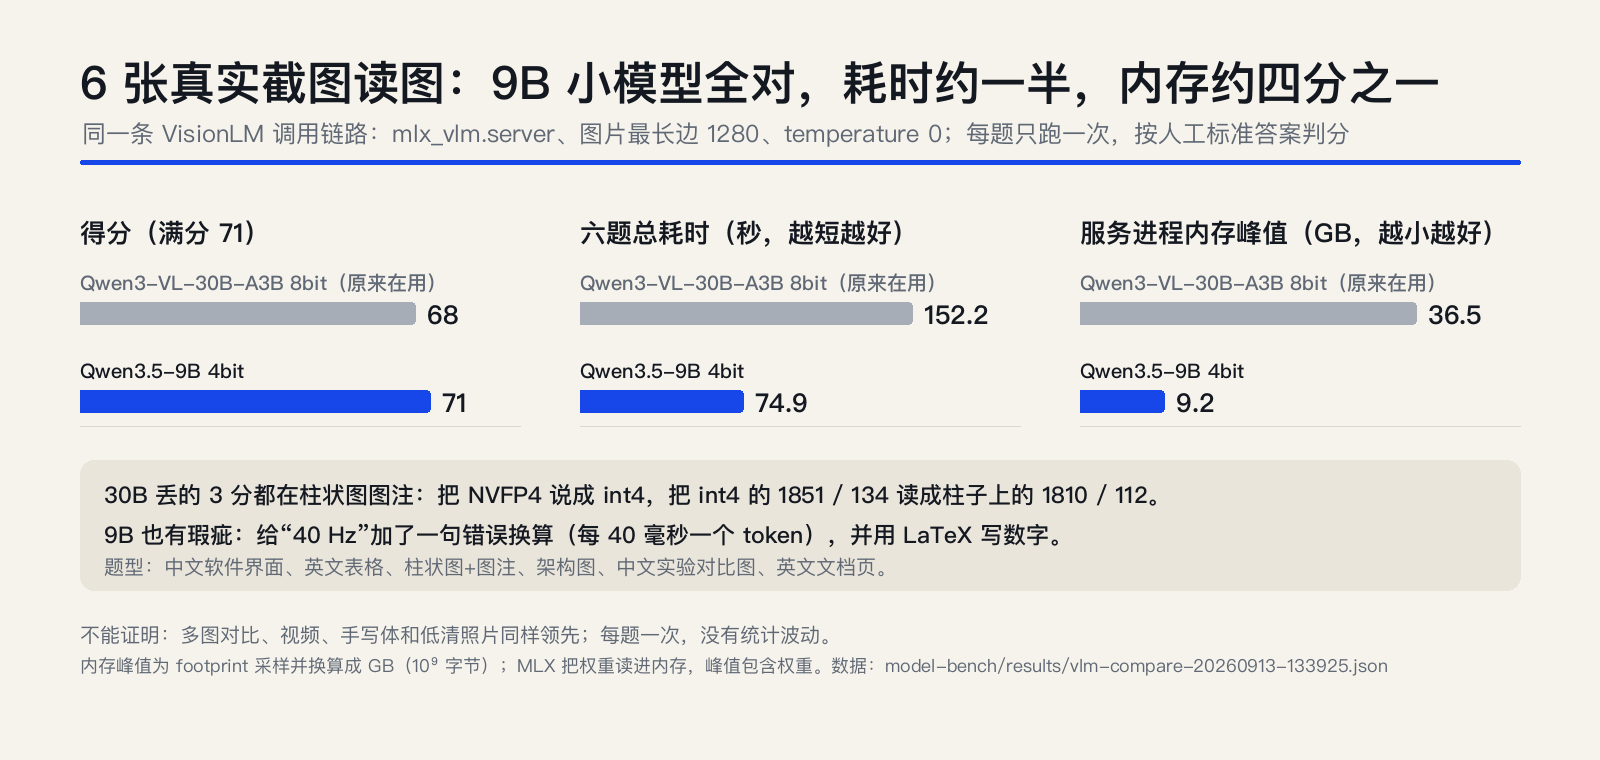
但投机解码有个坑:接受率看的是内容类型,不是模型大小。同一套引擎,分场景测下来差别很大。
| 任务类型 | 中位 tok/s | 草稿接受率 | 每次实际吐出 |
|---|---|---|---|
| 写代码 | 77.30 | 63.2% | 5.45 token |
| 英文散文 | 32.25 | 20.5% | 2.44 token |
| 中文口播稿 | 24.15 | 11.9% | 1.84 token |
写中文的时候接受率掉到 11.9%,速度只有官方说法的 44%。中文比代码慢 3.1 倍。如果你主要用本地模型写中文稿,别按"2 倍加速"做预期。完整拆解在 Splash 本地推理引擎实测 那篇里。
06 · 长任务能力卡:一次能写多少
速度之外还有一个更硬的指标:模型一轮能连续写多少字不崩。我用四项探针(单写上限、续写收口、定点修复、工具选择)跑了 6 组,结论一致——这批本地模型都只适合短任务或分段交付。
| 模型 | 总耗时 | 解码中位 tok/s | 单轮写入上限 | 写完 25KB 需要 |
|---|---|---|---|---|
| Ling-3.0-tiny Q8_0 | 148.8 秒 | 101.0 | 17,611 字符 | 2 段 |
| Qwen3.5-4B Q4_K_M | 250.0 秒 | 66.5 | 14,731 字符 | 2 段 |
| Qwen3.5-4B Q4_K_M | 701.6 秒 | 69.3 | 2,065 字符 | 1.7 分钟 |
| Qwen3.8-Flash-Next IQ4_XS | 391.8 秒 | 21.3 | 5,118 字符 | 5 段(受 3 分钟单轮上限限制) |
| Ternary-Bonsai-2-27B PQ2_0 | 407.7 秒 | 17.2 | 5,122 字符 | 5 段 |
| Qwen3.8-27B-ABLITERATED Q8_0 | 384.5 秒 | 7.4 | 3,039 字符 | 9 段(受 3 分钟单轮上限限制) |
注意同一个 Qwen3.5-4B 出现了两次,单轮上限分别是 2,065 和 14,731 字符——差 7 倍。这不是模型变了,是任务形态不同导致的续写收口差别。本地模型的长任务方差,比云端模型大得多,规划任务时必须按分段交付来做。
同一个母题的完整诊断在 本地模型跑不完长任务,还有 连跑两天写 5 个网页游戏 那篇的五题实测。
07 · 常驻还是精确 SSD:同一份权重两种活法
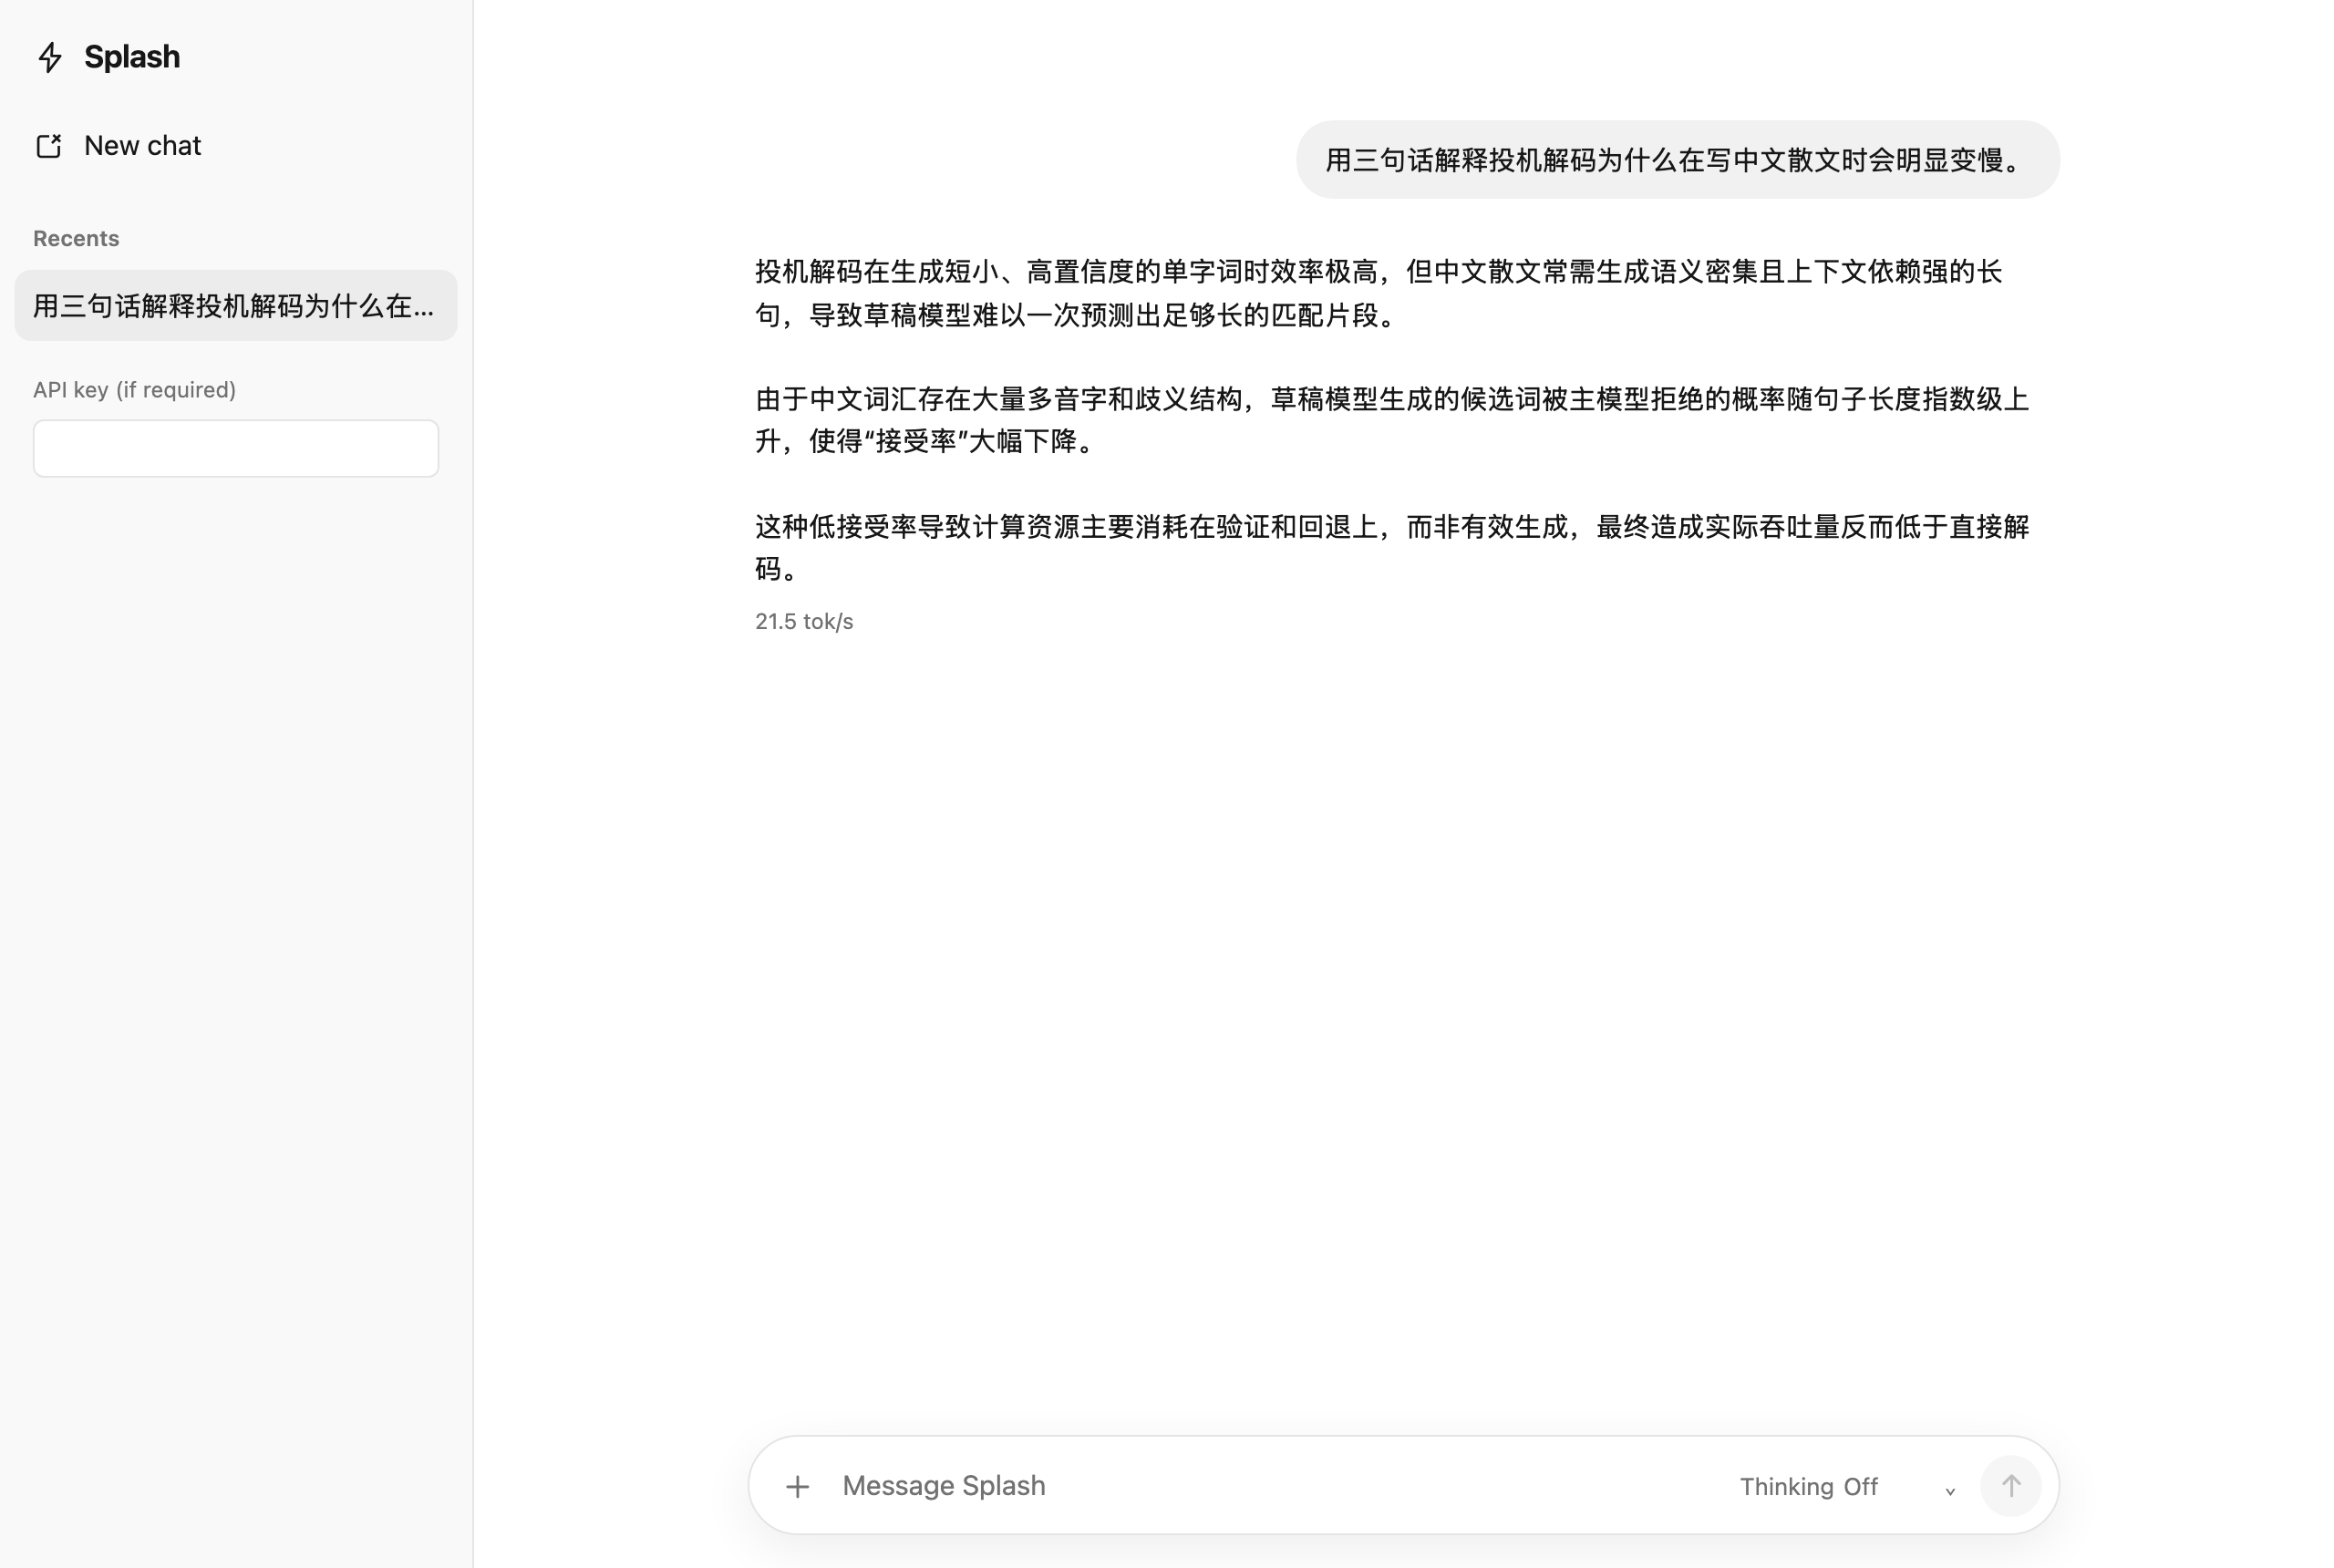
2026-10-20 的一组对照:Qwen3.8 Flash Next 2.6 位权重(79.21GB),引擎可以整份常驻在内存里,也可以只把精确需要的那 32GiB 放进 SSD 模式。
| 指标 | 完整常驻 | 32GiB 精确 SSD |
|---|---|---|
| 启动到就绪 | 40.39 秒 | 8.98 秒 |
| 引擎登记驻留 | 44.20 GiB | 31.21 GiB |
| 全机就绪后可用 | 52.39 GiB | 40.64 GiB |
| 全机 1 秒采样峰值 | 57.08 GiB | 44.59 GiB |
| 短题首字 / 总耗时 | 0.43 / 4.01 秒 | 1.39 / 5.88 秒 |
| 短题重复首字 / 总耗时 | 0.39 / 3.47 秒 | 0.40 / 3.64 秒 |
| 长材料题首字 / 总耗时 | 2.46 / 4.99 秒 | 4.90 / 8.10 秒 |
| 解码 tok/s(4 次) | 36.1 / 42.3 / 43.2 / 44.7 | 29.0 / 40.1 / 34.9 / 41.8 |
取舍很清楚:SSD 模式启动快 4.5 倍、少占 13GB 内存,代价是首次回答慢 1.8 秒左右。重复问同一段材料,两边差距缩到几乎为零——因为第二次会命中 2595 个输入缓存 token。日常用就 SSD 模式,追求秒回且内存够就常驻。
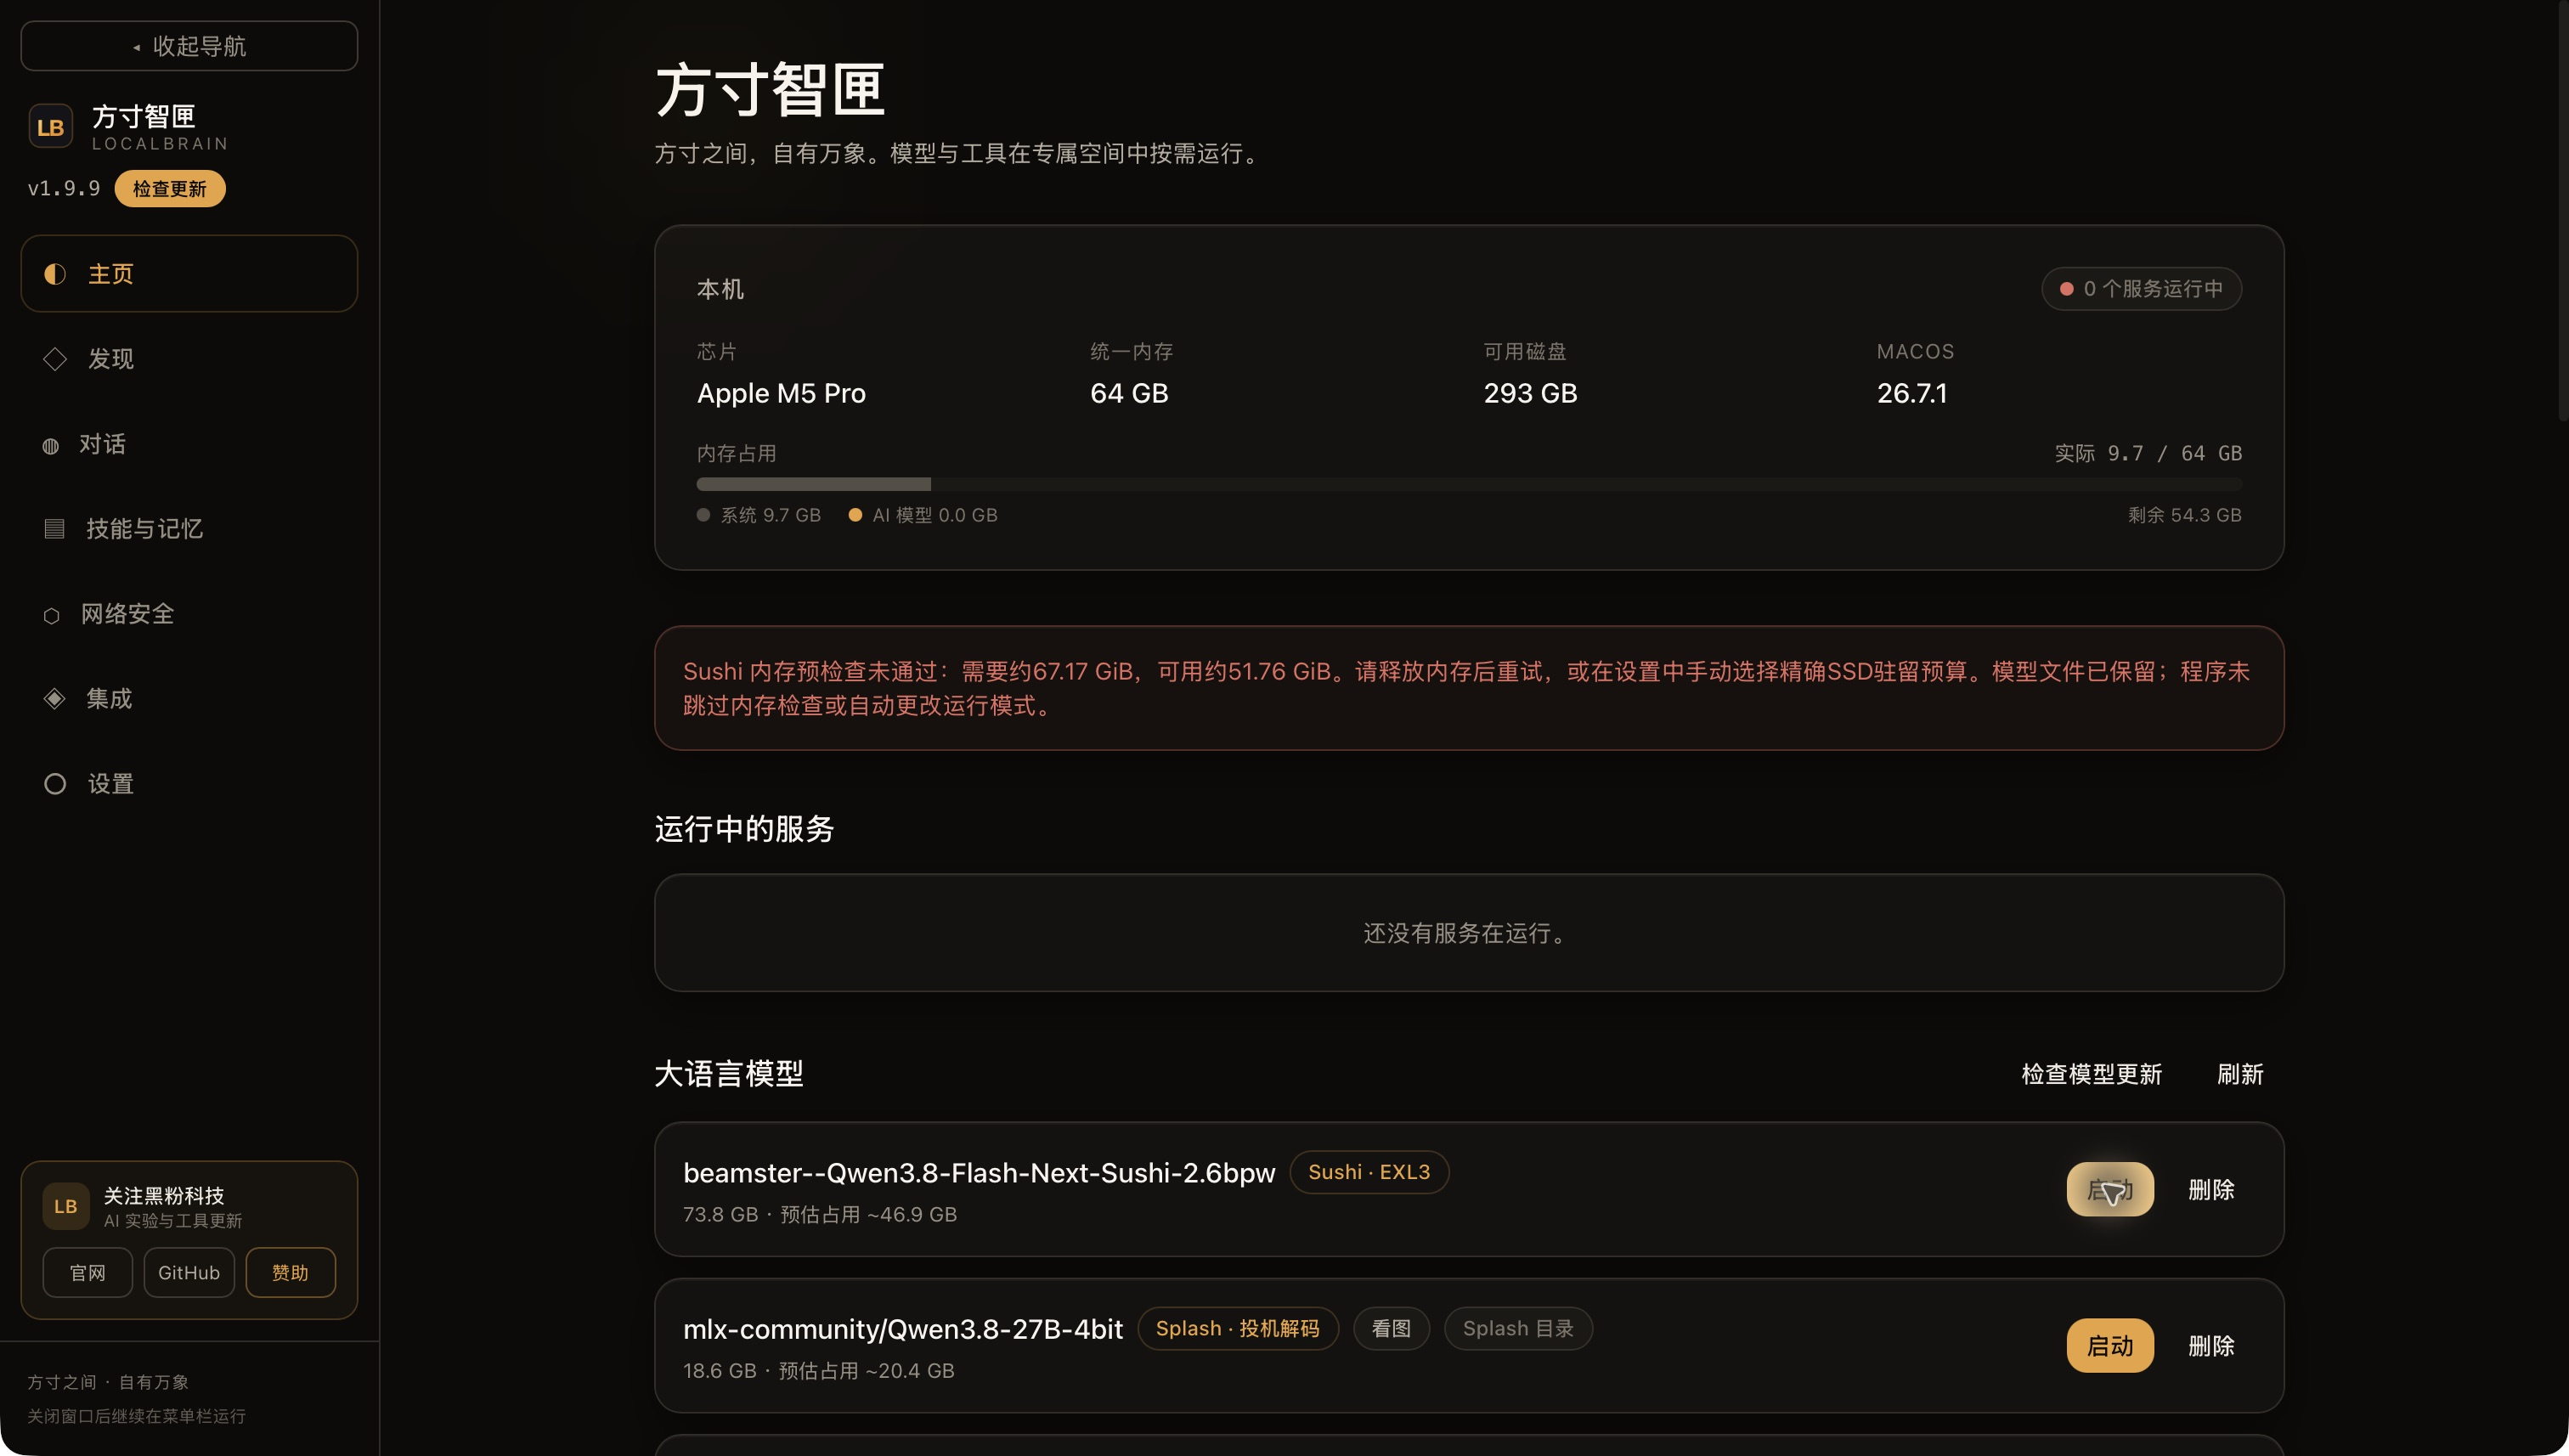
完整数据在 方寸智匣接入 Sushi。
08 · 一次失败实录:512 个 token 全部烧在思考里
2026-10-06 跑的 Qwen3.8-27B-Splash,四个场景里 A 挂了。
| 场景 | 耗时 | token 入 / 出 | 结果 |
|---|---|---|---|
| A 第 1 轮 | 10.03 秒 | 122 / 512 | 输出触顶,content 为空 |
| A 第 2 轮 | 3.06 秒 | 142 / 121 | 有内容 |
| A 第 3 轮 | 11.50 秒 | 197 / 512 | 输出触顶,content 为空 |
| B 列目录 | 4.22 秒 | 1507 / 102 | 通过 |
两轮的 finish_reason 都是 length——512 个输出 token 全部花在 reasoning 上,正文一个字没轮到。第二轮模型甚至回答"我上一条回复是空白的",因为它确实没写。
同一批跑下来,生成中位 58.2 tok/s、预填 259.1 tok/s,是相当漂亮的速度;工具场景 B/C/D 全过,D 的 verified 也是 true。快和能交付在这一组上彻底分开了。
09 · 想复现,下载这四个权重
下面四个是 2026-09-13 那批测试实际用过的文件,下载命令和仓库地址一一对应。文件名、SHA-256 和字节数来自当时的下载回执。
MiniCPM5-2B · Q4_K_M
最快的一个,1.56GB 文件,32K 窗口 133.6 tok/s,四场景全过
ec2d5801…602fdllama-server b10705hf download openbmb/MiniCPM5-2B-GGUF --include MiniCPM5-2B-Q4_K_M.gguf --local-dir /Volumes/BigDisk/AI-Models/Language-Models/GGUF/MiniCPM5-2B-GGUF下载 MiniCPM5-2B 的 GGUF 权重
2026-10-22 匿名下载复核:仓库未设访问限制,权重文件可直接拉取(HTTP 206)。
Qwen3-8B · Q4_K_M
最常用的那个,5.03GB 文件,32K 窗口 51.2 tok/s,四场景全过
120307ba…9bd4hf download unsloth/Qwen3-8B-GGUF --include Qwen3-8B-Q4_K_M.gguf --local-dir /Volumes/BigDisk/AI-Models/Language-Models/GGUF/Qwen3-8B-GGUF下载 Qwen3-8B 的 GGUF 权重
2026-10-22 匿名下载复核:仓库未设访问限制,权重文件可直接拉取(HTTP 206)。
Qwen3.5-9B · Q4_K_M
看图那组的第一名,5.68GB 文件,32K 窗口 43.1 tok/s,看图 71/71
hf download unsloth/Qwen3.5-9B-GGUF --include "Qwen3.5-9B-Q4_K_M.gguf" --include "mmproj-BF16.gguf" --local-dir /Volumes/BigDisk/AI-Models/Language-Models/GGUF/Qwen3.5-9B-GGUF下载 Qwen3.5-9B 的 GGUF 权重
2026-10-22 匿名下载复核:仓库未设访问限制,权重文件可直接拉取(HTTP 206)。
Gemma 4 12B IT · QAT Q4_0
这一档最慢但质量最稳,6.98GB 文件,32K 窗口 33.3 tok/s,四场景全过
93567e57…538bhf download google/gemma-4-12B-it-qat-q4_0-gguf --include gemma-4-12b-it-qat-q4_0.gguf --local-dir /Volumes/BigDisk/AI-Models/Language-Models/GGUF/Gemma-4-12B-it-QAT-GGUF下载 Gemma 4 12B 的 QAT GGUF 权重
2026-10-22 匿名下载复核:仓库未设访问限制,权重文件可直接拉取(HTTP 206)。
AI-Models/Language-Models/GGUF/ 和 /MLX/ 两个目录在 2026-10-21 实扫时都是空的——上面的下载命令要重新跑才能把权重放回去。真正还在册的文本模型是方寸智匣受管目录里的 Qwen3.8 Flash Next,74GB。
10 · 最后一句:速度不是交付
把上面所有数字看完,很容易得出"那我选最快的那个"。但我自己在长任务上踩过一次:同一个 Qwen3.8-27B-Splash,前一天解码中位 53.4 tok/s,长任务那轮界面显示 0.4 tok/s。
真相是服务端 58 秒就吐完了 1,900 个 token(32.9 tok/s),但流在第 51 秒静默后客户端干等了 64 分钟。模型不慢,链路和监控漏了。那次任务一共 12 组全交付,但同一题重复跑本身差了 15 倍。
所以这张表真正的用法不是"谁快选谁",而是三件事:
- 先按内存筛:合计内存超过可用内存一半就别指望跑得动,这是在我自己机器上反复撞出来的线。
- 再按场景挑速度:写代码 77 tok/s 和写中文 24 tok/s 是两台机器的体感,别用一个数字概括。
- 最后一定留人看:本轮所有"通过"都是我在旁边看着沙箱文件核对出来的。
配套的完整拆解在 本地 AI 完全拆解,那篇把内存、带宽、算力三堵墙和 11 个实测模型摊开讲;8GB 设备的选型账在 8GB 设备能跑哪些本地模型。